CH 7混ぜて最終提出する(アンサンブル)
この章の目的は、単体で最も強い XGBoost(OOF AUC 0.965067)を超える予測を作り、最終順位を決める Private Leaderboard に向けて 2 系統の提出ファイルを確定することである。アンサンブルが効くには、各モデルの単体精度が十分に高く、予測の誤り方に多様性があることが前提である。この章ではモデルの再学習をしない。第6章で保存した OOF 予測と test 予測の上で足し算・掛け算・順位付けだけを行うので、どの手法も数秒〜数分で試せる。そのぶん、過適合の検証や重みの探索にしっかり時間を使える。
7-1予測をそのまま平均する(単純平均)
次にやること
第6章で、4 つのモデルの OOF 予測と test 予測を保存した。まずそれを読み込み、最も基本的な手法である単純平均(予測確率の算術平均)を試す。
理由
最も堅実な出発点:単純平均(simple average)は調整するパラメータを持たないので、過適合のリスクが最も低い手法である。まずここを基準にする。
比較の基準は単体最強のモデル:読み込んだ予測から、各モデル単体の AUC も計算し直し、最も高いモデルを基準(auc_base)にする。S6E8 では、第6章で単体最強だった XGBoost である。以降の手法は、すべてこの基準との差で評価する。基準のモデルを名前で書かずに AUC から選ぶので、別のコンペで単体の順位が入れ替わっても、コードを書き換えずに使える。
単体性能がそろっていれば平均が効きやすい:6-6 で見たとおり、GBDT の 3 つは単体スコアが 0.9644〜0.9651 とほぼ同じで、予測に小さなずれがある。精度が同じくらいのモデル同士なら、平均で互いのずれを打ち消し合える可能性がある。一方、単体スコアが約 0.05 低い LogisticRegression を同じ重みで混ぜると、足を引っ張るはずである。それを実測で確かめる。
コード
# 必要なライブラリを用途ごとにインポートする
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import polars as pl
from scipy.optimize import minimize
from scipy.stats import rankdata
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score

# パスと定数を 1 か所で定義する
PROJECT = Path(r"D:\kaggle\smartphone-addiction_s6e8")   # データの置き場所。自分の環境に合わせて書き換える
DATA_DIR = PROJECT / "data"
PROCESSED_DIR = DATA_DIR / "processed"
RAW_DIR = DATA_DIR / "raw"
RESULTS_DIR = PROJECT / "results"
SUBMISSIONS_DIR = PROJECT / "submissions"

ID = "id"
TARGET = "addicted_label"

# グラフでのモデルの色(第6章と同じ)
MODEL_COLORS = {"lightgbm": "#55A868", "xgboost": "#4A90E2", "catboost": "#E67E22", "logistic_regression": "#8C8C8C"}

# 第6章で保存した OOF 予測値・test 予測値、および提出フォーマットを読み込む
oof_df = pl.read_parquet(PROCESSED_DIR / "oof_predictions.parquet")
test_df = pl.read_parquet(PROCESSED_DIR / "test_predictions.parquet")
sample_sub_raw = pl.read_csv(RAW_DIR / "sample_submission.csv")   # 生データ(1-1 と同じ名前の付け方)
sample_sub = sample_sub_raw.clone()                               # 7-5 で提出ファイルと比べる基準

y_true = oof_df[TARGET].to_numpy()
folds = oof_df["fold"].to_numpy()

p_lgb = oof_df["pred_lightgbm"].to_numpy()
p_xgb = oof_df["pred_xgboost"].to_numpy()
p_cat = oof_df["pred_catboost"].to_numpy()
p_lr = oof_df["pred_logistic_regression"].to_numpy()

t_lgb = test_df["pred_lightgbm"].to_numpy()
t_xgb = test_df["pred_xgboost"].to_numpy()
t_cat = test_df["pred_catboost"].to_numpy()
t_lr = test_df["pred_logistic_regression"].to_numpy()

# 単体モデルのスコア確認
auc_lgb = roc_auc_score(y_true, p_lgb)
auc_xgb = roc_auc_score(y_true, p_xgb)
auc_cat = roc_auc_score(y_true, p_cat)
auc_lr = roc_auc_score(y_true, p_lr)

# 単体で最も高いモデルを基準にする(S6E8 では XGBoost)。名前は 7-5 の表の method とそろえる
single_aucs = {"Single LightGBM": auc_lgb, "Single XGBoost": auc_xgb,
               "Single CatBoost": auc_cat, "Single LogisticRegression": auc_lr}
BEST_SINGLE = max(single_aucs, key=lambda k: single_aucs[k])
auc_base = single_aucs[BEST_SINGLE]

# 単純平均の評価
p_avg_2 = (p_lgb + p_xgb) / 2
auc_avg_2 = roc_auc_score(y_true, p_avg_2)
p_avg_3 = (p_lgb + p_xgb + p_cat) / 3
auc_avg_3 = roc_auc_score(y_true, p_avg_3)
p_avg_4 = (p_lgb + p_xgb + p_cat + p_lr) / 4
auc_avg_4 = roc_auc_score(y_true, p_avg_4)
print(f"基準 ({BEST_SINGLE}):      {auc_base:.6f}")
print(f"単純平均 (LGB + XGB):       {auc_avg_2:.6f} (差分: {auc_avg_2 - auc_base:+.6f})")
print(f"単純平均 (LGB + XGB + CAT): {auc_avg_3:.6f} (差分: {auc_avg_3 - auc_base:+.6f})")
print(f"単純平均 (4 モデル): {auc_avg_4:.6f} (差分: {auc_avg_4 - auc_base:+.6f})")pl.read_parquet(path) | 第6章で保存した OOF 予測・test 予測を読み込む |
|---|---|
max(d, key=d.get) | 辞書の値(AUC)が最も大きいキー(モデルの名前)を返す |
(p1 + p2) / 2 | 2 つのモデルの予測確率を均等に足し合わせる |
roc_auc_score(y_true, p_blend) | アンサンブル後の OOF AUC を評価する |
結果
基準 (Single XGBoost):      0.965067
単純平均 (LGB + XGB):       0.965290 (差分: +0.000222)
単純平均 (LGB + XGB + CAT): 0.965352 (差分: +0.000285)
単純平均 (4 モデル):        0.962759 (差分: -0.002308)
XGBoost 単体(0.965067)に対し、LGB + XGB の単純平均は 0.965290(+0.000222)、CatBoost も加えた 3 つの平均は 0.965352(+0.000285)で、どちらも単体を上回った。差はどちらもノイズフロア 0.000163 と採択の閾値 +0.000200 を超えている。単体では XGBoost に負けていた LightGBM と CatBoost も、混ぜると上積みに貢献している。
一方、LogisticRegression まで加えた 4 つの平均は 0.962759(-0.002308)で、大きく下がった。単体性能の差が大きいモデルを同じ重みで混ぜると、弱いモデルに引っ張られる。「モデルを混ぜれば必ず上がる」とは限らない。
次の 7-2 では、確率を順位に変えてから平均する「順位平均」で結果が変わるかを確かめる。
7-2順位に変えてから平均する(順位平均)
次にやること
前の節で、GBDT どうしの単純平均が XGBoost 単体を上回った。次は、各モデルの予測確率を順位(パーセンタイル順位)に変換してから平均する「順位平均」(Rank Average)を試す。
理由
単一モデルなら AUC は変わらない:ROC-AUC は正例と負例の相対的な順序だけで決まる指標である。そのため、単一モデルの予測を順位に変えても ROC-AUC は変わらない。
複数モデルでは分布の違いをそろえる:複数のモデルを混ぜるときは、モデルごとに予測確率の分布の偏り(キャリブレーションの差)がある。順位にするとこの差がなくなり、純粋に順位どうしの平均になる。確率のスケールの違いが単純平均に影響していたのかを、これで確かめる。
コード
n_records = len(y_true)
r_lgb = rankdata(p_lgb) / n_records
r_xgb = rankdata(p_xgb) / n_records
r_cat = rankdata(p_cat) / n_records
p_rank_2 = (r_lgb + r_xgb) / 2
auc_rank_2 = roc_auc_score(y_true, p_rank_2)
p_rank_3 = (r_lgb + r_xgb + r_cat) / 3
auc_rank_3 = roc_auc_score(y_true, p_rank_3)
print(f"順位平均 (LGB + XGB):       {auc_rank_2:.6f} (差分: {auc_rank_2 - auc_base:+.6f})")
print(f"順位平均 (LGB + XGB + CAT): {auc_rank_3:.6f} (差分: {auc_rank_3 - auc_base:+.6f})")rankdata(p) / len(p) | 予測値を [0, 1] のパーセンタイル順位に正規化する |
|---|
結果
順位平均 (LGB + XGB):       0.965290 (差分: +0.000223)
順位平均 (LGB + XGB + CAT): 0.965350 (差分: +0.000282)
順位平均は、LGB + XGB で 0.965290、3 つで 0.965350 で、単純平均(0.965290、0.965352)とほぼ同じであった。3 つの GBDT は同じ目的関数(logloss)で学習していて、予測確率の分布もそろっていると考えられ、順位にしても結果はほとんど変わらなかった。このデータでは確率のまま平均して問題ない。
次の 7-3 では、同じ重みで混ぜるのをやめ、各モデルの重みを最適化する。
7-3重みを最適化する(加重平均)
次にやること
前の 2 節で、GBDT の 3 つを同じ重みで混ぜると XGBoost 単体を上回ると分かった。次は、LightGBM・XGBoost・CatBoost の重み wᵢ を scipy.optimize.minimize(Nelder-Mead 法)で最適化し、加重平均(weighted average)を作る。あわせて、その重みが信用できるかを 2 つの方法で確かめ、Fold ごとの重みを積み上げ棒グラフで並べる。
理由
-AUC を最小化する:minimize は値を小さくする方向に探索するので、目的関数を -ROC-AUC にする。重みは合計が 1 になるように正規化してから混ぜる。
重みの過適合を検証する:全 OOF 予測を一度に使って最適化した重みは、その OOF 予測のノイズに合わせすぎている(リークしている)おそれがある。そこで 2 通りで計算する。1 つは全 OOF で一括最適化する方法、もう 1 つは 5-Fold を回し、4 Fold で重みを最適化して残り 1 Fold で評価する「Leak-Free 重み最適化」である。2 つの差が小さければ、重みの過適合は気にしなくてよいと判断できる。
Fold ごとの重みを並べる:Leak-Free では 5 組の重みができる。5 組を並べて、すべての Fold で同じ符号・近い値になっているかを見る。Fold によって符号が変わるなら、その重みは OOF のノイズに合わせたものである。
負の重みに注意する:制約なしで探すと、重みが負になることがある。負の重みは「あるモデルの予測を引き算する」ことで、その引き算が効くのは、モデル間の誤差の関係が test でも同じときだけである。そこで非負の制約(0 以上 1 以下)を付けた重みでもスコアを出し、制約なしとの差を見る。差がノイズフロアより小さければ、負の重みを使う理由はない。
コード
candidate_preds = [p_lgb, p_xgb, p_cat]

def loss_func(weights: np.ndarray, preds: list[np.ndarray], y: np.ndarray) -> float:
    w = np.array(weights)
    w = w / np.sum(w)
    mixed = sum(w[i] * preds[i] for i in range(len(preds)))
    return -roc_auc_score(y, mixed)

def optimize_weights(preds: list[np.ndarray], y: np.ndarray,
                     bounds: list[tuple[float, float]] | None = None, maxiter: int = 200) -> np.ndarray:
    """-AUC を最小にする重みを探し、合計 1 に正規化して返す。bounds で範囲を制限できる。"""
    res = minimize(loss_func, [0.5, 0.3, 0.2], args=(preds, y), method="Nelder-Mead",
                   bounds=bounds, options={"maxiter": maxiter})
    return res.x / np.sum(res.x)

def blend(w: np.ndarray, preds: list[np.ndarray]) -> np.ndarray:
    return sum(w[i] * preds[i] for i in range(len(preds)))

def leak_free(bounds: list[tuple[float, float]] | None = None):
    """4 Fold で重みを決め、残り 1 Fold に当てはめる。OOF AUC と Fold ごとの重みを返す。"""
    oof = np.zeros(len(y_true))
    weights = []
    for f in range(5):
        tr, va = folds != f, folds == f
        w = optimize_weights([p[tr] for p in candidate_preds], y_true[tr], bounds, maxiter=100)
        weights.append(w)
        oof[va] = blend(w, [p[va] for p in candidate_preds])
    return roc_auc_score(y_true, oof), np.array(weights)

BOUNDS = [(0.0, 1.0)] * 3   # 非負の制約

# 1. 制約なし: 全 OOF で一括 / Leak-Free
w_full = optimize_weights(candidate_preds, y_true)
auc_opt_full = roc_auc_score(y_true, blend(w_full, candidate_preds))
auc_opt_cv, cv_weights = leak_free()
mean_weights = cv_weights.mean(axis=0)

# 2. 非負の制約つき: Leak-Free
auc_nn_cv, cv_weights_nn = leak_free(BOUNDS)
mean_weights_nn = cv_weights_nn.mean(axis=0)

print(f"全 OOF 最適化:     重み={w_full.round(4)}, AUC={auc_opt_full:.6f} (差分: {auc_opt_full - auc_base:+.6f})")
print(f"Leak-Free CV:      重み={mean_weights.round(4)}, AUC={auc_opt_cv:.6f} (差分: {auc_opt_cv - auc_base:+.6f})")
print(f"非負 Leak-Free CV: 重み={mean_weights_nn.round(4)}, AUC={auc_nn_cv:.6f} (差分: {auc_nn_cv - auc_base:+.6f})")
print("Fold ごとの重み (制約なし) [LGB, XGB, CAT]:")
for f, w in enumerate(cv_weights):
    print(f"  fold{f}: {w.round(4)}")
signs_stable = bool((np.sign(cv_weights) == np.sign(cv_weights[0])).all())
print(f"全 Fold で符号が同じ: {signs_stable}")
次に、Leak-Free の 5 組の重みと、その平均を積み上げ棒で並べる。
_rows = np.vstack([cv_weights, mean_weights])   # 5 Fold ぶんの重み + 平均(test に使う重み)
_labels = [f"fold{_i}" for _i in range(5)] + ["mean"]

_fig, _ax = plt.subplots(figsize=(8, 3.6))
_left = np.zeros(len(_rows))
for _j, _n in enumerate(["lightgbm", "xgboost", "catboost"]):
    _bars = _ax.barh(_labels, _rows[:, _j], left=_left, color=MODEL_COLORS[_n], alpha=0.85, edgecolor="black", label=_n)
    _ax.bar_label(_bars, labels=[f"{_w:.3f}" for _w in _rows[:, _j]], label_type="center", color="white", fontsize=8)
    _left += _rows[:, _j]
_ax.set_ylim(len(_labels) - 0.5, -0.5)   # 上から fold0 の順に並べる
_ax.set_xlabel("leak-free weight (sum = 1)")
_ax.legend(loc="lower center", bbox_to_anchor=(0.5, 1.0), ncol=3, frameon=False)
_fig.tight_layout()
_figminimize(loss, init_w, method="Nelder-Mead", bounds=...) | 目的関数(-AUC)を最小化する重みベクトルを探索する。bounds で各重みの範囲を制限できる |
|---|---|
np.array(weights).mean(axis=0) | 5 つの Fold で得た重みを平均し、test に使う重みにする |
np.sign(a) | 各要素の符号(1・0・-1)を返す。Fold 間で符号がそろっているかを調べる |
np.vstack([a, b]) | 行列 a の下に行 b を積む。5 Fold の重みの下に平均の重みを足す |
ax.barh(..., left=_left) | 前のモデルの重みの右端から棒を描き、3 つの重みを横に積み上げる |
ax.bar_label(bars, label_type="center") | 棒の真ん中に値を書く |
結果
全 OOF 最適化:     重み=[0.2788 0.4915 0.2297], AUC=0.965389 (差分: +0.000321)
Leak-Free CV:      重み=[0.2779 0.4947 0.2274], AUC=0.965386 (差分: +0.000319)
非負 Leak-Free CV: 重み=[0.2779 0.4947 0.2274], AUC=0.965386 (差分: +0.000319)
Fold ごとの重み (制約なし) [LGB, XGB, CAT]:
  fold0: [0.296  0.4858 0.2182]
  fold1: [0.2608 0.4935 0.2456]
  fold2: [0.2746 0.5097 0.2157]
  fold3: [0.2725 0.4994 0.228 ]
  fold4: [0.2855 0.4853 0.2292]
全 Fold で符号が同じ: True
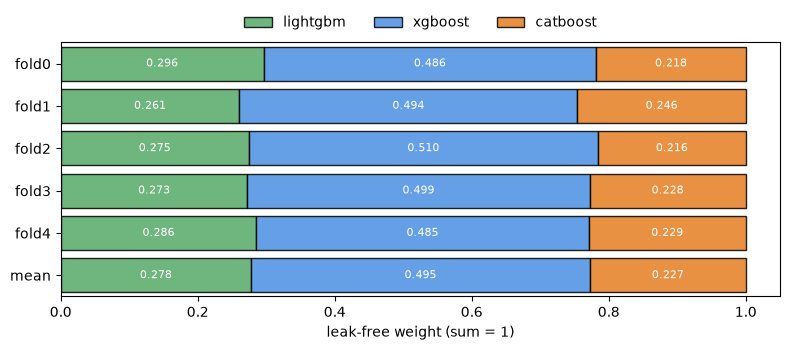
- このグラフを使う理由
- 3 つの重みは合計が 1 なので、1 本の棒を 3 つに分ける積み上げ横棒が向いている。5 つの Fold と平均を並べると、重みが Fold によってぶれていないかが、区切りの位置で一目で分かる。
- 何を見るか
- 区切りの位置が Fold ごとにほぼそろっているか。大きくずれる Fold があれば、重みはその Fold のデータに合わせすぎている疑いがある。
- 見方
- 1 本の横棒が 1 つの Fold で、最下段の mean が test に使う平均の重み。緑が LightGBM、青が XGBoost、オレンジが CatBoost の重みで、棒の中の数字が重みである。
全 OOF 一括最適化は AUC = 0.965389、Leak-Free CV 最適化は AUC = 0.965386 で、どちらも XGBoost 単体を +0.00032 上回り、この章で最も高いスコアになった。2 つの差は 0.000003 で、ノイズフロア 0.000163 よりずっと小さい値である。調整するパラメータが 3 つしかないため、重みそのものの過適合は無視できる程度である。
重みは信用できる:平均の重みは LightGBM 0.28・XGBoost 0.49・CatBoost 0.23 で、すべて正であった。Fold ごとの重みも 5 組すべて同じ符号で、XGBoost は 0.4853〜0.5097、LightGBM は 0.2608〜0.2960、CatBoost は 0.2157〜0.2456 と狭い範囲に収まっている。非負の制約を付けても重みもスコアも変わらないので、負の重みの心配もない。単体で最も強い XGBoost に約半分、残りを LightGBM と CatBoost で分ける、素直な重みである。
図 7.1 の積み上げ棒で見ると、5 つの Fold の棒は区切りの位置がほとんど同じで、どの Fold でも青(XGBoost)が真ん中の約半分を占める。Fold が変わっても重みの配分がほとんど変わらないことが、表の数字より一目で分かる。最下段の mean が、test に使う重みである。
ただし、3 つの単純平均(7-1、0.965352)との差は +0.000034 で、ノイズフロアより小さい値である。重みを最適化しても、単純平均からの上積みは誤差の範囲であった。
次の 7-4 では、重みを手で探すかわりに、2 段目のモデルに重みを学習させるスタッキングを試す。
7-42 段目のモデルで混ぜ方を学ぶ(スタッキング)
次にやること
前の節で、重み最適化により XGBoost 単体を超えた。次は、4 つのモデルの OOF 予測を特徴量(メタ特徴量)とし、2 段目のモデル(メタモデル)に組み合わせ方を学習させる。
理由
組み合わせ方をモデルに学ばせる:スタッキングでは、各モデルの予測確率を入力にして 2 段目のモデルを学習する。モデル数が多いときや、より複雑な組み合わせを捉えたいときに役立つ。
2 段目は LogisticRegression:2 段目には、解釈しやすく過学習しにくい LogisticRegression を使う。各モデルの確率に対する回帰係数が、そのまま重みの役割をする。単純ブレンドから外した LogisticRegression の予測も、ここではメタ特徴量(meta-feature)として入れる。
2 段目も 5-Fold で回す:2 段目の学習と評価も同じ folds で分ける。同じデータで学習と評価をすると、スコアが高く出すぎるからである。test 予測は 5 つのメタモデルの平均にする。
コード
# スタッキング (2段目: LogisticRegression)
X_oof_meta = np.column_stack([p_lgb, p_xgb, p_cat, p_lr])
X_test_meta = np.column_stack([t_lgb, t_xgb, t_cat, t_lr])

stack_oof = np.zeros(len(y_true))
stack_test = np.zeros(len(t_lgb))

for f_idx in range(5):
    tr_idx = np.where(folds != f_idx)[0]
    va_idx = np.where(folds == f_idx)[0]

    meta_clf = LogisticRegression(random_state=42)
    meta_clf.fit(X_oof_meta[tr_idx], y_true[tr_idx])

    stack_oof[va_idx] = meta_clf.predict_proba(X_oof_meta[va_idx])[:, 1]
    stack_test += meta_clf.predict_proba(X_test_meta)[:, 1] / 5

auc_stack = roc_auc_score(y_true, stack_oof)
print(f"スタッキング (LogisticRegression) OOF AUC: {auc_stack:.6f} (差分: {auc_stack - auc_base:+.6f})")np.column_stack([p1, p2, ...]) | 各モデルの予測を列として並べ、メタ特徴量の行列にする |
|---|---|
LogisticRegression() | 各モデルの予測確率を入力として最適な結合重みを学習する |
結果
スタッキング (LogisticRegression) OOF AUC: 0.965038 (差分: -0.000029)
スタッキングの OOF AUC は 0.965038(-0.000029)で、XGBoost 単体とほぼ同じであった。7-1 の単純平均(0.965352)にも、7-3 の Leak-Free 重み最適化(0.965386)にも届いていない。予測確率をそのまま入力にした線形のメタモデルでは、GBDT どうしの小さなずれをうまく使えなかったと考えられる。このコンペでは、単純な平均・重み付けのほうが良い結果になった。
次の 7-5 では、ここまでの結果から最終提出の 2 本を選び、提出ファイルを作って検証する。
7-5最終提出を 2 本作る
次にやること
前の節までで、アンサンブルの手法をひととおり比べた。次は、性質の違う 2 本の最終提出(Conservative と Aggressive)を作り、3-7 で決めた検証ルールでチェックしてから保存する。最後に、全手法のスコアと、提出 2 本の予測の違いをグラフで確かめる。
理由
Shake に備える:Kaggle の最終順位は、コンペ中に見えている Public Leaderboard ではなく、隠された Private Leaderboard で決まる。コンペ終了後に順位が大きく動く「Shake」はよく起こる。
似た 2 本を選ばない:最終提出を 2 本選べるとき、避けるべきは、似たモデルを 2 本選ぶことである。できるだけリスクの性質が違う 2 本にする。
Conservative(手堅い提出):最良の単一モデル XGBoost(OOF AUC 0.965067)である。混ぜ方の選択が入らないので、最も単純である。
Aggressive(攻めの提出):CV 重み最適化ブレンド(OOF AUC 0.965386)である。3 つの単純平均との差(+0.000034)は誤差の範囲であるが、重みは 5 Fold で安定していて、Leak-Free で測っても単純平均より下がらないので、攻めの 1 本にはこちらを採る。test には 7-3 の Fold 平均の重み mean_weights を使う。7-3 で重みはすべて正と分かったので、予測は 0〜1 に収まるはずであるが、安全のため np.clip で [0, 1] に収める。
提出前に機械的に検証する:どれだけスコアの高いモデルでも、提出ファイルの形式(行数・ID・列名・NaN・値域)に不備があればエラーになる。3-7 の check_submission を提出前に必ず通し、通ったものだけを保存する。第7章は別のノートブックなので、関数はこの節でもう一度定義する。
XGBoost の予測も clip する:XGBoost の predict_proba は 32 ビットの浮動小数点数(float32)で値を返す。これを Fold 数で割って足し合わせると、丸め誤差で 1 をごくわずかに超える行が出る。たとえば予測が float32 の 1.0 の行は、5 で割った時点で float32 の 0.2(正確には 0.200000003)になり、5 Fold ぶん足すと 1.0000000149 になる(下の出力の最大値と同じ)。6-5 で predict_proba の結果を .astype(np.float64) にしてから割れば、この誤差はそもそも出ない。実際に clip せずに 3-7 のチェックを通すと値域のチェック(「確率が範囲外です」)で止まったので、Conservative にも np.clip をかける。
全手法の比較表も残す:この章で試した全手法の OOF AUC を 1 つの表にまとめて保存すると、あとから判断の根拠を見返せる。
提出する手法は名前で選ぶ:比較表の 1 行ごとに、その手法の test 予測も並べる。最終提出の 2 本は、表の method の名前で選ぶ。手堅いほう(CONSERVATIVE_CHOICE)は、7-1 で AUC から選んだ単体最強のモデル BEST_SINGLE をそのまま使うので、別のコンペで単体の順位が変わっても自動で入れ替わる。攻めのほう(AGGRESSIVE_CHOICE)は、表を見て採る手法の名前を書く。別のコンペで書き換えるのは、この 1 行だけである。表で見た名前と提出の中身が必ず対応するので、「表では A を選んだのに、提出は B の予測だった」という取り違えも起きない。
全手法を 1 枚に並べて選ぶ:比較表の差(diff_vs_best_single)を横棒にし、ノイズフロアの帯を重ねる。帯の外まで右に伸びた手法だけが、単体最強を本当に上回ったと言える。選んだ 2 本には印を付ける。LogisticRegression を含む 2 行は差が大きすぎて、ほかの手法の差が見えなくなるので、グラフからは除く(表には残る)。
提出 2 本の違いを見る:2 本の予測の分布を重ね、さらに 2 本の差(Aggressive − Conservative)のヒストグラムを描く。相関 0.9994 という数字が、行ごとにどれくらいの違いなのかが分かる。
コード
# 手法ごとに (名前, OOF AUC, 種類, test 予測) を 1 行にまとめる
def to_rank(p: np.ndarray) -> np.ndarray:
    """7-2 と同じく、予測を 0〜1 の順位にする"""
    return rankdata(p) / len(p)

t_gbdt = [t_lgb, t_xgb, t_cat]
methods = [
    ("Single LightGBM", auc_lgb, "Single", t_lgb),
    ("Single XGBoost", auc_xgb, "Single", t_xgb),
    ("Single CatBoost", auc_cat, "Single", t_cat),
    ("Single LogisticRegression", auc_lr, "Single", t_lr),
    ("Simple Average (LGB + XGB)", auc_avg_2, "Average", (t_lgb + t_xgb) / 2),
    ("Simple Average (LGB + XGB + CAT)", auc_avg_3, "Average", (t_lgb + t_xgb + t_cat) / 3),
    ("Simple Average (4 models)", auc_avg_4, "Average", (t_lgb + t_xgb + t_cat + t_lr) / 4),
    ("Rank Average (LGB + XGB)", auc_rank_2, "Rank", (to_rank(t_lgb) + to_rank(t_xgb)) / 2),
    ("Rank Average (LGB + XGB + CAT)", auc_rank_3, "Rank", sum(to_rank(t) for t in t_gbdt) / 3),
    ("Weight Optimization (Full OOF)", auc_opt_full, "Weighted", blend(w_full, t_gbdt)),
    ("Weight Optimization (CV-LeakFree)", auc_opt_cv, "Weighted", blend(mean_weights, t_gbdt)),
    ("Weight Optimization (CV-LeakFree, non-negative)", auc_nn_cv, "Weighted", blend(mean_weights_nn, t_gbdt)),
    ("Stacking (LogisticRegression)", auc_stack, "Stacking", stack_test),
]
comp_summary_df = pd.DataFrame(
    [{"method": m, "oof_auc": round(a, 6), "diff_vs_best_single": round(a - auc_base, 6), "category": c} for m, a, c, _ in methods]
)
comp_summary_df.to_csv(RESULTS_DIR / "07_ensemble_comparison.csv", index=False)
print(comp_summary_df.to_string(index=False))
test_by_method = {m: t for m, _, _, t in methods}

# 最終提出の 2 本を、上の表の method の名前で選ぶ
CONSERVATIVE_CHOICE = BEST_SINGLE                          # 手堅い: 単体最強のモデル(7-1 で選んだもの)
AGGRESSIVE_CHOICE = "Weight Optimization (CV-LeakFree)"    # 攻め: Leak-Free で測った最も高いブレンド
print(f"Conservative: {CONSERVATIVE_CHOICE} / Aggressive: {AGGRESSIVE_CHOICE}")

# 1. Conservative 提出
print(f"XGBoost の test 予測で 1 を超える行: {(t_xgb > 1.0).sum()} (最大 {t_xgb.max():.10f})")
t_conservative = np.clip(test_by_method[CONSERVATIVE_CHOICE], 0.0, 1.0)
sub_cons = pl.DataFrame({ID: test_df[ID], TARGET: t_conservative})

# 2. Aggressive 提出
t_aggressive = np.clip(test_by_method[AGGRESSIVE_CHOICE], 0.0, 1.0)
sub_agg = pl.DataFrame({ID: test_df[ID], TARGET: t_aggressive})

# 3-7 と同じチェック (この章は別のノートブックなので、関数をもう一度定義する)
def check_submission(sub: pl.DataFrame, sample: pl.DataFrame) -> None:
    """提出ファイルを sample_submission と比べる。おかしければ AssertionError で止める。"""
    assert sub.height == sample.height, f"行数不一致: {sub.height} != {sample.height}"
    assert sub.columns == sample.columns, f"列名不一致: {sub.columns}"
    assert sub[ID].equals(sample[ID]), "ID の順序が sample と一致しません"
    assert sub[TARGET].null_count() == 0, "欠損 (null) があります"
    assert not sub[TARGET].is_nan().any(), "NaN があります"
    assert sub[TARGET].is_between(0.0, 1.0).all(), "確率が範囲外です"

# チェックを通ったものだけを保存する
cons_file = SUBMISSIONS_DIR / "07_submission_conservative.csv"
agg_file = SUBMISSIONS_DIR / "07_submission_aggressive.csv"
for name, df_sub, path in [("Conservative", sub_cons, cons_file), ("Aggressive", sub_agg, agg_file)]:
    check_submission(df_sub, sample_sub)
    df_sub.write_csv(path)
    print(f"[PASS] {name} 提出ファイル検証完了: {df_sub.shape}")

print("test 予測の相関 (Conservative vs Aggressive):", round(float(np.corrcoef(t_conservative, t_aggressive)[0, 1]), 4))
print(f"Saved Conservative submission: {cons_file} (shape: {sub_cons.shape})")
print(f"Saved Aggressive submission: {agg_file} (shape: {sub_agg.shape})")
次に、比較表の差を横棒にする。単体のモデルは第6章と同じ色、混ぜ方は種類ごとの色にする。
NOISE_FLOOR = 0.000163   # 3-5 で測ったノイズフロア
_single_key = {"Single LightGBM": "lightgbm", "Single XGBoost": "xgboost",
               "Single CatBoost": "catboost", "Single LogisticRegression": "logistic_regression"}
# 混ぜ方の種類ごとの色(次のセルでも使うので、_ を付けない名前にする)
BLEND_COLORS = {"Average": "#8172B2", "Rank": "#CCB974", "Weighted": "#E74C3C", "Stacking": "#64B5CD"}
_tags = {CONSERVATIVE_CHOICE: "  [Conservative]", AGGRESSIVE_CHOICE: "  [Aggressive]"}

# LogisticRegression を含む 2 行は差が大きすぎるので、グラフからは除く
_df = comp_summary_df[~comp_summary_df["method"].isin(["Single LogisticRegression", "Simple Average (4 models)"])]
_yy = np.arange(len(_df))
_colors = [MODEL_COLORS[_single_key[_m]] if _c == "Single" else BLEND_COLORS[_c]
           for _m, _c in zip(_df["method"], _df["category"])]

_fig, _ax = plt.subplots(figsize=(10, 5.2))
_bars = _ax.barh(_yy, _df["diff_vs_best_single"], color=_colors, alpha=0.85, edgecolor="black")
_ax.bar_label(_bars, fmt="%+.6f", padding=3, fontsize=8)
_ax.axvspan(-NOISE_FLOOR, NOISE_FLOOR, color="gray", alpha=0.15, zorder=0, label=f"noise floor ±{NOISE_FLOOR:.6f}")
_ax.axvline(0, color="black", linewidth=0.8)
_ax.set_yticks(_yy, [_m + _tags.get(_m, "") for _m in _df["method"]])
_ax.set_ylim(len(_df) - 0.5, -0.5)   # 表と同じ順に、上から並べる
_ax.set_xlim(_df["diff_vs_best_single"].min() * 1.5, _df["diff_vs_best_single"].max() * 1.5)
_ax.set_xlabel(f"ΔAUC vs {BEST_SINGLE} (OOF)")
_ax.legend(loc="lower left", fontsize=8)
_ax.grid(axis="x", linestyle=":", alpha=0.6)
_fig.tight_layout()
_fig
最後に、提出 2 本の test 予測の分布と、2 本の差の分布を描く。
_diff = t_aggressive - t_conservative

_fig, (_ax1, _ax2) = plt.subplots(1, 2, figsize=(12, 4))
_bins = np.linspace(0, 1, 51)
_ax1.hist(t_conservative, bins=_bins, alpha=0.35, color=MODEL_COLORS["xgboost"], label="Conservative")
_ax1.hist(t_aggressive, bins=_bins, alpha=0.35, color=BLEND_COLORS["Weighted"], label="Aggressive")
_ax1.set_xlabel("test prediction")
_ax1.set_title("test predictions of the 2 submissions", fontweight="bold")
_ax1.legend(loc="upper left")
_ax1.grid(True, linestyle=":", alpha=0.5)
_ax2.hist(_diff, bins=101, color="#555555")
_ax2.set_yscale("log")   # 差の大きい行は少ないので、件数は対数で見る
_ax2.set_xlabel("Aggressive − Conservative")
_ax2.set_title(f"difference by row (|diff| < 0.01: {(np.abs(_diff) < 0.01).mean():.1%})", fontweight="bold")
_ax2.grid(True, linestyle=":", alpha=0.5)
_fig.tight_layout()
_fig07_submission_conservative.csv | 単体最強の XGBoost による手堅い提出ファイル |
|---|---|
07_submission_aggressive.csv | CV 重み最適化ブレンドによる攻めの提出ファイル |
07_ensemble_comparison.csv | 全アンサンブル手法の OOF AUC 比較サマリー |
{m: t for m, _, _, t in methods} | 手法の名前から test 予測を引ける辞書を作る |
|---|---|
blend(w, preds) / to_rank(p) | 7-3 の重み付きの和 / 7-2 と同じ順位への変換。OOF に使った変換を test 予測にも同じようにかける |
np.clip(x, 0.0, 1.0) | 丸め誤差や負の重みで範囲を外れた予測を [0, 1] に収める |
check_submission(sub, sample) | 3-7 と同じ提出前チェック。行数・列名・ID の順序・欠損・NaN・値域のどれかがおかしければ止める |
np.corrcoef(a, b)[0, 1] | 2 本の提出の予測がどれくらい似ているかを測る |
df[~df["method"].isin([...])] | 名前が一覧に入っていない行だけを残す(~ は「でない」) |
d.get(key, "") | 辞書にあればその値、なければ空の文字列を返す。選んだ 2 本の名前にだけ印を付ける |
ax.set_yscale("log") | 縦軸を対数にする。件数の少ない区間も見えるようにする |
結果
                                         method  oof_auc  diff_vs_best_single category
                                Single LightGBM 0.964792            -0.000276   Single
                                 Single XGBoost 0.965067             0.000000   Single
                                Single CatBoost 0.964382            -0.000686   Single
                      Single LogisticRegression 0.914775            -0.050292   Single
                     Simple Average (LGB + XGB) 0.965290             0.000222  Average
               Simple Average (LGB + XGB + CAT) 0.965352             0.000285  Average
                      Simple Average (4 models) 0.962759            -0.002308  Average
                       Rank Average (LGB + XGB) 0.965290             0.000223     Rank
                 Rank Average (LGB + XGB + CAT) 0.965350             0.000282     Rank
                 Weight Optimization (Full OOF) 0.965389             0.000321 Weighted
              Weight Optimization (CV-LeakFree) 0.965386             0.000319 Weighted
Weight Optimization (CV-LeakFree, non-negative) 0.965386             0.000319 Weighted
                  Stacking (LogisticRegression) 0.965038            -0.000029 Stacking
Conservative: Single XGBoost / Aggressive: Weight Optimization (CV-LeakFree)
XGBoost の test 予測で 1 を超える行: 177 (最大 1.0000000149)
[PASS] Conservative 提出ファイル検証完了: (296302, 2)
[PASS] Aggressive 提出ファイル検証完了: (296302, 2)
test 予測の相関 (Conservative vs Aggressive): 0.9994
Saved Conservative submission: D:\kaggle\smartphone-addiction_s6e8\submissions\07_submission_conservative.csv (shape: (296302, 2))
Saved Aggressive submission: D:\kaggle\smartphone-addiction_s6e8\submissions\07_submission_aggressive.csv (shape: (296302, 2))
比較表の名前で、Conservative に Single XGBoost、Aggressive に Weight Optimization (CV-LeakFree) を選んだ。XGBoost の test 予測は、177 行が 1.0000000149 と、1 をごくわずかに超えていた。clip したので、2 本とも 296,302 行 × 2 列(id と addicted_label)で、check_submission のチェックをすべて通った。
2 本の test 予測の相関は 0.9994 である。単体の XGBoost と、XGBoost に約半分の重みを置いたブレンドなので、予測はかなり似ている。3 つの GBDT がどれも同じくらい強く、どれも深さ 3〜4 の浅い木になったこのコンペでは、性質が大きく違う 2 本は作れなかった。Kaggle の最終提出には、この 2 本を選ぶ。本命は OOF AUC の高い Aggressive で、Conservative はブレンドが test でうまく働かなかったときの保険である。
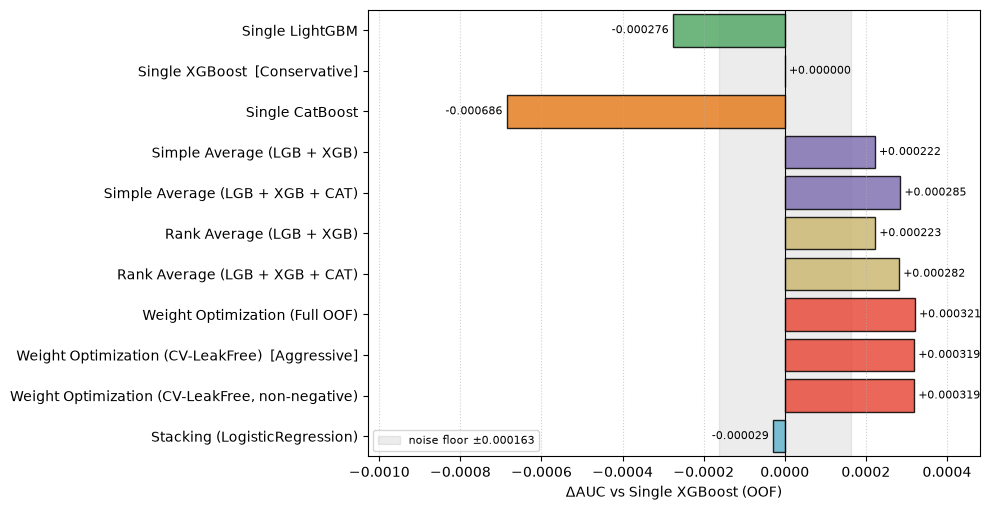
- このグラフを使う理由
- 13 手法の OOF AUC は表にあるが、差は小数 4〜6 桁目にある。単体最強のモデルとの差を横棒にし、ノイズフロアの帯を重ねると、どの手法が本当に上回ったかが一目で分かる。図 4.2 の左と同じ形である。
- 何を見るか
- 帯の外まで右に伸びた手法(単体最強を本当に上回った手法)と、帯の中に収まる手法。提出に選んだ 2 本が、その中のどこにあるか。
- 見方
- 1 行が 1 つの手法で、横軸は単体最強のモデル(XGBoost)との OOF AUC の差。単体のモデルは 図 6.1 と同じ色で、混ぜ方は、紫が単純平均、黄土色が順位平均、赤が加重平均、水色がスタッキング。灰色の帯がノイズフロア(±0.000163)、[Conservative] と [Aggressive] が提出に選んだ 2 本である。LogisticRegression を含む 2 行は差が大きすぎるので描いていない。
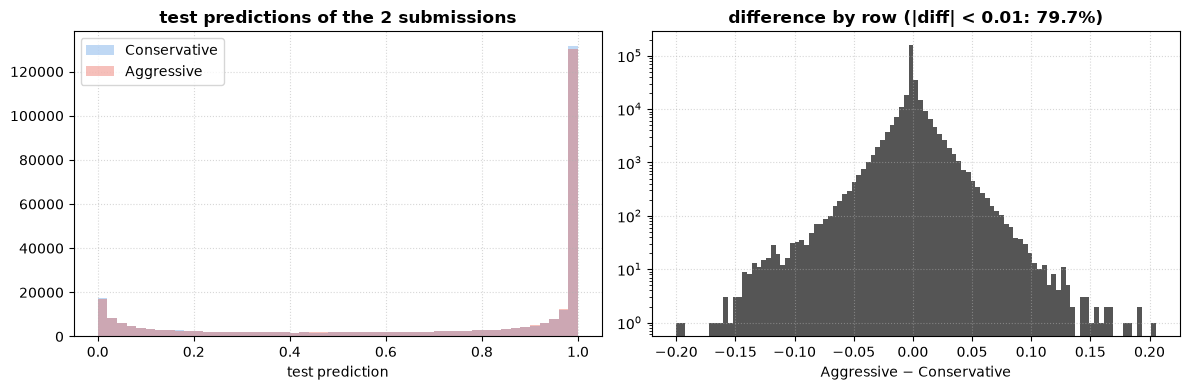
- このグラフを使う理由
- 2 本の相関 0.9994 は、「全部の行が少しずつ違う」のか「ほとんど同じで一部の行だけ違う」のかを教えない。分布を重ねたうえで、行ごとの差をヒストグラムにすると、違いの大きさと、違う行の数が分かる。差の大きい行は少ないので、縦軸は対数にする。
- 何を見るか
- 左では 2 つの分布が重なるか。右では、差がどれくらいの幅に収まり、大きく違う行がどれくらいあるか。
- 見方
- 左は、横軸が test の予測確率、縦軸が件数で、青が Conservative、赤が Aggressive。右は、横軸が行ごとの差(Aggressive − Conservative)、縦軸が件数(対数)である。
図 7.2 では、ノイズフロアの帯の外まで右に伸びたのは、GBDT を 2 つ以上混ぜた 7 つの手法で、どれも +0.000222〜+0.000321 である。その中では加重平均の 3 つ(赤)が最も長いが、3 つの単純平均(+0.000285)との差は、棒の長さでもわずかである。スタッキング(-0.000029)は帯の中に収まり、XGBoost 単体と区別できない。単体の LightGBM(-0.000276)と CatBoost(-0.000686)は帯の外まで左に出ていて、XGBoost 単体より明らかに低い。それでも、混ぜると右に伸びる側に回る。
図 7.3 の左の、提出 2 本の分布は、ほぼ完全に重なる。右の差のヒストグラム(縦軸は対数)を見ると、80.2% の行は差が ±0.01 未満で、最も大きい行でも -0.19〜+0.20 である。差が 0.1 を超える行は 296,302 行のうち 287 行しかない。相関 0.9994 は、「ほとんどの行でほぼ同じ値で、ごく一部の行だけが少し違う」ということである。
次の 7-6 では、seed を変えて学習した予測を平均し、予測のぶれを減らす方法を見る。
7-6seed を変えて平均する(Seed Averaging)
次にやること
提出する 2 本が決まった。ここで、同じ設定のモデルを乱数の seed だけ変えて何回か学習し、予測を平均する方法(Seed Averaging)を見る。
理由
seed の当たり外れを消す:subsample や colsample_bytree を使うと、seed によって使う行・列が変わり、予測が少しずつ変わる。1 つの seed だけで提出すると、その seed が test でたまたま悪い方に出る可能性がある。5 つの seed の平均を出せば、どれか 1 つの運に頼らずに済む。
「最も良い seed」を選ばない:OOF で最も良かった seed を選んでも、それは OOF のノイズに合わせた選び方で、test でも最良とは限らない。
コード
t8_seed.py(準備は 1-3 の囲みの t0_setup.py)
from t0_setup import *
params = dict(learning_rate=0.05, n_estimators=N, verbose=-1,
              subsample=0.8, subsample_freq=1, colsample_bytree=0.8)
Xp = X0.to_pandas()
def oof_for(seed: int) -> np.ndarray:
    oof = np.zeros(len(y))
    for f in range(5):
        tr, va = folds != f, folds == f
        m = LGBMClassifier(random_state=seed, **params).fit(Xp[tr], y[tr])
        oof[va] = m.predict_proba(Xp[va])[:, 1]
    return oof
oofs = [oof_for(s) for s in range(5)]
for s, o in enumerate(oofs):
    print(f"seed={s}        | logloss {log_loss(y, o):.4f}")
avg = np.mean(oofs, axis=0)
print(f"5 seed の平均 | logloss {log_loss(y, avg):.4f}")subsample=0.8, subsample_freq=1 | 木ごとに 80% の行だけを使う(seed で使う行が変わる) |
|---|---|
colsample_bytree=0.8 | 木ごとに 80% の列だけを使う |
np.mean(oofs, axis=0) | 5 つの seed の予測を行ごとに平均する |
結果
seed=0        | logloss 0.4025
seed=1        | logloss 0.4025
seed=2        | logloss 0.4014
seed=3        | logloss 0.4041
seed=4        | logloss 0.4039
5 seed の平均  | logloss 0.4020
seed ごとの logloss は 0.4014〜0.4041 とばらつく。5 つの平均は 0.4020 で、5 つの単体の平均(約 0.4029)より良くなった。最も良い seed(0.4014)にはわずかに届かないが、どの seed が test で最良かは事前に分からないので、平均のほうが安全である。
S6E8 でも、7-5 の Conservative(XGBoost)や Aggressive の 3 つのモデルを、同じパラメータのまま seed を 5 つ変えて学習し、test の予測を平均すると、提出をもう少し安定させられる(S6E8 では未実行)。
S6E8 に戻り、次の 7-7 では、作った 2 本を提出し、CV と Public LB を記録する。
7-7提出して、CV と Public LB を記録する
次にやること
7-5 で、提出ファイルを 2 本作った。次は、2 本を Kaggle に提出する。提出の前に、2 本の CV を 3-8 の実験記録 experiments.csv に足し、提出して Public LB(公開リーダーボードのスコア)が返ってきたら、同じ行に書き込めるようにする。
理由
提出のしかた:コンペのページの「Submit Prediction」から CSV をアップロードするか、Kaggle API のコマンド kaggle competitions submit で送る。コマンドで送るには、Kaggle のアカウント設定で API トークン(kaggle.json)を作り、決められた場所に置く。1 日に提出できる回数には上限があるので、何を出したかを毎回記録する。
提出の前に記録する:提出したファイルの名前と、そのときの CV を 1 行にして残す。返ってきた Public LB を同じ行に書けば、CV と LB を並べて見られる。3-8 で「CV と LB の差を毎回記録する」と書いたのは、この行のためである。
CV と LB の読み方:Public LB は test の一部だけで計算されるので、CV と同じ値にはならない。見るのは値そのものではなく、① CV が上がった変更で LB も上がるか(向きがそろうか)、② CV と LB の差が提出ごとに大きく変わらないか、の 2 つである。向きが逆になる変更が続いたら、CV の設計(第2章)や、train と test の分布の違い(1-8)を疑う。
前の版での実測:この本を書く前の版(特徴量とパラメータがこの本とは違う)で、S6E8 に 2 本を同時に提出したときの記録が次の表である。
| 提出 | CV(OOF AUC)/Public LB/LB − CV |
|---|---|
| LightGBM 単体 | 0.96292/0.96447/+0.00155 |
| 7 つのモデルを混ぜたもの(LogisticRegression・RandomForest・ExtraTrees を含む) | 0.96308/0.96021/−0.00287 |
7 つのモデルを混ぜたものは、CV では LightGBM 単体を 0.00016 上回ったが、Public LB では 0.00426 下回った。CV では弱いモデルを混ぜた重みが合っていても、test では効かなかった例である。この経験から、この本の第6・7章では、単体スコアの低いモデルは混ぜず、GBDT の 3 つだけを混ぜている。また、CV では 0.00016 の差で混ぜたほうが良く見えたが、この差は、この本の 3-5 で測ったノイズフロア(0.000163)の 2 倍ほどしかない。CV の小さな差だけで、より複雑な提出を選ばないことも、この例から分かる。
コード
まず、提出する 2 本を実験記録に足す。7-5 の比較表から、選んだ 2 つの手法の OOF AUC を取り出す。
# 提出する 2 本を、3-8 の実験記録に足す(Public LB は、提出して返ってきたら record_public_lb で書き込む)
_auc = dict(zip(comp_summary_df["method"], comp_summary_df["oof_auc"]))
_log_path = RESULTS_DIR / "experiments.csv"
_row = pl.DataFrame({
    "exp": ["07_conservative", "07_aggressive"],
    "features": ["v1_14", "v1_14"],
    "model": [CONSERVATIVE_CHOICE, AGGRESSIVE_CHOICE],
    "params": ["ch6_tuned", "ch6_tuned"],
    "cv_auc": [_auc[CONSERVATIVE_CHOICE], _auc[AGGRESSIVE_CHOICE]],
    "cv_std": [None, None],
    "public_lb": [None, None],
    "note": [cons_file.name, agg_file.name],
})
if _log_path.exists():
    # 同じ実験名(exp)の行は置き換える。marimo がこのセルを再実行しても行は増えない
    _old = pl.read_csv(_log_path).filter(~pl.col("exp").is_in(_row["exp"].to_list()))
    _row = pl.concat([_old, _row], how="diagonal_relaxed")
_row.write_csv(_log_path)
print(_row)
次に、提出して返ってきた Public LB を書き込む関数を用意する。このセルは関数を定義するだけで、Public LB が返ってきたら、最後のコメントの行のように呼び出す。
def record_public_lb(exp: str, public_lb: float) -> pl.DataFrame:
    """Kaggle で返ってきた Public LB を、実験記録の exp の行に書き込み、CV との差(lb_minus_cv)も出す。"""
    log_path = RESULTS_DIR / "experiments.csv"
    log = pl.read_csv(log_path).with_columns(
        pl.when(pl.col("exp") == exp)
        .then(pl.lit(public_lb))
        .otherwise(pl.col("public_lb").cast(pl.Float64))
        .alias("public_lb")
    ).with_columns((pl.col("public_lb") - pl.col("cv_auc")).round(6).alias("lb_minus_cv"))
    log.write_csv(log_path)
    return log


# 提出して Public LB が返ってきたら、次のように書き込む(数字は自分の結果に置き換える)
# record_public_lb("07_conservative", 0.96xxxx)
提出は、Web ページからアップロードするか、ターミナルで次のコマンドを実行する(ノートブックのセルではない)。
kaggle competitions submit -c playground-series-s6e8 -f submissions/07_submission_conservative.csv -m "conservative: single XGBoost"
kaggle competitions submit -c playground-series-s6e8 -f submissions/07_submission_aggressive.csv -m "aggressive: leak-free weighted blend"dict(zip(df["method"], df["oof_auc"])) | 7-5 の比較表から、手法の名前で OOF AUC を引ける辞書を作る |
|---|---|
pl.when(cond).then(x).otherwise(y) | exp が一致する行だけ Public LB を書き換え、ほかの行はそのままにする |
pl.col("public_lb").cast(pl.Float64) | まだ一度も書き込んでいない空の列を、小数の列としてそろえる |
kaggle competitions submit -c コンペ名 -f ファイル -m メモ | Kaggle API で提出する。メモは提出の一覧に表示される |
結果
┌────────────────────────┬─────────────┬───────────────────────────────────┬──────────────────────┬──────────┬──────────┬───────────┬────────────────────────────────┐
│ exp                    ┆ features    ┆ model                             ┆ params               ┆ cv_auc   ┆ cv_std   ┆ public_lb ┆ note                           │
╞════════════════════════╪═════════════╪═══════════════════════════════════╪══════════════════════╪══════════╪══════════╪═══════════╪════════════════════════════════╡
│ 03_baseline            ┆ baseline_12 ┆ lgbm                              ┆ lr0.05_n500          ┆ 0.960379 ┆ 0.000631 ┆ null      ┆ 基準値                         │
│ 04_features_v1         ┆ v1_14       ┆ lgbm                              ┆ lr0.05_n500          ┆ 0.960856 ┆ 0.000614 ┆ null      ┆ 4-9: baseline_12 + 2 features  │
│ 05_lgbm_tuned          ┆ v1_14       ┆ lgbm                              ┆ optuna25_lr0.1_n5268 ┆ 0.964792 ┆ 0.000522 ┆ null      ┆ configs/selected_params.json   │
│ 06_lightgbm            ┆ v1_14       ┆ lightgbm                          ┆ ch5_tuned            ┆ 0.964792 ┆ 0.000522 ┆ null      ┆ 6-5                            │
│ 06_xgboost             ┆ v1_14       ┆ xgboost                           ┆ ch6_tuned            ┆ 0.965067 ┆ 0.000451 ┆ null      ┆ 6-5                            │
│ 06_catboost            ┆ v1_14       ┆ catboost                          ┆ ch6_tuned            ┆ 0.964382 ┆ 0.000471 ┆ null      ┆ 6-5                            │
│ 06_logistic_regression ┆ v1_14       ┆ logistic_regression               ┆ default              ┆ 0.914775 ┆ 0.000802 ┆ null      ┆ 6-5                            │
│ 07_conservative        ┆ v1_14       ┆ Single XGBoost                    ┆ ch6_tuned            ┆ 0.965067 ┆ null     ┆ null      ┆ 07_submission_conservative.csv │
│ 07_aggressive          ┆ v1_14       ┆ Weight Optimization (CV-LeakFree) ┆ ch6_tuned            ┆ 0.965386 ┆ null     ┆ null      ┆ 07_submission_aggressive.csv   │
└────────────────────────┴─────────────┴───────────────────────────────────┴──────────────────────┴──────────┴──────────┴───────────┴────────────────────────────────┘
実験記録は 9 行になった。第3章のベースラインから、提出する 2 本までが 1 つの表に並ぶ。提出する 2 本の public_lb は、まだ空である。提出して Public LB が返ってきたら record_public_lb で書き込み、lb_minus_cv の列で CV との差を見る。2 本の LB の差が、上の前の版の表のように CV の差と逆の向きになっていないかも確かめる。
最後に 7-8 で、1 周の各工程がスコアにどれだけ効いたかを振り返る。
7-81 周を振り返る
次にやること
ここまでで、最終提出の 2 本を作って提出し、記録する準備ができた。最後に、第1章の EDA から第7章の最終提出までのスコアの推移をまとめ、どの工程がどれだけ効いたかを振り返る。
理由
次のコンペの時間配分に使う:各工程がスコアにどれだけ効いたかを並べると、次のコンペでどこに時間をかけるべきかの目安になる。
結果
| 章 | 手法 | OOF AUC | ΔAUC(前工程比) | 備考 |
|---|---|---|---|---|
| 3 | ダミー分類器 | 0.500000 | - | 理論上の床 |
| 3 | ベースライン LightGBM(12列) | 0.960379 | - | 基準値(Fold 間 std 0.000631) |
| 4 | features_v1(14列) | 0.960856 | +0.000478 | 特徴量エンジニアリング(比率・非余暇、5 Fold すべてで改善) |
| 5 | パラメータ最適化(LightGBM) | 0.964792 | +0.003936 | Optuna 探索 + early stopping で木の数を決定(5268 本) |
| 6 | 最良単一モデル(XGBoost) | 0.965067 | +0.000275 | 3 つの GBDT を同じ手順で調整して比較。Conservative |
| 7 | 最終アンサンブル | 0.965386 | +0.000319 | CV 重み最適化ブレンド(重みはすべて正)。Aggressive |
最も効いた工程:このコンペ(S6E8)で最もスコアを押し上げたのは、第5章のパラメータ探索(ΔAUC +0.003936)であった。この中には、木の数を 500 本の固定から early stopping で決めた本数(学習率 0.1 で 5268 本)に変えた効果も入っている。69 万行あるデータでは、第3・4章の 500 本は少なすぎた。
工程のつながり:第1章の EDA で、スクリーンタイム系の数値特徴量が非常に重要で、カテゴリ列にはほとんど情報がないと分かった。第4章では意味のある比率の特徴量を 2 つ足し(+0.000478)、カテゴリ列を使う特徴量は採択しなかった。第5章では、深さ 3 の浅い木を数千本並べる設定が選ばれた。第6章では、カテゴリ列に情報がないことから CatBoost のカテゴリ処理を one-hot で済ませた。
調整の手間をそろえて比べる:第6章で XGBoost と CatBoost にも LightGBM と同じ手間をかけて調整すると、単体の最良は XGBoost で、3 つの GBDT の差は 0.0007 以内であった。調整の手間がそろっていない比較からは、「どのモデルが強いか」は言えない。
アンサンブル:単体の強さがそろった GBDT の 3 つは、単純平均でも XGBoost 単体を上回り、重み最適化でさらに +0.000319 を上積みした(単純平均との差は誤差の範囲)。重みは 5 つの Fold すべてで正の、安定した値であった。
これで 1 周が終わった。次のコンペでも、第1章のデータを知るところから、この本と同じ順番で進めればよい。