CH 3LightGBM で最初の提出をする(ベースライン)
第2章で固定した分割(folds.csv)を使い、LightGBM で最初の提出まで一本通す。特徴量の加工も欠損処理もせず、パラメータは固定値で構わない。この章のゴールはスコアを上げることではなく、改善を測る基準値(ベースラインの OOF AUC)とその揺らぎ幅(ノイズフロア、noise floor)を手に入れ、提出の形を初日に確かめることである。入力から学習・OOF 予測・評価・提出ファイルまでが通って初めて、第4章以降の「仮説を立てて確かめる」改善のサイクルが回り始める。
3-1データと分割を読み込み、特徴量と目的変数を分ける
次にやること
第2章で CV の分割をファイルに固定した。第3章は新しいノートブックで始めるので、最初にライブラリ・定数・データを用意し、2-2 で保存した分割(folds.csv)を読み込む。次に、モデルに渡す列を決める。ID 列と目的変数を除いた列を特徴量の列 feature_cols とし、目的変数は NumPy 配列 y として取り出す。あわせて、test にも同じ列が同じ順で並んでいることを確かめる。
理由
新しいノートブックなので最初に用意する:ノートブックは章ごとに 1 冊なので、第3章で使うライブラリ、PROJECT などの置き場所、ID・TARGET、グラフの色、train・test・sample_submission の読み込み、カテゴリ列の仕分け(1-3 と同じ)を、この章の最初のセルで用意し直す。値は第1・2章と同じにする。生データは train_raw・test_raw・sample_sub_raw の名前で読み、コピーの train・test・submission を使う。submission は 3-7 で提出ファイルと比べる基準にする。
分割は作り直さずに読み込む:2-2 で保存した folds.csv を読み込み、その id と目的変数が今の train と同じ並びかを assert で確かめる。分割をこの章で作り直すと、第2章と違う分割で測ることになるおそれがある。読み込んで照合すれば、違うデータで作った分割を使う事故も防げる(第4章の 4-1 も同じ形にしている)。
train と test の列構成をそろえる:モデルは列の名前ではなく列の位置で学習した値を使うことがある。train と test で列の順序や種類がずれたまま予測すると、エラーにならずに意味のない結果が返ってくるため、非常に見つけにくいバグになる。これを防ぐため、使う列を feature_cols という 1 つのリストで決め、test の列と一致することを assert で確かめる。次の 3-2 では、train も test もこのリストで列を選ぶ。
目的変数を NumPy 配列にする:sklearn や LightGBM は、目的変数を 1 次元の配列で受け取る。最初に 1 回取り出して y とし、以降の節ではこれを使い回す。
コード
まず、第3章で使うライブラリ・定数・データを用意する。値は第1・2章と同じである。
# 第3章で使うライブラリを、最初のセルでまとめてインポートする
from pathlib import Path
from typing import Any

import matplotlib.pyplot as plt
import numpy as np
import polars as pl
import seaborn as sns
from lightgbm import LGBMClassifier
from sklearn.dummy import DummyClassifier
from sklearn.metrics import roc_auc_score, roc_curve

# データの置き場所と定数(第1・2章と同じ値)
PROJECT = Path(r"D:\kaggle\smartphone-addiction_s6e8")   # データの置き場所。自分の環境に合わせて書き換える
RAW_DIR = PROJECT / "data" / "raw"
PROCESSED_DIR = PROJECT / "data" / "processed"  # folds.csv(2-2 で保存)
SUBMISSIONS_DIR = PROJECT / "submissions"       # 提出ファイル(3-7)
RESULTS_DIR = PROJECT / "results"               # 実験記録(3-8)
for _d in (SUBMISSIONS_DIR, RESULTS_DIR):
    _d.mkdir(parents=True, exist_ok=True)

ID = "id"
TARGET = "addicted_label"

# グラフの色(第1章と同じ): train = 紺・test = オレンジ
C_TRAIN, C_TEST = "#2b5c8f", "#e27c39"

# 生データは *_raw の名前で読み込み、以降は作業用のコピーを使う(1-1 と同じ)
train_raw = pl.read_csv(RAW_DIR / "train.csv")
test_raw = pl.read_csv(RAW_DIR / "test.csv")
sample_sub_raw = pl.read_csv(RAW_DIR / "sample_submission.csv")
train = train_raw.clone()
test = test_raw.clone()
submission = sample_sub_raw.clone()   # 3-7 で提出ファイルと比べる基準
cat_cols = [c for c, dt in train.schema.items()
            if dt == pl.String and c not in (ID, TARGET)]   # 1-3 と同じ仕分け
次に、2-2 で保存した分割を読み込み、今の train と合っているかを確かめる。
fold_df = pl.read_csv(PROCESSED_DIR / "folds.csv")
assert fold_df[ID].equals(train[ID]), "id の並びが train と一致しません"
assert fold_df[TARGET].equals(train[TARGET]), "目的変数が train と一致しません"
folds = fold_df["fold"].to_numpy()
print("train", train.shape, " test", test.shape, " fold sizes:", np.bincount(folds))
最後に、モデルに渡す列と目的変数を決める。
# 特徴量は、id と目的変数を除いたすべての列
feature_cols = [c for c in train.columns if c not in (ID, TARGET)]
y = train[TARGET].to_numpy()

assert feature_cols == [c for c in test.columns if c != ID], "train と test で列がずれています"
print("特徴量の数:", len(feature_cols))
print("y:", y.shape, "陽性率:", round(y.mean(), 4))pl.read_csv(PROCESSED_DIR / "folds.csv") | 2-2 で保存した分割(id・fold・目的変数)を読み込む |
|---|---|
s.equals(other) | 2 つの列が同じ順番・同じ値かを確かめる。分割と train を行の位置で対応させてよい根拠になる |
np.bincount(folds) | Fold 番号ごとの行数を数える |
[c for c in df.columns if ...] | 列の名前のリストから、条件に合う列だけを残したリストを作る(リスト内包表記) |
df[col].to_numpy() | Polars の列を NumPy 配列にする。sklearn / LightGBM に渡す形 |
結果
train (691369, 14) test (296302, 13) fold sizes: [138274 138274 138274 138274 138273]
2-2 で保存した分割を読み込み、id と目的変数の並びが今の train と一致することを確かめた。Fold ごとの行数は 2-2 の出力と同じ 138,274 行(最後の Fold だけ 138,273 行)である。train・test の大きさも 1-1 と同じなので、第1・2章と同じデータで第3章を進められる。
特徴量の数: 12
y: (691369,) 陽性率: 0.7094
特徴量は 12 列になった。1-3 で仕分けた数値列 9 個とカテゴリ列 3 個の合計で、id と目的変数は入っていない。y は 691,369 行の 1 次元配列で、陽性率 0.7094 は 1-2 で見た値と一致する。assert が通ったので、test にも同じ 12 列が同じ順で並んでいる。
次の 3-2 では、カテゴリ列を LightGBM が分かる型にして、特徴量行列を作る。
3-2カテゴリ列の値を train と test でそろえる(Enum 型)
次にやること
前の節で、モデルに渡す列 feature_cols と目的変数 y を決めた。次は、train と test に同じ処理を通す関数 make_features を作り、特徴量行列 X / X_test を作る。カテゴリ列は、train と test の両方に現れる値を集めた pl.Enum 型にする。One-Hot にも Label Encoding にもせず、カテゴリのまま LightGBM に渡す。最後に、LightGBM に渡すとき(.to_pandas() した後)の型を確かめる。実際に LightGBM で学習するのは 3-4 である。
理由
LightGBM はカテゴリをそのまま分割できる(One-Hot が不利な理由):LightGBM は、カテゴリ列の分岐で、カテゴリを勾配の統計量(目的変数の平均に近い値)で並べてから、最もよい部分集合に分ける。One-Hot にすると「1 カテゴリ対その他すべて」の分岐しか作れなくなり、表現力が落ちるうえ、列数が増えて遅くなる。ただし、種類が 4 以下の列(max_cat_to_onehot の既定値)は LightGBM 自身が「1 対その他」で分けるので、差が出るのは種類の多い列である。S6E8 のカテゴリ列は 2〜3 種類である。
Enum で train と test の値をそろえる:pl.Enum は、取りうる値の一覧と順番を型として固定する。train と test の両方に現れる値を集めて Enum にすると、どちらの表でも同じ値に同じコード番号が付く。test にしか出てこない値があっても、型の一覧に入っているのでずれない。
LightGBM にはカテゴリ列を名前で伝える:LightGBM 4.7 は数値だけの Polars の表なら受け取れるが、Enum の列があると止まる。そのため、学習の直前に .to_pandas() を挟む(pyarrow が必要)。Enum を pandas にすると、順序付き(ordered)の category 型になる。LightGBM は、カテゴリ列を指定しないとき(categorical_feature="auto")、順序なしの category 型の列だけをカテゴリとして扱い、順序付きの列はコード番号(0, 1, 2)を数値とみなして大小で分ける。そこで 3-4 以降では、fit に categorical_feature=cat_cols を渡し、カテゴリ列を名前で明示する。この節の最後の出力で、順序付きになっていることを確かめる。
処理を 1 つの関数にまとめる:train と test に別々のコードを書くと、片方だけ直し忘れて列がずれる。make_features という共通関数を通す形にする。第4章でも、同じ 12 列を作る共通関数(get_base_features)を train と test の両方に通す。
欠損の扱い:カテゴリ列の欠損(null)は、pandas に変換しても欠損のままで、LightGBM はこれを欠損として扱う。1-6 で見たとおり、S6E8 では欠損行の陽性率が全体と同じなので、これで問題ない。
コード
# train と test の両方に現れる値を集めて、カテゴリの集合を固定する
levels = {
    c: sorted(set(train[c].drop_nulls().to_list())
              | set(test[c].drop_nulls().to_list()))
    for c in cat_cols
}

def make_features(df: pl.DataFrame) -> pl.DataFrame:
    '''train / test に共通の前処理。列構成を必ずそろえる。'''
    return df.select(feature_cols).with_columns(
        [pl.col(c).cast(pl.Enum(levels[c])) for c in cat_cols]
    )

X, X_test = make_features(train), make_features(test)
assert X.columns == X_test.columns, "train と test で列がずれています"
print("X shape", X.shape)

# LightGBM に渡すとき(.to_pandas() した後)の型を確かめる
_pdf = X.head(1).to_pandas()
print(_pdf.dtypes)
# Enum は pandas では順序付き(ordered)の category になる
print("ordered:", {c: _pdf[c].cat.ordered for c in cat_cols})df.select([cols]) | 指定した列だけを、指定した順に取り出す |
|---|---|
pl.Enum([...]) | カテゴリの順序・集合をはっきり固定する型。train / test 間の水準のずれを防ぐ |
pl.col(c).cast(型) | 列の型を変える。ここではカテゴリ列を pl.Enum にする |
df.to_pandas() | Polars の DataFrame を pandas に変換する。Enum の列は順序付きの category 型になる |
pdf.dtypes | pandas の DataFrame の列ごとの型を表示する |
pdf[c].cat.ordered | pandas の category 型が順序付きかどうかを返す |
結果
X shape (691369, 12)
age                           int64
daily_screen_time_hours     float64
social_media_hours          float64
gaming_hours                float64
work_study_hours            float64
sleep_hours                 float64
notifications_per_day         int64
app_opens_per_day             int64
weekend_screen_time         float64
gender                     category
stress_level               category
academic_work_impact       category
dtype: object
ordered: {'gender': True, 'stress_level': True, 'academic_work_impact': True}
特徴量行列 X は 691,369 行・12 列になった。.to_pandas() した後の型を見ると、数値列 9 個は int64 / float64、カテゴリ列 3 個(gender・stress_level・academic_work_impact)は category で、3 列とも ordered が True(順序付き)である。このまま渡すと、LightGBM はこの 3 列をカテゴリとして扱わない。そこで 3-4 からは、fit に categorical_feature=cat_cols を渡す。
次の 3-3 では、学習をしないダミー分類器(dummy classifier)でスコアの下限を測る。
3-3ダミー分類器で下限を知る
次にやること
前の節までで、モデルに渡す特徴量行列ができた。LightGBM を回す前に、学習を一切しないモデルのスコアを測る。ここが「これより低ければバグ」という床になる。
理由
配線チェックとして使う:ROC-AUC の場合、ダミー分類器のスコアは定義上 0.5 になる。当たり前に見えるが、一度自分で測ることに意味がある。特徴量行列と目的変数をモデルに渡し、予測確率を評価関数に(正解, 確率)の順で渡すまでの流れが通るかを、学習を挟まない最小の構成で確かめられるからである。
ここでは見つからない間違いもある:ダミー分類器は全行に同じ確率を返すので、どの列を取っても、正解ラベルを逆にしても AUC は 0.5 になる。[:, 1] を [:, 0] にする取り違えや、ラベルの向きの間違いは、学習したモデル(3-4)で初めて分かる。3-4 の AUC が 0.5 を大きく下回り、1 − AUC のほうがよい値になっていたら、列かラベルの向きが逆である。本番のモデルでこの間違いに気づかないと、スコアが低い原因をモデル側に探して何時間も使ってしまう。
コード
# DummyClassifier と roc_auc_score は 3-1 でインポート済み

X_pd = X.to_pandas()
dummy = DummyClassifier(strategy="prior").fit(X_pd, y)
print("dummy AUC:", round(roc_auc_score(y, dummy.predict_proba(X_pd)[:, 1]), 6))DummyClassifier(strategy="prior") | 常に訓練データの事前確率(各クラスの割合)を返すダミー分類器 |
|---|---|
model.predict_proba(X)[:, 1] | 陽性クラス(クラス 1)の予測確率(predicted probability)を取り出す |
roc_auc_score(y_true, y_pred) | 正解ラベルと予測確率から ROC-AUC を計算する |
結果
dummy AUC: 0.5
ダミー分類器の AUC は 0.5 で、定義どおりである。データをモデルに渡して評価するまでの流れが通ることを確かめられた。これが床で、以降のモデルがこれに近い値を出したら、まず実装のミスを疑う。
次の 3-4 では、LightGBM で 5-Fold CV を回し、OOF 予測とスコアを出す。
3-45-Fold で OOF を作り、スコアを測る
次にやること
前の節で、ダミー分類器の床(0.5)を確かめた。次は Fold ごとに LightGBM を学習し、検証側の予測を oof 配列の該当位置に書き込む。同時に test への予測を Fold 数で割って足し込む。最後に Fold ごとのスコア、その平均と標準偏差、OOF 全体のスコアを出し、3 つとも記録する。続けて、Fold ごとのスコア・OOF 予測の分布・特徴量の重要度をグラフにして、モデルの中身を確かめる。
理由
OOF 予測とは何か:OOF(Out-Of-Fold)予測とは、「その行を学習に使っていないモデルによる予測」を全行分そろえた配列である。学習データに対する予測は過学習(overfitting)でいくらでも高く出るが、OOF 予測は見ていないデータに対する予測なので、汎化性能(generalization performance)に近い値になる。これがあると、全データに対して 1 つの AUC を計算でき、しかも過学習していない値になる。
この先の章すべての土台になる:第4章の特徴量の比較、第5章のチューニング結果の確認、第6章のモデル間の相関分析、第7章のアンサンブルの重みの最適化は、すべてこの OOF 配列の上で行う。
test 予測は Fold の平均を取る:test への予測は、各 Fold のモデルの平均を取る(Fold 数で割って足し込む)。これは 5 モデルの簡易なアンサンブルになっていて、単一モデルより安定する。
パラメータは固定値でよい:ベースラインでは learning_rate=0.05, n_estimators=500 のような固定値で構わない。チューニングは第5章で行う。ここで凝ると、後で何が効いたのかが分からなくなる。
カテゴリ列は categorical_feature で渡す:3-2 で確かめたとおり、Enum から変換した category 列は順序付きなので、LightGBM は自動ではカテゴリとして扱わない。fit に categorical_feature=cat_cols を渡し、この 3 列をカテゴリとして扱うよう明示する。予測(predict_proba)のときは、学習時に覚えたカテゴリの扱いがそのまま使われるので、指定し直す必要はない。以降の章でも、LightGBM を学習するときは同じように渡す。
エディターの型チェックで警告が出ないように書く:marimo のエディターは、型チェッカー(ty)でコードを調べ、引っかかった所を Problems に表示する。LightGBM の predict_proba は、型の上では「疎行列(sparse matrix)やそのリストを返すこともある」と宣言されている。そのため、結果にそのまま [:, 1] を付けると、実行には問題がないのに警告が出る。np.asarray(...) で NumPy 配列にそろえてから列を取ると、警告は消え、値も変わらない。同じく、学習率(小数)と木の本数(整数)のように型の違う値を入れた辞書を **params で渡すときは、params: dict[str, Any] と型ヒントを付け、値の型が 1 つに決まらないことを伝える。どちらも実行結果には影響しない。以降の章でも同じ書き方をする。
型ヒントは、関数の入口にだけ書く:この本では、型ヒントを次の範囲にだけ書く。① セルの一番外の関数は、引数に型を書く。何を渡す関数かが読んで分かり、渡し間違いにエディターが気づける。② 戻り値は、1 つの値を返すときだけ -> float のように書く。いくつも返す関数には書かず、何を返すかを docstring に書く。③ 関数の中の小さな関数と、ふつうの変数には書かない。上の params のように、書かないと警告が出る所だけ書く。型は pl.DataFrame・np.ndarray・int・float・str・list[str] のような簡単なものだけを使う。仕事の Python でも、関数の入口に型を書き、中身はエディターの推測に任せる書き方は広く使われている。厳密に書きすぎると、写すときにも読むときにも分かりにくくなるので、この範囲にとどめる。
Fold 間の標準偏差は誤差の目安になる:Fold ごとのスコアのばらつきを見ると、「このくらいの差は分割の違いでも出る」という目安が分かる。この数字を知らずに小さな改善を追いかけると、時間を無駄にしやすくなる。
スコアの数字だけでなく、予測の分布を見る:AUC は 1 つの数字なので、モデルがどう当てているかまでは分からない。正解が 0 の行と 1 の行に分けて OOF 予測のヒストグラムを描くと、0 の行の予測が 0 の近く、1 の行の予測が 1 の近くに分かれているか、どこで重なっているかが見える。重なっている部分が、モデルが見分けられていない行である。ROC 曲線(ROC curve)も一緒に描く。しきい値を 1 から 0 まで下げていったときの、0 の行を誤って 1 とした割合(横軸)と、1 の行を正しく 1 とした割合(縦軸)の動きを描いたもので、曲線の下の面積が AUC である。
モデルがどの列を使ったかを見る(特徴量の重要度):LightGBM は、各列の分岐で損失がどれだけ減ったか(gain)を数えている。5 Fold のモデルの平均を取って並べると、1-7 で強いと分かった列を、モデルも実際に使っているかを確かめられる。第4章で特徴量を足したときに、新しい列が使われているかを見る基準にもなる。
コード
# LGBMClassifier と Any は 3-1 でインポート済み
params: dict[str, Any] = dict(learning_rate=0.05, n_estimators=500, random_state=42, verbose=-1)

oof = np.zeros(len(y))
test_pred = np.zeros(X_test.height)
fold_scores = []
importance = np.zeros(X.width)   # 5 Fold の特徴量の重要度(gain)の平均

for f in range(5):
    tr_mask, va_mask = folds != f, folds == f
    model = LGBMClassifier(**params).fit(
        X.filter(tr_mask).to_pandas(), y[tr_mask], categorical_feature=cat_cols
    )

    oof[va_mask] = np.asarray(model.predict_proba(X.filter(va_mask).to_pandas()))[:, 1]
    test_pred += np.asarray(model.predict_proba(X_test.to_pandas()))[:, 1] / 5
    fold_scores.append(roc_auc_score(y[va_mask], oof[va_mask]))
    importance += model.booster_.feature_importance("gain") / 5

for i, s in enumerate(fold_scores):
    print(f"  fold{i}: {s:.6f}")
print(f"  mean : {np.mean(fold_scores):.6f}  (std {np.std(fold_scores):.6f})")
print(f"  OOF  : {roc_auc_score(y, oof):.6f}")
次に、Fold ごとの AUC を点で描き、平均の線と ±1 標準偏差の帯を重ねる。
_mean, _std = np.mean(fold_scores), np.std(fold_scores)

_fig, _ax = plt.subplots(figsize=(7, 3.8))
_ax.plot(range(5), fold_scores, "o", color="#4C72B0", alpha=0.85, markeredgecolor="black", markersize=9)
for _i, _s in enumerate(fold_scores):
    _ax.annotate(f"{_s:.6f}", (_i, _s), textcoords="offset points", xytext=(0, 9), ha="center", fontsize=9)
_ax.axhline(_mean, color="#C44E52", linestyle="--", linewidth=2, label=f"mean {_mean:.6f}")
_ax.axhspan(_mean - _std, _mean + _std, color="#C44E52", alpha=0.15, label=f"±1 std ({_std:.6f})")
_ax.set_xticks(range(5), [f"fold{_i}" for _i in range(5)])
_ax.set_ylim(_mean - 4 * _std, _mean + 4 * _std)   # 差が見えるように、縦軸は平均の前後だけを描く
_ax.set_ylabel("ROC AUC")
_ax.legend(loc="lower right")
_ax.grid(axis="y", linestyle=":", alpha=0.6)   # 点線の目盛り線
_fig.tight_layout()
_fig
続けて、OOF 予測の分布を正解の 0 と 1 に分けて描き、隣に ROC 曲線を描く。
_fig, (_ax1, _ax2) = plt.subplots(1, 2, figsize=(12, 4.2))

# 左: 正解が 0 の行(青)と 1 の行(赤)の、OOF 予測のヒストグラム
sns.histplot(x=oof, hue=y, palette={0: "#4C72B0", 1: "#C44E52"}, bins=50, stat="density",
             common_norm=False, alpha=0.4, linewidth=0, ax=_ax1)
_ax1.set_xlabel("OOF predicted probability")
_ax1.set_title("OOF prediction by true label", fontweight="bold")
_ax1.grid(True, linestyle=":", alpha=0.5)

# 右: ROC 曲線
_fpr, _tpr, _thr = roc_curve(y, oof)
_ax2.plot(_fpr, _tpr, color="#55A868", linewidth=2.5, label=f"OOF AUC = {roc_auc_score(y, oof):.6f}")
_ax2.plot([0, 1], [0, 1], color="gray", linewidth=1.5, linestyle="--", label="random (AUC = 0.5)")
_ax2.set_xlabel("false positive rate")
_ax2.set_ylabel("true positive rate")
_ax2.set_title("ROC curve (OOF)", fontweight="bold")
_ax2.legend(loc="lower right")
_ax2.grid(True, linestyle=":", alpha=0.5)
_fig.tight_layout()
_fig
最後に、5 Fold で平均した特徴量の重要度を、大きい順に横棒で並べる。
_order = np.argsort(importance)   # 小さい順。barh は下から描くので、大きいものが上に来る

_fig, _ax = plt.subplots(figsize=(7, 4.5))
_ax.barh(np.array(X.columns)[_order], importance[_order], color="#55A868", alpha=0.85)
_ax.set_xlabel("gain (mean of 5 folds)")
_ax.set_title("feature importance (baseline LightGBM)", fontweight="bold")
_ax.grid(axis="x", linestyle=":", alpha=0.6)
_fig.tight_layout()
_figLGBMClassifier(...).fit(X, y, categorical_feature=cat_cols) | LightGBM モデルを学習する。categorical_feature でカテゴリとして扱う列を名前で指定する。verbose=-1 で不要なログを抑える |
|---|---|
np.asarray(model.predict_proba(X))[:, 1] | 陽性確率を取り出す。np.asarray で NumPy 配列にそろえてから列を取る(理由を参照) |
params: dict[str, Any] | 型ヒント。値の型がまちまちな辞書であることを型チェッカーに伝える。Any は 3-1 で typing からインポートした |
folds != f / folds == f | 学習側・検証側の行を選ぶ bool のマスク |
X.filter(mask) | Polars でマスクによって行を抜き出す |
roc_auc_score(y_true, y_score) | ROC-AUC を計算する。確率を渡す(0/1 のラベルではない) |
np.mean(scores) / np.std(scores) | Fold 間の平均値と標準偏差(ばらつき)を計算する |
df.to_pandas() | LightGBM に渡すため pandas の DataFrame に変換する(PyArrow 連携) |
model.booster_.feature_importance("gain") | 列ごとの重要度(その列の分岐で損失が減った量の合計)。5 で割って足し込み、5 Fold の平均にする |
ax.plot(x, y, "o") | 点だけを描く。縦軸を一部だけ描くときは、棒より点のほうが差を正しく見せられる |
ax.annotate(文字, (x, y), xytext=(0, 9), textcoords="offset points") | 点の 9 ポイント上に値を書く |
ax.axhspan(下, 上, alpha=0.15) | 横方向の帯を薄く塗る。平均 ± 1 標準偏差の範囲を示す |
ax.grid(axis="y", linestyle=":", alpha=0.6) | 目盛りの位置に薄い点線を引き、値を読みやすくする。axis="y" なら横線だけ、True なら縦横の両方を引く |
sns.histplot(x=oof, hue=y, stat="density", common_norm=False) | 正解の 0 と 1 で色を分けたヒストグラム。stat="density" と common_norm=False で、件数の違う 0 と 1 をそれぞれ面積 1 にそろえて形を比べる |
roc_curve(y, oof) | しきい値ごとの偽陽性率(false positive rate)と真陽性率(true positive rate)を返す。ROC 曲線を描くのに使う |
np.argsort(a) | 値を小さい順に並べたときの位置を返す。列名と重要度を同じ順に並べ替えるのに使う |
結果
  fold0: 0.959435
  fold1: 0.960136
  fold2: 0.960685
  fold3: 0.961348
  fold4: 0.960292
  mean : 0.960379  (std 0.000631)
  OOF  : 0.960379
Fold ごとの AUC は 0.959435〜0.961348 で、Fold 間の標準偏差は 0.000631 である。つまり、分割が変われば AUC はこのくらい動く。特徴量を足して AUC が 0.0003 上がっても、Fold 間のばらつきの範囲に収まる。ただし、同じ分割の上で比べるときに使う誤差の目安は、これとは別に 3-5 で測る。
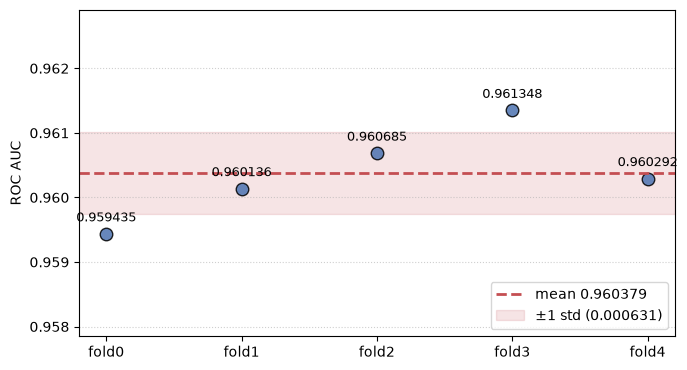
- このグラフを使う理由
- 5 つの Fold のスコアの差は 0.001 程度で、0 から始まる棒グラフでは同じ長さに見えてしまう。そこで縦軸を平均の前後だけに絞り、棒ではなく点で描く。棒は 0 からの長さで量を表すので、軸を途中から始めると差を大げさに見せてしまうからである。
- 何を見るか
- 1 つだけ極端に低い Fold がないか。点が平均 ± 1 標準偏差の帯の周りに散らばっていれば、分割による揺れは標準偏差くらいの大きさである。
- 見方
- 横軸は Fold、縦軸は ROC AUC。赤い点線が 5 Fold の平均、薄い赤の帯が平均 ± 1 標準偏差である。
図 3.1 の縦軸は、差が見えるように平均の前後(0.958〜0.963)だけを描いている。最も低い fold0 は平均より 0.000944 低く、最も高い fold3 は 0.000969 高い。どの Fold も平均から ±0.0010 以内で、1 つだけ極端に低い Fold はない。分割による差は、このくらいの大きさである。
Fold 平均と OOF 全体のスコアは、ここでは小数第 6 位まで一致した(0.960379)。各 Fold の件数と陽性率がそろっている(StratifiedKFold)と、両者は非常に近くなる。大きく食い違うときは、Fold ごとのデータ量が偏っているか、実装にミスがある。
この 0.960379 が、以降すべての基準値である。第4章で特徴量を足すときも、第5章でパラメータを振るときも、比べる相手はこの数字になる。
- このグラフを使う理由
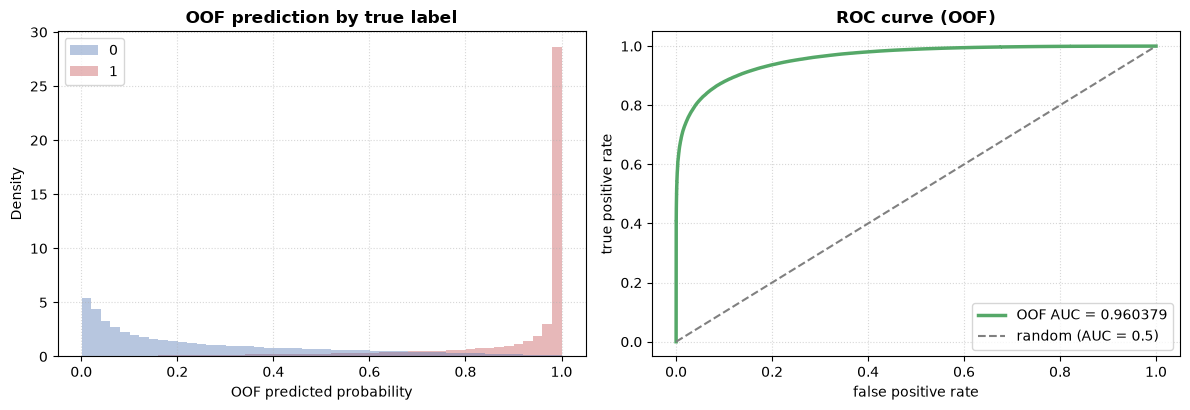
- AUC は 1 つの数字で、モデルがどう当てているかまでは分からない。正解ごとに予測の分布を分けて描くと、どこで間違えているかが見える。ROC 曲線は AUC そのものを図にしたもので、AUC の意味を確かめるために並べる。
- 何を見るか
- 左では、青(正解 0)と赤(正解 1)がどこで重なっているか。重なった区間が見分けられていない行で、改善の対象である。右では、曲線が左上にどれだけ張り出しているか。
- 見方
- 左は、横軸が OOF の予測確率、縦軸が密度(0 と 1 をそれぞれ面積 1 にそろえている)。右は、横軸が偽陽性率(0 の行を誤って 1 とした割合)、縦軸が真陽性率(1 の行を正しく 1 とした割合)で、曲線の下の面積が AUC である。灰色の点線は当てずっぽう(AUC 0.5)を表す。
図 3.2 の左を見ると、正解が 1 の行(赤)の予測は、1 の近くに集まる。中央値は 0.992 で、65% の行が 0.95 を超える。一方、正解が 0 の行(青)の予測は、0 の近くから 0.9 付近まで広く散らばる。中央値は 0.18 で、0.1 未満は 36% にとどまり、19% の行は 0.5 を超えている。このモデルは、依存している人を確信をもって当てる一方で、依存していない人の一部を依存側と見誤っている。青と赤が重なる 0.5〜0.9 あたりが見分けられていない行で、第4章以降の改善は、この重なりを減らすことになる。右の ROC 曲線は左上に大きく張り出していて、曲線の下の面積が OOF AUC の 0.960379 である。
- このグラフを使う理由
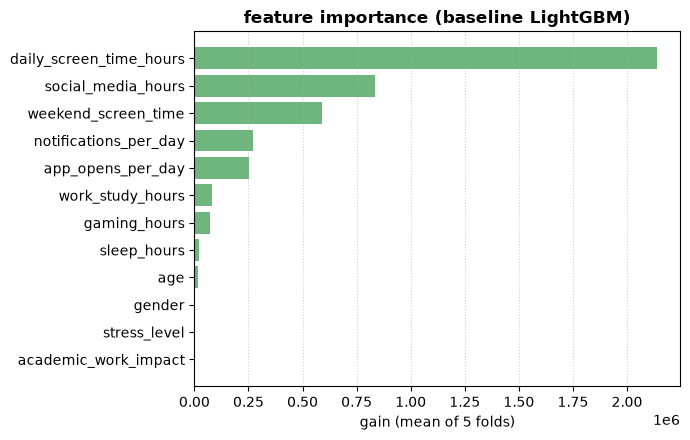
- EDA(1-7)で強いと見た列を、モデルも実際に使っているかを確かめる。12 列を大きい順に並べた横棒にすると、順位と大きさを同時に読める。重要度には、使った回数(split)より効き方の大きさを表す gain を使う。
- 何を見るか
- 上位に来る列と、EDA の見立てとの食い違い。EDA で弱く見えたのに上位に来る列は、ほかの列と組み合わさって効いている可能性がある。
- 見方
- 縦軸は列、横軸は 5 Fold で平均した gain である。
図 3.3 の重要度は、daily_screen_time_hours が飛び抜けて大きく、social_media_hours・weekend_screen_time が続く。1-7 で強いと分かった 3 列が上位にあり、カテゴリ 3 列はほぼ 0 である(1-6 の結果と一致する)。
一方、1-7 で単体ではほとんど効かないと見た notifications_per_day と app_opens_per_day が 4・5 位に入り、中くらいと見た work_study_hours・gaming_hours より上にある。単体では陽性率を動かさなくても、ほかの列と組み合わさると効いている可能性がある。実際、3-4 のセルで学習と予測に使う X・X_test からこの 2 列を除いて同じ条件で回すと、OOF AUC は 0.960379 から 0.943088 に 0.017290 下がった。1 列ずつ除いても、notifications_per_day で 0.007904、app_opens_per_day で 0.006683 下がる。単体の集計で弱く見える列でも、すぐには捨てない。列を使うかどうかの最終的な判定は、第4章のように CV のスコアで比べて行う。
次の 3-5 では、シードだけを変えて同じ学習を回し、このスコアがどれだけ揺れるか(ノイズフロア)を測る。
3-5シードだけを変えてスコアの揺れを測る(ノイズフロア)
次にやること
前の節で、基準値 0.960379 が手に入った。次は Fold 分割を固定したまま、モデルの乱数シードだけを変えて同じ学習を 3 回回し、スコアがどれだけ揺れるかを測る。この揺らぎ幅が「意味のある改善」の下限になる。そのために、3-4 の学習ループを、シードを引数に取る関数 run_cv にまとめる。最後に、Fold ごとのスコアをシード別に並べたグラフで、Fold による揺れとシードによる揺れの大きさを比べる。
理由
Fold 分割は固定し、モデルのシードだけを変える:分割も変えてしまうと、モデルの揺らぎと分割の揺らぎが混ざって切り分けられない。分割を folds.csv で固定したうえでシードだけを変えれば、アルゴリズム内部の乱数だけで生じる揺れを測れる。既定の設定では、特徴量や行のサンプリングは行わない。シードで変わるのは、ヒストグラムの区切り(bin)を決めるために抜き出す 20 万行(bin_construct_sample_cnt)の選び方である。学習側は約 55 万行あるので、この選び方で区切りが少し変わる。
採択の閾値を決める:測った揺らぎ幅より小さい改善は、報告しても意味がない。逆に、この数字を持っていれば「この特徴量は採用」「これは誤差」を機械的に判定できる。第4章のアブレーション実験は、この基準があって初めて成り立つ。
シードは 3 個で足りる:5 回、10 回と増やしても判断の桁は変わらず、時間だけがかかる。
2 つの揺れを 1 枚に並べる:横軸に Fold、縦軸に AUC を取り、シードごとに印を変えて点を打つ。同じ Fold の中で点がどれだけ離れるかがシードによる揺れ、Fold どうしで点の高さがどれだけ違うかが分割による揺れである。
コード
N_SPLITS = 5


def run_cv(seed: int = 42, **overrides: Any):
    """固定した folds で 5-Fold CV を回し、OOF・test 予測・fold 別スコアを返す。"""
    params: dict[str, Any] = dict(
        learning_rate=0.05, n_estimators=500, random_state=seed, verbose=-1
    )
    params.update(overrides)

    oof = np.zeros(len(y))
    test_pred = np.zeros(X_test.height)
    fold_scores = []

    for f in range(N_SPLITS):
        tr_mask, va_mask = folds != f, folds == f
        model = LGBMClassifier(**params).fit(
            X.filter(tr_mask).to_pandas(), y[tr_mask], categorical_feature=cat_cols
        )
        oof[va_mask] = np.asarray(model.predict_proba(X.filter(va_mask).to_pandas()))[:, 1]
        test_pred += np.asarray(model.predict_proba(X_test.to_pandas()))[:, 1] / N_SPLITS
        fold_scores.append(roc_auc_score(y[va_mask], oof[va_mask]))

    return oof, test_pred, fold_scores


results = {}
seed_fold_scores = {}   # グラフ用に、シードごとの Fold 別スコアも残す
for seed in (42, 0, 7):
    oof_s, _, _fs = run_cv(seed)
    results[seed] = roc_auc_score(y, oof_s)
    seed_fold_scores[seed] = _fs
    print(f"  seed={seed}: OOF {results[seed]:.6f}")

vals = list(results.values())
print(f"  揺らぎ幅(max-min): {max(vals) - min(vals):.6f}")
print(f"  std             : {np.std(vals):.6f}")
次に、Fold ごとのスコアをシード別の印で並べる。
_fig, _ax = plt.subplots(figsize=(7, 3.8))
for _seed, _mk, _color in zip(seed_fold_scores, ["o", "s", "^"], ["#4C72B0", "#C44E52", "#55A868"]):
    _ax.plot(range(N_SPLITS), seed_fold_scores[_seed], _mk, color=_color,
             fillstyle="none", markeredgewidth=1.5, markersize=9, label=f"seed={_seed}")
_ax.set_xticks(range(N_SPLITS), [f"fold{_i}" for _i in range(N_SPLITS)])
_ax.set_ylabel("ROC AUC")
_ax.set_title("fold-to-fold vs seed-to-seed", fontweight="bold")
_ax.legend()
_ax.grid(axis="y", linestyle=":", alpha=0.6)
_fig.tight_layout()
_figrun_cv(seed, **overrides) | 3-4 のループを関数にしたもの。固定した folds で 5-Fold CV を回し、OOF・test 予測・Fold 別スコアを返す。overrides でパラメータを上書きできる |
|---|---|
random_state= / seed= | モデル側の乱数シード。ここだけを変える |
max(vals) - min(vals) | シード間の最大差(揺らぎ幅)を計算する |
np.std(values) | シード間のばらつき(標準偏差)を計算する |
ax.plot(x, y, "s", fillstyle="none") | 印の形("o" 丸・"s" 四角・"^" 三角)を変え、中を塗らずに描く。重なっても全部の印が見える |
結果
  seed=42: OOF 0.960379
  seed=0: OOF 0.960430
  seed=7: OOF 0.960541
  揺らぎ幅(max-min): 0.000163
  std             : 0.000068
シードだけを変えたときの揺らぎ幅は 0.000163、標準偏差は 0.000068 であった。
Fold 間の標準偏差 0.000631(3-4)と、シード間の揺らぎ幅 0.000163(標準偏差 0.000068)は別物である。特徴量やパラメータのよしあしを判定するときは Fold 分割を固定して比べるので、使う基準はシード間の揺らぎ幅 0.000163 のほうである。これを切り上げて、S6E8 では「AUC が +0.000200 以上動いたら意味のある変化、それ未満は誤差」と判断し、+0.000200 を採択の閾値にする。0.000163〜0.000200 の間は保留帯とする。ただしシード 3 個ぶんの推定なので、この値自体にも幅がある点に注意が必要である。
- このグラフを使う理由
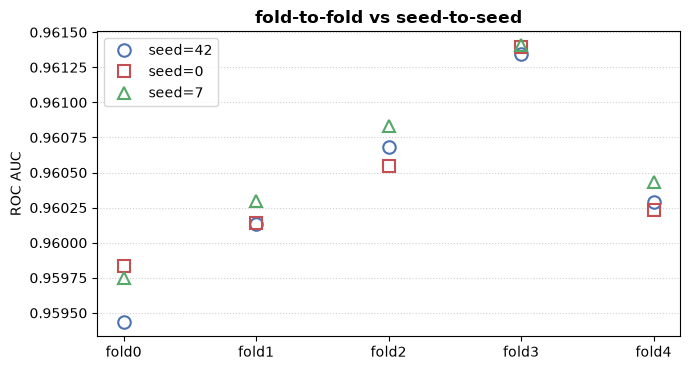
- シードによる揺れと分割による揺れは、どちらも数字 1 つにまとめると区別がつかない。Fold を横軸に、シードを印の形にして 1 枚に並べると、2 つの揺れの大きさを同じ縦軸で比べられる。
- 何を見るか
- 同じ Fold の中で印がどれだけ離れているか(シードによる揺れ)と、Fold どうしで高さがどれだけ違うか(分割による揺れ)。前者が後者より小さければ、印は Fold ごとにまとまる。
- 見方
- 横軸は Fold、縦軸は ROC AUC。印の形がシード(丸が 42、四角が 0、三角が 7)である。
図 3.4 で Fold ごとに見ると、シードによる揺れは 0.000060〜0.000402 である。最も大きい fold0 では、seed=42 の 0.959435 と seed=0 の 0.959837 で 0.000402 違う。それでも、Fold どうしの差(3 シードの平均で、最も低い fold0 と最も高い fold3 の差が 0.001712)よりは小さく、点は Fold ごとにまとまっている。OOF 全体のスコアは 5 Fold の予測をまとめて 1 つの AUC にするので、Fold ごとの揺れの一部が打ち消し合い、シード間の差は 0.000163 になる。第4章以降の判定は OOF 全体のスコアで行うので、採択の閾値も OOF 全体のスコアの揺れで決めた。
次の 3-6 では、評価指標がこのコンペと違う場合に、ここまでの手順のどこを変えるかを見る。
3-6評価指標が違うとき(Accuracy で 0/1 を提出する)
次にやること
S6E8 の指標は ROC-AUC で、確率をそのまま提出した。コンペによって指標は違い、それによって提出する値の形と手元での計算が変わる。Titanic は Accuracy(正解率)で、0 か 1 のラベルを提出する。
理由
指標は最初に確認する:確率を出すべきところで 0/1 を出したり、その逆をしたりすると、モデルが良くてもスコアは大きく下がる。コンペの Evaluation ページと sample_submission.csv の値の形を最初に確認する。
| 評価指標 | 提出するもの/手元での計算/ダミーの基準 |
|---|---|
| ROC-AUC(S6E8) | 確率/roc_auc_score(y, p)/0.5 |
| Accuracy(Titanic) | 0/1 のラベル/accuracy_score(y, p > 0.5)/多い方のクラスの割合 |
| logloss | 確率(0 と 1 ちょうどは避ける)/log_loss(y, p)/DummyClassifier(strategy="prior") |
| RMSE(回帰) | 数値/root_mean_squared_error(y, p)/DummyRegressor(strategy="mean")、モデルは LGBMRegressor |
学習は確率で、提出だけラベルにする:Accuracy のコンペでも、モデルは確率を出すように学習させ、最後に閾値 0.5 で 0/1 に変換する。確率のままなら AUC や logloss でも評価できて、改善の判定に使える(Accuracy は数人の当たり外れで動くので、判定には向かない)。
コード
t2_metric.py(準備は 1-3 の囲みの t0_setup.py)
from t0_setup import *
oof = run_cv(X0, y, folds)
print("dummy accuracy (全員 0 と予測):", round(accuracy_score(y, np.zeros(len(y))), 4))
print(f"OOF accuracy (閾値 0.5): {accuracy_score(y, oof > 0.5):.4f}")
print(f"OOF AUC               : {roc_auc_score(y, oof):.4f}")
print(f"OOF logloss           : {log_loss(y, oof):.4f}")
# 提出用: 確率を 0/1 に変換する
pred_label = (oof > 0.5).astype(int)
print("予測ラベルの陽性率:", round(pred_label.mean(), 4))accuracy_score(y, oof > 0.5) | 確率を 0.5 で 0/1 に変えてから正解率を計算する |
|---|---|
log_loss(y, oof) | 確率のずれを測る指標。小さいほど良い |
(oof > 0.5).astype(int) | 提出用に 0/1 の整数へ変換する |
結果
dummy accuracy (全員 0 と予測): 0.6162
OOF accuracy (閾値 0.5): 0.8204
OOF AUC               : 0.8736
OOF logloss           : 0.5415
予測ラベルの陽性率: 0.3659
全員「死亡(0)」と答えるだけで Accuracy は 0.6162 である。これが Titanic の床で、S6E8 の AUC 0.5 にあたる。LightGBM は 0.8204 で、床を大きく超えている。
ただし logloss 0.5415 は、木を増やしすぎたことによる悪化を含んでいる。ここでは run_cv の既定の 500 本で回したが、1-3 の囲みで決めた N = 67 本にすると logloss は 0.3994 になる。提出するときは (oof > 0.5).astype(int) と同じ変換を test の予測にかける。
S6E8 に戻り、3-7 で提出ファイルを作る。
3-7提出ファイルを作り、検証する
次にやること
3-4 で test への予測 test_pred ができ、3-5 までで基準値と閾値もそろった。次は sample_submission.csv とまったく同じ形式の CSV を作る。保存する前に、必ず自動チェック(assert)を通す。最後に、提出する値の分布を OOF 予測の分布と重ねて、確率として自然な形かを目で確かめる。
理由
提出の失敗はほぼ 4 種類で、目視では見つからない:提出の失敗は、① 行数のずれ、② 列名・ID の順序の違い、③ 確率とラベルの取り違え、④ NaN の混入のどれかがほとんどである。数十万行のファイルでは、目で見ても見つからない。6 つの assert を書けば、以降このコンペで提出ミスはまず起きなくなる。
NaN は null とは別に調べる:Polars では、欠損(null)と NaN(数値の計算で出る「数ではない値」)は別物である。null_count() は NaN を数えず、min() と max() も NaN を飛ばして計算する。実際に [0.2, NaN, 0.9] という列で試すと、null の数は 0、最小値 0.2・最大値 0.9 となり、NaN が混じっていても null と値の範囲のチェックは通ってしまう。そこで is_nan() で NaN を別に調べる。inf(無限大)は 1 より大きいので、値の範囲のチェックで止まる。
関数にして使い回す:チェックを check_submission という関数にすると、第7章の最終提出(7-5)でも同じチェックをそのまま呼べる。次のコンペにもそのまま持っていける部品である。
提出する値の分布を OOF と比べる:assert は「形式が正しいか」を調べるが、「中身がもっともらしいか」は調べない。test の予測は、train の OOF 予測と同じモデルが同じ分布のデータに出したものなので、2 つの分布はほぼ同じ形になるはずである。形が大きく違えば、test 側だけ前処理が違う、列の順番がずれているなどを疑う。0 と 1 の 2 か所にしか値がなければ、確率ではなくラベルを出している。
コード
def check_submission(sub: pl.DataFrame, sample: pl.DataFrame) -> None:
    """提出ファイルを sample_submission と比べる。おかしければ AssertionError で止める。"""
    assert sub.height == sample.height, f"行数不一致: {sub.height} != {sample.height}"
    assert sub.columns == sample.columns, f"列名不一致: {sub.columns}"
    assert sub[ID].equals(sample[ID]), "ID の順序が sample と一致しません"
    assert sub[TARGET].null_count() == 0, "欠損 (null) があります"
    assert not sub[TARGET].is_nan().any(), "NaN があります"
    assert sub[TARGET].is_between(0.0, 1.0).all(), "確率が範囲外です"

sub = pl.DataFrame({ID: test[ID], TARGET: test_pred})
check_submission(sub, submission)
sub.write_csv(SUBMISSIONS_DIR / "03_baseline_lgbm.csv")
print(sub.head(3))
print("rows:", sub.height, " null:", sub[TARGET].null_count(),
      " 値の範囲:", round(sub[TARGET].to_numpy().min(), 4), "〜", round(sub[TARGET].to_numpy().max(), 4))
次に、提出する値(test)と OOF 予測(train)の分布を重ねる。
_fig, _ax = plt.subplots(figsize=(7, 3.8))
# bins=50, range=(0, 1) で、train と test の両方を同じ 0〜1 の 50 区間に分ける
_ax.hist(oof, bins=50, range=(0, 1), density=True, alpha=0.5, color=C_TRAIN, label="train (OOF)")
_ax.hist(sub[TARGET], bins=50, range=(0, 1), density=True, alpha=0.5, color=C_TEST, label="test (submission)")
_ax.set_xlabel("predicted probability")
_ax.set_ylabel("density")
_ax.legend(loc="upper left")
_ax.grid(True, linestyle=":", alpha=0.5)
_fig.tight_layout()
_figpl.DataFrame({...}) | 辞書から Polars の DataFrame を作る |
|---|---|
df.write_csv(path) | CSV に出力する。index 列は付かない |
check_submission(sub, sample) | 下の 6 つのチェックをまとめた自作関数。sample には 3-1 で sample_sub_raw から作った submission を渡す |
assert sub.height == sample.height | 行数が一致するか確かめる(欠落や重複を防ぐ) |
assert sub.columns == sample.columns | 列名と列の順序が一致するか確かめる |
assert sub[ID].equals(sample[ID]) | ID の並び順が一致するか確かめる |
assert sub[TARGET].null_count() == 0 | 欠損が 1 つでもあると提出が弾かれるので確かめる |
assert not sub[TARGET].is_nan().any() | NaN が 1 つもないか確かめる(null_count() では数えられない) |
assert sub[TARGET].is_between(0.0, 1.0).all() | 確率が 0〜1 に収まっているか確かめる(inf もここで止まる) |
bins=50, range=(0, 1) | 0〜1 を 50 区間に等分する。train と test で同じ区切りを使う |
ax.hist(値, bins=..., density=True, alpha=0.5) | ヒストグラムを描く。density=True で面積を 1 にそろえ、行数の違う train と test の形を比べる。半透明にして重ねる |
結果
┌────────┬────────────────┐
│ id     ┆ addicted_label │
╞════════╪════════════════╡
│ 691369 ┆ 0.998035       │
│ 691370 ┆ 0.969395       │
│ 691371 ┆ 0.950725       │
└────────┴────────────────┘
rows: 296302  null: 0  値の範囲: 0.0007 〜 1.0
check_submission の 6 つのチェックをすべて通り、296,302 行の提出ファイルが保存された。行数は 1-1 で控えた test の行数と一致し、欠損と NaN は 0、予測値は 0.0007〜1.0 の範囲に収まっている。列は id と addicted_label で、値はラベルではなく確率である。このファイルを提出すれば、最初の提出が完了する。
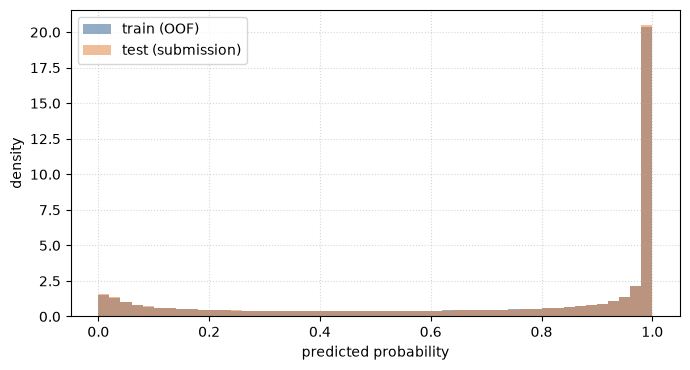
- このグラフを使う理由
- assert は形式しか調べない。中身がもっともらしいかは、提出する値の分布を、同じモデルの OOF 予測の分布と比べると分かる。行数が違うので、面積 1 にそろえたヒストグラムを重ねる。
- 何を見るか
- 2 つの分布がほぼ重なるか。形が大きく違えば、test 側だけ前処理や列の順番が違う疑いがある。0 と 1 の 2 か所だけに棒があれば、確率ではなくラベルを出している。
- 見方
- 横軸は予測確率、縦軸は密度。紺が train の OOF 予測、オレンジが提出する test の予測である。
図 3.5 の紺(OOF 予測)とオレンジ(提出する test の予測)のヒストグラムは、ほぼ重なる。どちらも 1 の近くに高い山があり、0 の近くに低い山がある。0〜1 の間にも値が切れ目なく並んでいて、ラベルではなく確率を出していることがグラフでも確かめられた。
次の 3-8 では、ここまでの結果を実験記録のファイルに残す。
3-8結果を記録する
次にやること
前の節で最初の提出ファイルができた。最後に、この実験の結果を results/experiments.csv に 1 行追記する。1 行を 1 実験とし、以降の実験も同じファイルに足していく。ノートブックの出力は再起動すると消えるが、このファイルは残る。
理由
「何をやったらどうなったか」を忘れないため:コンペが進むと実験は数十件になる。記録がないと「あの設定のスコアはいくつだったか」を再実行して確かめることになり、そこで時間を失う。1 実験ごとに OOF スコアと標準偏差を 1 行追記する習慣が、あとで結果を再現するときの助けになる。
CV と Public LB の関係を追う:記録するのは主に CV スコア・Fold 間標準偏差・使った特徴量・パラメータ・Public LB の 5 つである。特に CV と LB の差を毎回記録すると、「CV は上がったのに LB は下がる」という過学習の兆しに早く気づける。
コード
# RESULTS_DIR は 3-1 で定義した results フォルダー
_log_path = RESULTS_DIR / "experiments.csv"

_row = pl.DataFrame({
    "exp": ["03_baseline"],
    "features": ["baseline_12"],
    "model": ["lgbm"],
    "params": ["lr0.05_n500"],
    "cv_auc": [round(roc_auc_score(y, oof), 6)],
    "cv_std": [round(float(np.std(fold_scores)), 6)],
    "public_lb": [None],
    "note": ["基準値"],
})

if _log_path.exists():
    # 同じ実験名(exp)の行は置き換える。marimo がこのセルを再実行しても行は増えない
    _old = pl.read_csv(_log_path).filter(~pl.col("exp").is_in(_row["exp"].to_list()))
    _row = pl.concat([_old, _row], how="diagonal_relaxed")
_row.write_csv(_log_path)
print(_row)pl.DataFrame({...}) | 1 実験の結果を 1 行の DataFrame として作る |
|---|---|
df.filter(~pl.col("exp").is_in(_row["exp"].to_list())) | 同じ実験名の古い行を除く(~ は「でない」) |
pl.concat([old_df, new_row], how="diagonal_relaxed") | 既存の記録に追記する(新しい列が増えても結合できる) |
df.write_csv(path) | ファイルに保存する |
結果
┌─────────────┬─────────────┬───────┬─────────────┬──────────┬──────────┬───────────┬────────┐
│ exp         ┆ features    ┆ model ┆ params      ┆ cv_auc   ┆ cv_std   ┆ public_lb ┆ note   │
╞═════════════╪═════════════╪═══════╪═════════════╪══════════╪══════════╪═══════════╪════════╡
│ 03_baseline ┆ baseline_12 ┆ lgbm  ┆ lr0.05_n500 ┆ 0.960379 ┆ 0.000631 ┆ null      ┆ 基準値 │
└─────────────┴─────────────┴───────┴─────────────┴──────────┴──────────┴───────────┴────────┘
results/experiments.csv に、LightGBM のベースライン(3-4)の 1 行が記録された。CV AUC 0.960379・Fold 間標準偏差 0.000631 である。Public LB の欄は、提出してスコアが返ってきたら埋める。以降の章でも、結果が確定するたびにこのファイルに 1 行ずつ足していく(4-10・5-7・6-7・7-7)。marimo は上流のセルが変わると記録のセルも自動で再実行するので、同じ実験名(exp)の行は消してから足す。こうすると、何度実行しても 1 実験は 1 行のままである。実験名とファイル名の先頭の番号は、それを作った章の番号である(03_baseline は第3章、07_submission_conservative.csv は第7章)。
これで第3章のゴールである基準値 0.960379 と、採択の閾値 +0.000200(3-5 のシード間の揺らぎ幅 0.000163 を切り上げたもの)がそろった。
次の第4章では、特徴量を 1 つずつ加えて確かめていく(アブレーション実験)。採択した特徴量セットの結果は、4-10 でこの表に 1 行足す。3-4 の 0.960379 と 3-5 の閾値 +0.000200 が、その判定の基準になる。