CH 5パラメータを調整する(Optuna)
第4章で、特徴量セット features_v1(14 列)と、その OOF AUC 0.960856 が確定した。この章では、この値を新しい基準値にして、LightGBM のパラメータを Optuna で調整する。第3・4章では木の数を 500 本に固定してきたが、この章からは木の数も early stopping で決める。目的は、当てずっぽうに何百回も試すことではない。計算にかかる時間を見積もって、軽い設定の「探索」と全データでの「確認」を分け、改善が本物かどうかを確かめる。最後に、採用したパラメータを設定ファイルに保存して第6章に渡す。
5-1チューニングの前に基準値と打ち切り条件を決める
次にやること
第4章で、特徴量セット features_v1 の OOF AUC 0.960856 が確定した。パラメータを動かす前に、何と比べるか(基準値)と、どこでやめるか(試行回数)を決める。この章も新しいノートブックで始めるので、ライブラリと、第4章で保存したデータの読み込みから書く。
理由
やめどきを先に決める:目標や停止条件を決めずに Optuna を回すと、時間と計算資源をいくらでも使ってしまう。そこで費用対効果を考えて、「25 試行でよい領域をつかむ」という上限を決める。
判定のしかたは第4章と同じ:第4章と同じく、ノイズフロア 0.000163 を切り上げた +0.000200 以上の改善を採択の境界にする。変えるのは基準値だけで、第4章で確定した 0.960856 にする。
保存したものを読み込み、分割と照合する:第4章で保存した features_v1_train.parquet(特徴量 14 列 + id・目的変数・fold)と、第2章で保存した folds.csv を読み込む。目的変数 y_full と Fold 番号 folds_full は Parquet の中の列から取り、その id と fold が folds.csv と同じ並びかを assert で確かめる。最後に 3 列を落として、特徴量 14 列だけの train_feat を作る。
コード
まず、ライブラリ・定数・データを用意する。
# 使うライブラリを用途ごとに直接インポートする
import json
import time
from pathlib import Path
from typing import Any

import lightgbm as lgb
import matplotlib.pyplot as plt
import numpy as np
import optuna
import polars as pl
from lightgbm import LGBMClassifier
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold

# Optuna のログ出力を静かにする
optuna.logging.set_verbosity(optuna.logging.WARNING)

# データの置き場所と定数を1か所で定義する
PROJECT = Path(r"D:\kaggle\smartphone-addiction_s6e8")   # データの置き場所。自分の環境に合わせて書き換える
PROCESSED_DIR = PROJECT / "data" / "processed"
CONFIGS_DIR = PROJECT / "configs"
RESULTS_DIR = PROJECT / "results"

ID = "id"
TARGET = "addicted_label"

for _d in (CONFIGS_DIR, RESULTS_DIR):
    _d.mkdir(parents=True, exist_ok=True)

# 第4章で保存した特徴量 Parquet(id・目的変数・fold つき)と固定分割 folds.csv を読み込む
train_all = pl.read_parquet(PROCESSED_DIR / "features_v1_train.parquet")
folds_df = pl.read_csv(PROCESSED_DIR / "folds.csv")

# 第2章の分割と、行ごとに同じ並びかを確かめる
assert train_all[ID].equals(folds_df[ID]), "id の並びが folds.csv と一致しません"
assert train_all["fold"].equals(folds_df["fold"]), "fold が folds.csv と一致しません"

y_full = train_all[TARGET].to_numpy()
folds_full = train_all["fold"].to_numpy()
train_feat = train_all.drop([ID, TARGET, "fold"])  # 特徴量 14 列だけにする
# カテゴリ列は型から決める(Parquet は第4章の Enum 型をそのまま保っている)。LightGBM に categorical_feature で渡す
cat_cols = [c for c, dt in train_feat.schema.items() if not dt.is_numeric()]次に、基準値と判定ルールを決める。evaluate_change は 4-2 と同じ関数で、基準値だけを変えている。
BASE_AUC = 0.960856
NOISE_FLOOR = 0.000163
THRESHOLD = 0.000200
MIN_BETTER_FOLDS = 4

def evaluate_change(new_auc: float, n_better: int | None = None, base_auc: float = BASE_AUC):
    """基準との差と判定を返す。n_better は基準より良くなった Fold の数で、None のときは Fold の条件を見ない。"""
    diff = new_auc - base_auc
    folds_ok = n_better is None or n_better >= MIN_BETTER_FOLDS
    if diff >= THRESHOLD and folds_ok:
        verdict = f"[採択] (有意な改善: +{THRESHOLD:.6f} 以上)"
    elif diff >= THRESHOLD:
        verdict = f"[保留] (閾値以上だが改善 Fold が {MIN_BETTER_FOLDS} 未満)"
    elif diff > NOISE_FLOOR:
        verdict = "[保留] (ノイズフロア超えだが閾値未満)"
    elif diff > 0:
        verdict = "[不採択] (ノイズフロア未満の微増 / 誤差)"
    elif diff == 0:
        verdict = "[不採択] (スコア変動なし)"
    else:
        verdict = "[不採択] (スコア悪化)"
    return diff, verdict

diff, verdict = evaluate_change(BASE_AUC)
print(f"基準値(features_v1): {BASE_AUC:.6f} | 差分: {diff:+.6f} | {verdict}")pl.read_parquet(path) | 第4章で作成した特徴量 Parquet を読み込む |
|---|---|
s.equals(other) | 2 つの列が同じ順番・同じ値かを確かめる。id と fold を folds.csv と照合する |
df.drop([ID, TARGET, "fold"]) | 特徴量ではない 3 列を外し、学習に使う 14 列だけにする |
evaluate_change(new_auc, n_better, base_auc) | 基準値との差分(ΔAUC)を算出し判定結果を返す自作関数(4-2 と同じ) |
結果
基準値(features_v1): 0.960856 | 差分: +0.000000 | [不採択] (スコア変動なし)
基準値そのものを渡したので差分は 0 で、「スコア変動なし」と判定された。これで、この章の探索結果を 0.960856 と比べて判定する準備ができた。試行回数は 25 回、採択の境界は +0.000200 である。
次の 5-2 では、1 回の CV にかかる時間から探索のコストを見積もり、探索を軽くする方法を決める。
5-2探索のコストを見積もり、軽くする
次にやること
5-1 で、基準値 0.960856 と試行回数 25 回を決めた。次は、探索にかかる時間を見積もり、探索用に軽くしたデータと分割を作る。
理由
全データでは時間がかかる:全 691,369 行で 5-Fold CV を回すと、木 500 本の固定でも 1 回に約 20 秒かかる。この章では木の数を early stopping で決めるので(5-3)、木が数千本になれば 1 回はさらに長くなる。全データで 25 試行回すと、1 時間を超えてもおかしくない。
2 段構えにする:そこで「探索フェーズ(データの 30% / 3-Fold CV で 25 試行)」と「確認フェーズ(全データ / 固定 5-Fold)」の 2 段に分ける。
探索と確認を分ける理由:探索に使った分割で最終評価まですると、その分割にたまたま合ったパラメータが選ばれ、スコアが楽観的に偏る(探索バイアス)。軽い設定での良し悪しの順位は、本番設定でもおおむね保たれる。そこで、探索で大まかによい領域を見つけ、最後に本番設定で本当の性能を測る。
乱数を固定する:サブサンプルはシード 42 で固定し、何度実行しても同じ行が選ばれるようにする。探索用の 3-Fold は StratifiedKFold で、各 Fold の陽性率をそろえる。
コード
# 再現性のためシードを固定して 30% サブサンプルを作成
np.random.seed(42)
n_total = len(y_full)
sample_idx = np.random.choice(n_total, size=int(n_total * 0.3), replace=False)
sample_idx.sort()

X_sub = train_feat[sample_idx]
y_sub = y_full[sample_idx]

# 探索用 3-Fold
skf_3 = StratifiedKFold(n_splits=3, shuffle=True, random_state=42)
sub_folds = list(skf_3.split(X_sub, y_sub))

print(f"本番データ: {n_total:,} 行 (5-Fold)")
print(f"探索データ: {len(y_sub):,} 行 (30% サブサンプル, 3-Fold)")np.random.choice(n, size=..., replace=False) | 再現性のある乱数シード固定サブサンプリング |
|---|---|
StratifiedKFold(n_splits=3, shuffle=True, ...) | 探索フェーズ用の軽量 3-Fold CV 分割 |
結果
本番データ: 691,369 行 (5-Fold)
探索データ: 207,410 行 (30% サブサンプル, 3-Fold)
探索には 691,369 行のうち 207,410 行(30%)を使い、3-Fold で評価する。1 試行あたりの学習データが減り、Fold の数も 5 から 3 に減るので、探索 1 回の時間を大きく短くできる。本番の 5-Fold(folds_full)は、5-5 の確認フェーズまで使わない。
次の 5-3 では、この X_sub と sub_folds を使って、Optuna が試行ごとに呼び出す目的関数(objective function)を書く。
5-3Optuna の目的関数を書く
次にやること
5-2 で、探索用のデータ X_sub と 3-Fold の分割 sub_folds ができた。次は、Optuna が 1 回の試行ごとに呼び出す目的関数 objective を書き、どのパラメータをどの範囲で探すかを決める。木の数は探さずに、試行ごとに early stopping で決める。
理由
範囲は意味を理解して決める:パラメータの意味を理解しないまま探索範囲を広げると、探索がまとまらず、よい解にたどり着けない。探すパラメータは、次の 3 つの役割に分けられる。範囲はデフォルト値を中心に、極端な過学習や学習不足にならない現実的な領域に絞る。
① 木の複雑さ:num_leaves(15〜127)は決定木の葉の最大数で、表現力を左右する最も重要なパラメータである。max_depth(3〜10)と min_child_samples(20〜300)は、深すぎる分岐や、データの少なすぎる葉を抑え、過学習を防ぐ。
② 多様性(サンプリング):subsample(0.6〜1.0)は行のサンプリング率、colsample_bytree(0.6〜1.0)は列のサンプリング率である。木ごとに違うデータ・特徴量を見せることで、特徴量どうしの相関の影響を弱め、木を多様にする。
③ 正則化(regularization):reg_alpha(1e-3〜10.0)と reg_lambda(1e-3〜10.0)は L1/L2 正則化である。不要な分岐の重みを 0 に近づけ、極端な予測値を抑える。桁が大きく変わる値なので、log=True で対数スケールで探す。
木の数は固定せず、early stopping で決める:ちょうど良い木の数は、num_leaves や max_depth と連動して変わる。浅い木なら多くの木が要り、深い木なら少なくて済む。木の数を 500 本に固定すると、「500 本のときに最も良い設定」を探すことになり、浅い木の設定が不当に低く評価される。そこで、検証側のスコアが良くならなくなったところで木を足すのをやめる early stopping を使う。検証 Fold のスコアが 100 本続けて良くならなければ止め(lgb.early_stopping(100))、止まった本数を trial.set_user_attr で記録する。metric="auc" を指定して、止める判断にもこのコンペの指標を使う。
学習率は 0.1、上限は 10000 本:以前に第3・4章と同じ学習率 0.05 で、上限を 5000 本にして試したところ、浅い木の設定では探索中も 5000 本近くまで止まらず、全データでは 5 つの Fold すべてが上限の 5000 本近くまで止まらなかった。上限に当たったままでは、木の数を決めたことにならない。そこで学習率を 0.1 に上げて必要な木の数を減らし、上限は 10000 本にする。学習率 0.1 でも、全データでは 5000 本前後まで伸びる(5-5)。上限に当たっていないかは 5-5 で確かめる。
そのほかに固定するもの:subsample を効かせるために subsample_freq=1 も固定する。固定する値は FIXED にまとめて、5-5 でも同じものを使う。pandas への変換 X_sub.to_pandas() は目的関数の外で 1 回だけ行い、試行ごとに繰り返さないようにする。
コード
X_sub_pd = X_sub.to_pandas()

# 探索でも本番でも固定する値(型の違う値が混ざるので dict[str, Any])
FIXED: dict[str, Any] = {
    "learning_rate": 0.1,
    "n_estimators": 10000,   # 上限。実際の本数は early stopping で決まる
    "metric": "auc",
    "random_state": 42,
    "verbose": -1,
    "subsample_freq": 1,
}

def objective(trial: optuna.Trial) -> float:
    params: dict[str, Any] = {
        **FIXED,
        "num_leaves": trial.suggest_int("num_leaves", 15, 127),
        "max_depth": trial.suggest_int("max_depth", 3, 10),
        "min_child_samples": trial.suggest_int("min_child_samples", 20, 300),
        "subsample": trial.suggest_float("subsample", 0.6, 1.0),
        "colsample_bytree": trial.suggest_float("colsample_bytree", 0.6, 1.0),
        "reg_alpha": trial.suggest_float("reg_alpha", 1e-3, 10.0, log=True),
        "reg_lambda": trial.suggest_float("reg_lambda", 1e-3, 10.0, log=True),
    }
    val_scores, best_iters = [], []
    for tr_idx, va_idx in sub_folds:
        X_va, y_va = X_sub_pd.iloc[va_idx], y_sub[va_idx]
        model = LGBMClassifier(**params).fit(
            X_sub_pd.iloc[tr_idx], y_sub[tr_idx],
            categorical_feature=cat_cols,
            eval_X=(X_va,), eval_y=(y_va,),
            callbacks=[lgb.early_stopping(100, verbose=False)],
        )
        val_scores.append(roc_auc_score(y_va, np.asarray(model.predict_proba(X_va))[:, 1]))
        best_iters.append(model.best_iteration_)
    trial.set_user_attr("best_iters", best_iters)
return float(np.mean(val_scores))trial.suggest_int(name, low, high) | 整数パラメータのサンプリング(木の葉数や深さなど) |
|---|---|
trial.suggest_float(name, low, high, log=) | 実数パラメータのサンプリング(サンプリング率や正則化項など) |
fit(..., eval_X=(X_va,), eval_y=(y_va,)) | 検証データを渡す(LightGBM 4.7 の書き方。古い eval_set は非推奨) |
lgb.early_stopping(100, verbose=False) | 100 本続けて検証スコアが良くならなければ止める |
model.best_iteration_ | 検証スコアが最も良かった木の数。予測にもこの本数が使われる |
trial.set_user_attr(name, value) | 試行ごとの追加情報(ここでは止まった木の数)を記録する |
結果
このセルは関数を定義するだけで、出力はない。
objective は、trial からパラメータを 1 組受け取り、探索用の 3-Fold で LightGBM を学習して、3 つの Fold の AUC の平均を返す。木の数は Fold ごとに early stopping で決まり、その本数は試行の記録に残る。5-4 では、Optuna がこの関数を 25 回呼び出し、返り値が大きくなるパラメータを探していく。
次の 5-4 では、この目的関数を使って、実際に 25 試行の探索を実行する。
5-4LightGBM のパラメータを探索する
次にやること
5-3 で目的関数ができた。次は TPESampler を使って 25 試行の探索を実行し、かかった時間、探索スコア、最良のパラメータと、そのとき止まった木の数を記録する。最後に、試行ごとのスコアの推移と、パラメータとスコアの関係をグラフにする。
理由
TPE を使う:TPE(Tree-structured Parzen Estimator)サンプラーは、過去の試行結果から「よいスコアが出た領域」と「悪いスコアが出た領域」の分布を推定し、有望な領域を優先して試す。ランダムサーチやグリッドサーチに比べ、25 試行という少ない回数でも最適解の近くを効率よく探せる。ただし、推定の材料がない最初のうちはランダムに選ぶ。Optuna の TPESampler は、既定では最初の 10 試行(trial 0〜9)をランダムに選び(n_startup_trials=10)、11 試行目(trial 10)から過去の結果を使って絞り込む。
時間を測る:探索にかかった時間を time.time() で測る。5-6 で、チューニングにかかる時間の目安になる。
履歴を残す:全試行の履歴を results/05_optuna_trials.csv に保存する。set_user_attr で記録した木の数も列として入るので、あとから、どのパラメータで何本の木が要ったかを見直せる。
25 試行で足りたかを見る(探索の推移):試行ごとのスコアと、それまでの最高値を並べる。最高値が早い試行で頭打ちになっていれば、試行を増やしても伸びる余地は小さい。最後の数試行でまだ伸びていれば、試行が足りない。
どのパラメータが効いたかを見る:パラメータごとに、横軸にその値、縦軸に探索スコアを取って 25 試行を点で打つ。値によって点の高さがはっきり変わるパラメータはスコアに効いていて、高さがばらばらなパラメータはあまり効いていない。対数の範囲で探した reg_alpha・reg_lambda は、横軸も対数にする。最後の枠には、止まった木の数(3 Fold の中央値)とスコアの関係も並べる。
コード
sampler = optuna.samplers.TPESampler(seed=42)
study = optuna.create_study(direction="maximize", sampler=sampler)

_t0 = time.time()  # 時間計測用の変数は、セルの中だけの名前にする
study.optimize(objective, n_trials=25)
tuning_time = time.time() - _t0

print(f"探索完了: 25 試行 / 所要時間: {tuning_time:.1f} 秒 ({tuning_time/60:.1f} 分)")
print(f"Best Trial #{study.best_trial.number}: 探索スコア AUC = {study.best_value:.6f}")
print(f"止まった木の数 (3 Fold): {study.best_trial.user_attrs['best_iters']}")
print("Best Parameters:")
for k, v in study.best_params.items():
    print(f"  {k}: {v:.6f}" if isinstance(v, float) else f"  {k}: {v}")

trials_df = study.trials_dataframe()
trials_csv = RESULTS_DIR / "05_optuna_trials.csv"
trials_df.to_csv(trials_csv, index=False)
print(f"saved trials: {trials_csv}")
次に、試行ごとのスコアと、それまでの最高値の推移を描く。
_df = trials_df.sort_values("number")

_fig, _ax = plt.subplots(figsize=(8, 3.8))
_ax.plot(_df["number"], _df["value"], "o", color="#4A90E2", alpha=0.75, markersize=8, label="each trial")
_ax.step(_df["number"], np.maximum.accumulate(_df["value"]), where="post", color="#C44E52",
         linestyle="--", linewidth=2.5, label="best so far")
_ax.plot(study.best_trial.number, study.best_value, "*", color="#C44E52", markeredgecolor="black", markersize=15,
         label=f"best: trial {study.best_trial.number} ({study.best_value:.6f})")
_ax.set_xlabel("trial number")
_ax.set_ylabel("search AUC (30% / 3-fold)")
_ax.legend(loc="lower right")
_ax.grid(True, linestyle=":", alpha=0.6)
_fig.tight_layout()
_fig
最後に、パラメータごとにスコアとの関係を並べる。最良の試行は星で示す。
_params = ["num_leaves", "max_depth", "min_child_samples", "subsample",
           "colsample_bytree", "reg_alpha", "reg_lambda"]
_df = trials_df.assign(trees=trials_df["user_attrs_best_iters"].apply(np.median))   # 止まった木の数(3 Fold の中央値)
_best = _df.loc[_df["value"].idxmax()]

_fig, _axes = plt.subplots(2, 4, figsize=(16, 6.5), sharey=True)
for _ax, _c in zip(_axes.ravel(), [f"params_{_p}" for _p in _params] + ["trees"]):
    _ax.plot(_df[_c], _df["value"], "o", color="#55A868", alpha=0.8, markersize=7)
    _ax.plot(_best[_c], _best["value"], "*", color="#C44E52", markeredgecolor="black", markersize=15)
    _ax.grid(True, linestyle=":", alpha=0.5)
    if _c in ("params_reg_alpha", "params_reg_lambda"):
        _ax.set_xscale("log")   # 対数の範囲で探したパラメータは、横軸も対数にする
    _ax.set_xlabel("trees (median of 3 folds)" if _c == "trees" else _c.removeprefix("params_"))
for _ax in _axes[:, 0]:
    _ax.set_ylabel("search AUC")
_fig.tight_layout()
_figoptuna.samplers.TPESampler(seed=42) | ベイズ最適化(Tree-structured Parzen Estimator)のサンプラー。seed で結果を再現できる |
|---|---|
optuna.create_study(direction="maximize", sampler=...) | 目的関数の値を最大化する Study を作る |
study.optimize(objective, n_trials=25) | 指定した試行回数でベイズ最適化を実行 |
study.best_params / study.best_value | 最良試行のパラメータ辞書と検証スコア |
study.best_trial.user_attrs | 最良試行で set_user_attr した値(止まった木の数) |
study.trials_dataframe().to_csv(...) | 全試行の履歴を DataFrame 化して CSV に保存 |
time.time() | 現在時刻(秒)を取得し、差をとって所要時間を測る |
trials_df["number"] / ["value"] / ["params_名前"] | trials_dataframe() の列。試行の番号・探索スコア・その試行のパラメータの値 |
np.maximum.accumulate(a) | 先頭からその位置までの最大値を並べる。「それまでの最高値」の推移になる |
ax.step(x, y, where="post") | 階段状の線を描く。最高値が更新されるまで同じ高さを保つ |
df["value"].idxmax() / df.loc[...] | スコアが最も高い試行の行を取り出す |
plt.subplots(2, 4, sharey=True) | 2 行 4 列の枠を作り、縦軸の範囲を全部の枠でそろえる。パラメータどうしで点の高さを比べられる |
s.removeprefix("params_") | 列名の先頭の params_ を取って、パラメータ名だけにする |
結果
探索完了: 25 試行 / 所要時間: 474.0 秒 (7.9 分)
Best Trial #23: 探索スコア AUC = 0.961898
止まった木の数 (3 Fold): [3037, 3324, 3042]
Best Parameters:
  num_leaves: 27
  max_depth: 3
  min_child_samples: 60
  subsample: 0.906535
  colsample_bytree: 0.863647
  reg_alpha: 0.003028
  reg_lambda: 7.005643
saved trials: D:\kaggle\smartphone-addiction_s6e8\results\05_optuna_trials.csv
25 試行は 474.0 秒(約 7.9 分)で終わった。最良は Trial #23 で、探索スコアは 0.961898 であった。選ばれたのは max_depth 3 の浅い木で、30% のデータでも木は 3037〜3324 本まで伸びている。深さ 3 の木の葉は最大 8 枚なので、num_leaves 27 はここでは効いておらず、木の大きさは max_depth で決まっている。min_child_samples は 60 で範囲(20〜300)の下のほう、reg_lambda は 7.0 と大きく、L2 正則化を強めにかけている。
上位の試行も、ほとんどが深さ 3〜4 の浅い木であった。木の数を 500 本に固定していたら、本数が足りずに低く評価されやすい設定である。
この 0.961898 は、30% のデータと 3-Fold で測った値である。基準値 0.960856 とは測り方が違うので、そのまま比べることはできない。
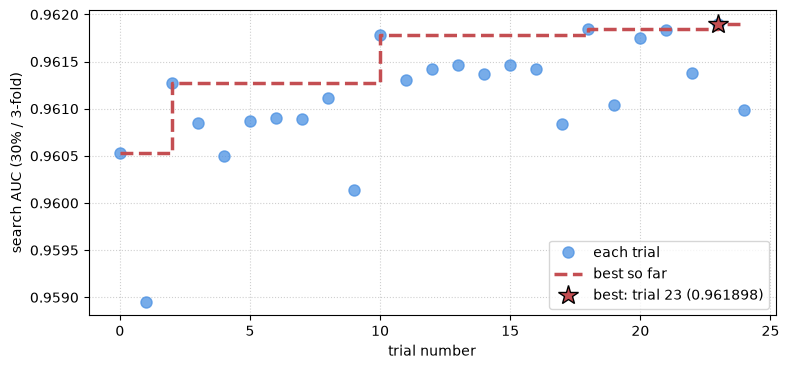
- このグラフを使う理由
- 試行回数(25 回)が足りたかどうかは、最後の最高値だけでは分からない。試行の順にスコアを並べ、それまでの最高値を階段で重ねると、いつ伸びが止まったかが見える。Optuna の「最適化の履歴」(
plot_optimization_history)と同じ考え方の図である。 - 何を見るか
- 階段が最後の数試行でまだ上がっているか。早い段階で平らになっていれば、試行を増やしても伸びる余地は小さい。
- 見方
- 横軸は試行の番号、縦軸は探索スコア(30% のデータ・3-Fold の AUC)。青い点が各試行、赤い点線の階段がそれまでの最高値、赤い星が最良の試行である。
図 5.1 の推移を見ると、最高値は trial 2(0.961275)と trial 10(0.961787)で大きく上がり(trial 10 は、ランダムな 10 試行のあとに TPE が最初に選んだ試行である)、その後は trial 18(0.961850)と trial 23(0.961898)で小さく伸びただけであった。trial 10 から最後までの上積みは 0.000111 である。最後の数試行でもわずかに伸びているので、試行を増やせばもう少し伸びる可能性はあるが、大きく伸びる見込みは小さい。
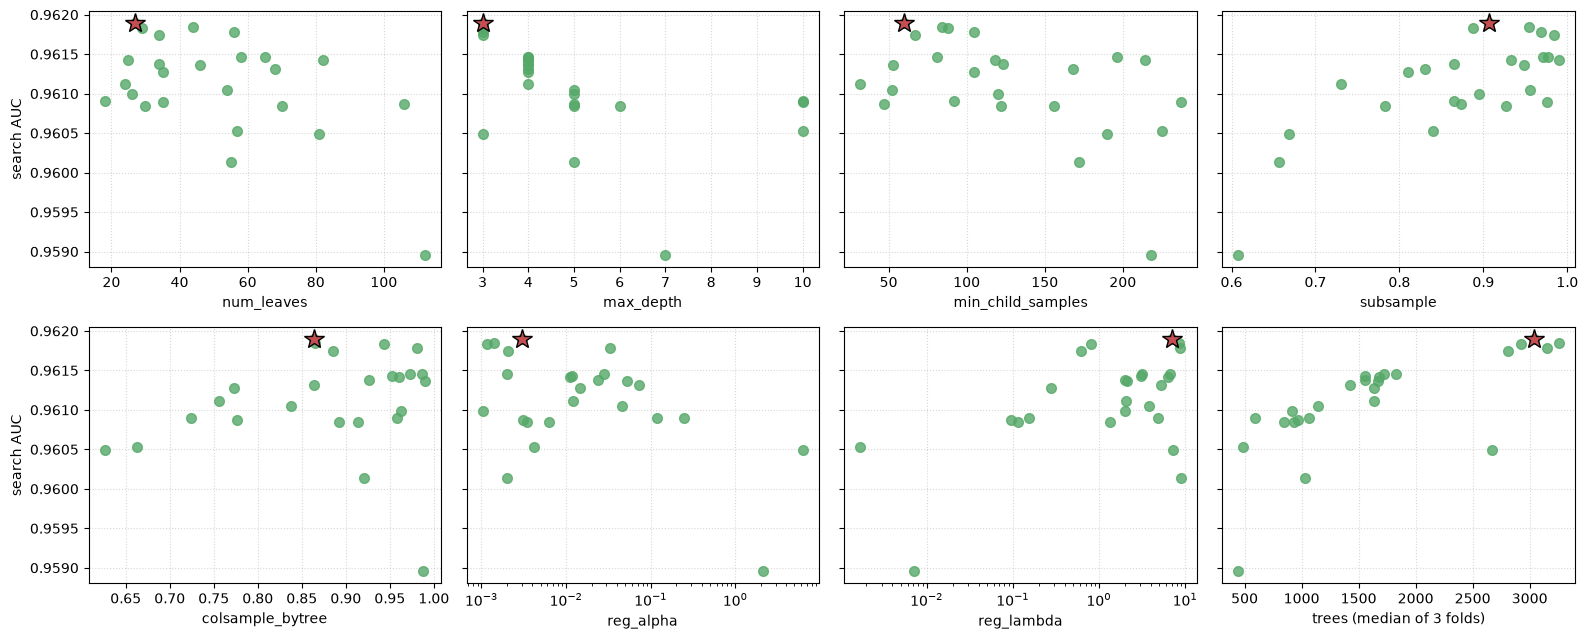
- このグラフを使う理由
- 最良のパラメータの組だけでは、どのパラメータが効いたのかは分からない。パラメータごとに値とスコアを散布図にすると、効き方の強さが点の並び方に表れる。縦軸を全部の枠でそろえ、パラメータどうしで比べられるようにする。
- 何を見るか
- 値によって点の高さがはっきり分かれる枠(効いているパラメータ)と、高さがばらばらな枠(あまり効いていないパラメータ)。効いているパラメータは、次に探索するときに範囲を絞る候補になる。
- 見方
- 1 つの枠が 1 つのパラメータ(最後の枠は止まった木の数)。横軸はその値(
reg_alpha・reg_lambdaは対数)、縦軸は探索スコア。緑の点が 25 試行、赤い星が最良の試行である。
図 5.2 のパラメータごとのグラフで、点の高さがはっきり分かれているのは max_depth だけである。スコアの上位 9 試行はすべて深さ 3〜4 で(上位 5 試行は深さ 3)、深さ 7 以上の 4 試行はどれも 0.960904 以下にとどまる。ほかのパラメータは、同じくらいの値でも点の高さがばらばらで、スコアへの効き方ははっきりしない(subsample は 0.7 未満の試行がやや低い)。止まった木の数の枠では、例外はあるものの、木が多い試行ほどおおむねスコアが高い。浅い木ほど多くの木が要るので、これも深さの効果の表れである。チューニングの効果の大部分は、木を浅くし、そのぶん木の数を増やしたことによると読める。
次の 5-5 では、この最良パラメータを本番設定(全データ・固定 5-Fold)で回し、木の数を決めてから基準値と比べる。
5-5軽い設定の結果を本番設定で確かめる
次にやること
5-4 で最良パラメータと探索スコア 0.961898 が得られた。ただし、これは軽い設定で測った値で、木の数も 30% のデータで止まった本数である。次は本番設定(全 691,369 行・固定 5-Fold)で、①early stopping で木の数を決め、②その本数に固定して回し直し、本当の OOF AUC を測る。
理由
探索スコアはそのまま信じない:探索フェーズのスコア(0.961898)は、軽い設定で測ったうえに探索バイアスを含んでいる。第2章で保存した固定の folds.csv の上で全データを使って測って、はじめて第4章の基準値(0.960856)と比べられる。探索に使った行も OOF に含まれるので、探索バイアスがゼロになるわけではないが、分割とデータ量を変えて測り直すことで小さくなる。
木の数は全データで決め直す:学習データが増えると、過学習が始まるまでに使える木の数も増える。30% のデータで止まった本数をそのまま使うと、全データでは木が足りない。そこで全データの 5-Fold でもう一度 early stopping をかけ、各 Fold で止まった本数を調べる。データが小さいときは逆に、500 本の固定では多すぎることもある(Titanic の囲みの木の数 N = 67 も、この手順で決めた)。
中央値で固定して回し直す:early stopping は検証側のスコアを見て止めるので、そのスコアは、止める判断に使った検証データに少し合わせた甘めの値になる。各 Fold の本数の中央値を「決めた本数」として固定し、early stopping なしでもう一度回したスコアを、より正直な値として使う。
上限に当たっていないか確かめる:止まった本数が上限の 10000 本に張り付いていたら、それは本当に止まったのではなく、上限で打ち切られただけである。その場合は上限を上げるか、学習率を上げて回し直す。
Fold ごとのスコアも見る:OOF AUC だけでなく、Fold ごとの AUC とその標準偏差も出す。特定の Fold だけ高い・低いといった偏りがないかを確かめるためである。標準偏差は final_std として 5-7 で保存する。
コード
X_full_pd = train_feat.to_pandas()
es_params: dict[str, Any] = {**FIXED, **study.best_params}

# 1. 全データの 5-Fold で early stopping をかけ、各 Fold で止まった木の数を調べる
best_iters = []
oof_es = np.zeros(len(y_full))
_t0 = time.time()
for f in range(5):
    tr_mask, va_mask = folds_full != f, folds_full == f
    model = LGBMClassifier(**es_params).fit(
        X_full_pd[tr_mask], y_full[tr_mask],
        categorical_feature=cat_cols,
        eval_X=(X_full_pd[va_mask],), eval_y=(y_full[va_mask],),
        callbacks=[lgb.early_stopping(100, verbose=False)],
    )
    best_iters.append(model.best_iteration_)
    oof_es[va_mask] = np.asarray(model.predict_proba(X_full_pd[va_mask]))[:, 1]
n_fixed = int(np.median(best_iters))
print(f"各 Fold の木の数: {best_iters} → 中央値 {n_fixed} (上限 {FIXED['n_estimators']})")
print(f"early stopping のままの OOF AUC: {roc_auc_score(y_full, oof_es):.6f} ({time.time() - _t0:.1f} 秒)")

# 2. 木の数を中央値に固定し、early stopping なしで回し直す
full_params: dict[str, Any] = {k: v for k, v in es_params.items() if k != "metric"}
full_params["n_estimators"] = n_fixed

oof_full = np.zeros(len(y_full))
fold_scores = []
_t0 = time.time()
for f in range(5):
    tr_mask, va_mask = folds_full != f, folds_full == f
    model = LGBMClassifier(**full_params).fit(
        X_full_pd[tr_mask], y_full[tr_mask], categorical_feature=cat_cols
    )
    oof_full[va_mask] = np.asarray(model.predict_proba(X_full_pd[va_mask]))[:, 1]
    fold_scores.append(roc_auc_score(y_full[va_mask], oof_full[va_mask]))

full_eval_time = time.time() - _t0
final_auc = roc_auc_score(y_full, oof_full)
final_diff, final_verdict = evaluate_change(final_auc)
final_std = float(np.std(fold_scores))

for i, s in enumerate(fold_scores):
    print(f"  fold{i}: {s:.6f}")
print(f"  mean : {np.mean(fold_scores):.6f}  (std {np.std(fold_scores):.6f})")
print(f"  OOF  : {final_auc:.6f}")
print(f"本番確認結果: OOF AUC = {final_auc:.6f} | diff: {final_diff:+.6f} | std: {np.std(fold_scores):.6f} | {final_verdict}")
print(f"本番確認時間: {full_eval_time:.1f} 秒"){**FIXED, **study.best_params} | 固定値と探索結果を 1 つの辞書にまとめる |
|---|---|
np.median(best_iters) | Fold ごとに止まった木の数の中央値を取り、決めた本数にする |
{k: v for k, v in d.items() if k != "metric"} | early stopping 用の metric を除いた辞書を作る |
roc_auc_score(y_full, oof_full) | 本番 5-Fold 全行の OOF 予測に対する ROC-AUC |
結果
各 Fold の木の数: [4807, 5844, 6177, 5268, 5267] → 中央値 5268 (上限 10000)
early stopping のままの OOF AUC: 0.964815 (733.8 秒)
  fold0: 0.963995
  fold1: 0.964791
  fold2: 0.965022
  fold3: 0.965584
  fold4: 0.964572
  mean : 0.964793  (std 0.000522)
  OOF  : 0.964792
本番確認結果: OOF AUC = 0.964792 | diff: +0.003936 | std: 0.000522 | [採択] (有意な改善: +0.000200 以上)
本番確認時間: 142.8 秒
木の数:全データでは、各 Fold の木の数は 4807〜6177 本で止まった。上限の 10000 本からは十分離れているので、本当に止まった本数である。30% のデータで止まった本数(3037〜3324 本)の約 1.4〜2 倍で、データが増えると必要な木も増えることが分かる。中央値の 5268 本を決めた本数にする。
スコア:5268 本に固定して回し直した OOF AUC は 0.964792 で、基準値 0.960856 から +0.003936 上がった。判定閾値 +0.000200 を大きく超えるので [採択] である。early stopping のままのスコア(0.964815)はわずかに高く、理由で述べたとおり少し甘めの値であった。Fold ごとの AUC は 0.963995〜0.965584 で、標準偏差は 0.000522 である。第4章の features_v1 の Fold 別スコア(4-9、最大 0.961794)を、5 つの Fold すべてが上回っている。なお、判定の Fold の条件(n_better)は evaluate_change に渡していないが、この比較で 5 Fold すべての改善を確かめたことになる。
次の 5-6 では、探索スコア 0.961898 と本番スコア 0.964792 の差をどう読むか、そしてチューニングがどれだけ効いたかを整理する。
5-6探索スコアと確認スコアの差を読む
次にやること
5-5 で、本番スコア 0.964792 が得られた。次は、探索スコアと本番スコアを並べて差を読み、チューニングの効果を第4章の特徴量エンジニアリングと比べる。
理由
差を見る理由:探索スコアと本番スコアの差には、探索がうまくいったかどうかが表れる。探索で選んだパラメータが探索用のデータに合わせすぎていれば、本番では伸びないはずである。逆に、本番でも同じように、あるいはそれ以上に良ければ、そのパラメータは汎化していると読める。
効果を比べる理由:特徴量エンジニアリングとパラメータ調整のどちらがよく効いたかを数字で比べると、次に時間をどこに使うかを決める材料になる。
コード
print(f"探索スコア (30% サンプル / 3-Fold) : {study.best_value:.6f}")
print(f"本番スコア (全データ / 5-Fold)      : {final_auc:.6f}")
print(f"ベースライン (デフォルト 5-Fold)   : {BASE_AUC:.6f}")
print(f"チューニングによる本番改善幅 : {final_diff:+.6f}")study.best_value | 探索フェーズでの最良スコア(5-4) |
|---|---|
final_auc / final_diff | 本番設定での OOF AUC と、基準値との差(5-5) |
結果
探索スコア (30% サンプル / 3-Fold) : 0.961898
本番スコア (全データ / 5-Fold)      : 0.964792
ベースライン (デフォルト 5-Fold)   : 0.960856
チューニングによる本番改善幅       : +0.003936
スコアの差の読み方:探索スコア(0.961898)より本番スコア(0.964792)のほうが約 +0.0029 高くなった。データ量が 30%(約 20 万行)から 100%(約 69 万行)に増え、木の数もそれに合わせて 5268 本に増やしたためと考えられる(3-Fold から 5-Fold に変わり、1 Fold の学習データも増えている)。本番のほうが低くなる、という過学習の兆候は見られない。なお、表示の「ベースライン」は、第4章で確定した features_v1 を第4章の設定(学習率 0.05・500 本)で回したときの値である。
効果の比較:特徴量エンジニアリング(第4章)の改善は ΔAUC +0.000478、パラメータ探索(第5章)の改善は ΔAUC +0.003936 であった。このコンペでは、パラメータ調整による改善が特徴量追加の約 8 倍になった。この +0.003936 には、パラメータの効果と、木の数を 500 本から early stopping で決めた本数(学習率 0.1 で 5268 本)に変えた効果の両方が入っている。
次の 5-7 では、採用したパラメータと検証結果を設定ファイルに保存する。
5-7採用パラメータを configs/ に保存する
次にやること
5-5 で、チューニングによる改善 +0.003936 が本物だと確かめられた。次は、採用したパラメータと検証結果を configs/selected_params.json に保存する。
理由
コードに書き込まない:パラメータをコードやノートブックに直接書き込むと、次の工程で「どの設定が最良だったか」を探す手間がかかり、実験をやり直すときに設定を取り違えるおそれもある。設定ファイルに分ければ、第6章(モデル比較)や第7章(アンサンブル)で同じパラメータをすぐに読み込んで使える。
木の数も一緒に保存する:full_params には、5-5 で決めた木の数(n_estimators)が入っている。第6章ではこれを読み込むだけで、early stopping をかけ直さずに同じモデルを作れる。
スコアと探索の記録も一緒に保存する:パラメータだけでなく、本番の OOF AUC・標準偏差・基準値との差・判定と、探索の試行回数・時間・探索スコア・全データで止まった木の数も一緒に保存する。どの条件でどのスコアだったかを、あとから確かめられる。
コード
params_json = CONFIGS_DIR / "selected_params.json"
save_data = {
    "model": "lightgbm",
    "params": full_params,
    "validation": {
        "oof_auc": round(final_auc, 6),
        "oof_std": round(final_std, 6),
        "base_auc": BASE_AUC,
        "diff": round(final_diff, 6),
        "verdict": final_verdict,
    },
    "tuning": {
        "n_trials": 25,
        "tuning_time_sec": round(tuning_time, 1),
        "best_search_auc": round(study.best_value, 6),
        "full_best_iters": best_iters,
    }
}

with open(params_json, "w", encoding="utf-8") as _f:  # f は 5-5 の Fold 番号と重なるので _f
    json.dump(save_data, _f, indent=2, ensure_ascii=False)

print(f"saved params: {params_json}")
print(json.dumps(save_data, indent=2, ensure_ascii=False))
最後に、3-8 の実験記録 experiments.csv に、この章の結果を 1 行足す。
# 3-8 の実験記録に、調整した LightGBM の結果を 1 行足す
_log_path = RESULTS_DIR / "experiments.csv"
_row = pl.DataFrame({
    "exp": ["05_lgbm_tuned"],
    "features": ["v1_14"],
    "model": ["lgbm"],
    "params": [f"optuna25_lr0.1_n{n_fixed}"],
    "cv_auc": [round(final_auc, 6)],
    "cv_std": [round(final_std, 6)],
    "public_lb": [None],
    "note": ["configs/selected_params.json"],
})
if _log_path.exists():
    # 同じ実験名(exp)の行は置き換える。marimo がこのセルを再実行しても行は増えない
    _old = pl.read_csv(_log_path).filter(~pl.col("exp").is_in(_row["exp"].to_list()))
    _row = pl.concat([_old, _row], how="diagonal_relaxed")
_row.write_csv(_log_path)
print(_row)json.dump(data, f, indent=2, ...) | 辞書データをフォーマット整形して JSON ファイルに書き出す |
|---|
結果
saved params: D:\kaggle\smartphone-addiction_s6e8\configs\selected_params.json
{
  "model": "lightgbm",
  "params": {
    "learning_rate": 0.1,
    "n_estimators": 5268,
    "random_state": 42,
    "verbose": -1,
    "subsample_freq": 1,
    "num_leaves": 27,
    "max_depth": 3,
    "min_child_samples": 60,
    "subsample": 0.9065353807374242,
    "colsample_bytree": 0.8636468941292694,
    "reg_alpha": 0.003027909175827758,
    "reg_lambda": 7.005643235827376
  },
  "validation": {
    "oof_auc": 0.964792,
    "oof_std": 0.000522,
    "base_auc": 0.960856,
    "diff": 0.003936,
    "verdict": "[採択] (有意な改善: +0.000200 以上)"
  },
  "tuning": {
    "n_trials": 25,
    "tuning_time_sec": 474.0,
    "best_search_auc": 0.961898,
    "full_best_iters": [
      4807,
      5844,
      6177,
      5268,
      5267
    ]
  }
}
params には、固定した値と探索で見つけた値、5-5 で決めた木の数 5268 本がまとめて入っている。探索で見つけた実数は丸めずに保存しているので、あとで読み込めば 5-5 とまったく同じモデルを作れる。
┌────────────────┬─────────────┬───────┬──────────────────────┬──────────┬──────────┬───────────┬───────────────────────────────┐
│ exp            ┆ features    ┆ model ┆ params               ┆ cv_auc   ┆ cv_std   ┆ public_lb ┆ note                          │
╞════════════════╪═════════════╪═══════╪══════════════════════╪══════════╪══════════╪═══════════╪═══════════════════════════════╡
│ 03_baseline    ┆ baseline_12 ┆ lgbm  ┆ lr0.05_n500          ┆ 0.960379 ┆ 0.000631 ┆ null      ┆ 基準値                        │
│ 04_features_v1 ┆ v1_14       ┆ lgbm  ┆ lr0.05_n500          ┆ 0.960856 ┆ 0.000614 ┆ null      ┆ 4-9: baseline_12 + 2 features │
│ 05_lgbm_tuned  ┆ v1_14       ┆ lgbm  ┆ optuna25_lr0.1_n5268 ┆ 0.964792 ┆ 0.000522 ┆ null      ┆ configs/selected_params.json  │
└────────────────┴─────────────┴───────┴──────────────────────┴──────────┴──────────┴───────────┴───────────────────────────────┘
実験記録は 3 行になった。同じ 14 列の特徴量のまま、パラメータと木の数を変えた 05_lgbm_tuned(0.964792)が足された。
この章で分かったことを、次の章への申し送りとしてまとめる。
1. 確定モデルパラメータ (LightGBM):
   - learning_rate: 0.1, n_estimators: 5268 (全データの early stopping の中央値)
   - max_depth: 3 (num_leaves 27 は深さ 3 では効かない), min_child_samples: 60
   - subsample: 0.906535, colsample_bytree: 0.863647
   - reg_alpha: 0.003028, reg_lambda: 7.005643
   - 本番 5-Fold OOF AUC: 0.964792 (第4章 0.960856 から +0.003936 の改善)
   - 保存先: configs/selected_params.json
2. 探索コストの実績:
   - 30% サンプル / 3-Fold による探索 25 試行: 474.0 秒 (約 7.9 分)
   - 本番 5-Fold での木の数の決定 (early stopping): 733.8 秒
   - 本番 5-Fold での確認検証 (5268 本固定): 142.8 秒
3. 第6章 (モデル比較) への方針:
   - XGBoost と CatBoost も、この章と同じ手順 (30% / 3-Fold / early stopping / 25 試行) で調整してから比べる
   - 同一の 14 列特徴量・同一の 5-Fold で学習・比較し、第7章のアンサンブルに向けて予測の相関 (多様性) も見る
次の第6章では、XGBoost と CatBoost もこの章と同じ手順で調整してから、同じ 14 列の特徴量・同じ 5-Fold で LightGBM と比べる。