CH 1データを知る(EDA)
この章では、コンペのデータを読み込み、形・目的変数(target variable)・欠損(missing value)・列ごとの傾向を確かめる。EDA の目的はきれいなグラフを作ることではなく、次の工程で何をするかを決めることである。そのため各節は、判断に使う数字を出して終わる。グラフは、その数字の形を目で確かめ、表では気づきにくい形を見つけるために描く。目的変数の 0 と 1 は青と赤、train と test は紺とオレンジに、全部のグラフで色をそろえる。グラフは押すと画面いっぱいに広がる。1-4 まででデータの形が分かったら、いったん第2章・第3章で最初の提出まで通し、1-5 以降は後で戻ってきて進める。
1-1データを読み、大きさと列構成を掴む
次にやること
まず train / test / sample_submission の 3 つを、生データだと分かる名前で読み込む。行数・列数を確かめ、列名の差から目的変数を特定し、提出ファイル(submission file)の形を控える。
理由
目的変数を機械的に特定する:列名を目で探すのではなく、差集合(set difference) set(train.columns) - set(test.columns) を取ると、目的変数(addicted_label)を 1 行で確実に特定できる。列名の打ち間違いや思い込みによる取り違えを防げる。
提出の形を早めに控える:test の行数(296,302 行)と sample_submission の列構成(id, addicted_label)を最初に控えると、第3章の提出ファイル検証(3-7)でそのまま検証の基準に使える。後の工程で「提出行数が合わない」と慌てずに済む。
データの規模から計算時間を見積もる:train 691,369 行、test 296,302 行という規模を最初に把握すると、全件で回せる処理と、サンプルを抜いて回すべき処理(1-8 の敵対的検証など)を判断できる。
生データは _raw の名前で読み、コピーを使う:data/raw の CSV は train_raw・test_raw・sample_sub_raw の名前で読み込み、名前を見れば生データだと分かるようにする。以降のセルでは、train = train_raw.clone() のように作った作業用のコピーや、そこから列・行を取り出したものを使い、*_raw は読んだときのまま残す。加工の途中で値がおかしくなっても、生データと比べて原因を探せる。Polars の with_columns や filter は元の DataFrame を変えずに新しい DataFrame を返すので、コピーしなくても元は壊れない。それでもコピーを作るのは、「ここから先は作業用」とコードで分かるようにするためである。clone() は中身を複製せずに共有するので、大きなデータでも時間とメモリーはほとんどかからない(pandas は 2.x まで、取り出した DataFrame を書き換えると元も変わることがあり、df.copy() で複製する必要があった)。sample_submission は 1-1 では形を見るだけなので、コピーは作らない。第2章以降のノートブックも、生データはこの形で読む。
インポートと置き場所は最初のセルにまとめる:ノートブックは章ごとに 1 冊で、第1章もこのノートブックだけで完結させる。marimo では同じ名前を 2 つのセルでインポートできないので、第1章で使うライブラリと、生データの置き場所を、最初のセルで 1 回だけ定義する。第2章・第3章は別のノートブックなので、それぞれの最初のセル(2-1・3-1)で、必要なライブラリと定数を用意し直す。
グラフの色も最初に決める:第1章の 1-2・1-5〜1-8 でグラフを描く。目的変数の 0 / 1 と、train / test の色を最初のセルで 1 回だけ決め、どのグラフでも同じ色の系統を使う(第3章の 3-1 でも train / test に同じ色を定義する。3-4 の一部の図は、同じ青系・赤系の別の色)。色の意味が毎回同じなら、凡例を読まなくても「赤 = 1」「オレンジ = test」と分かる。
コード
まず、ライブラリと置き場所を用意する。
# 第1章で使うライブラリを、最初のセルでまとめてインポートする
from pathlib import Path

import matplotlib.pyplot as plt
import numpy as np
import polars as pl
import seaborn as sns
from lightgbm import LGBMClassifier
from scipy.stats import ks_2samp
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold

# データの置き場所を 1 か所で定義する
PROJECT = Path(r"D:\kaggle\smartphone-addiction_s6e8")   # データの置き場所。自分の環境に合わせて書き換える
RAW_DIR = PROJECT / "data" / "raw"

# グラフの色: 目的変数の 0 = 青・1 = 赤、train = 紺・test = オレンジ
C0, C1 = "#4A90E2", "#E94E77"
C_TRAIN, C_TEST = "#2b5c8f", "#e27c39"
次に、3 つのファイルを読み込む。
# 生データは *_raw の名前で読み込み、読んだときのまま残す
train_raw = pl.read_csv(RAW_DIR / "train.csv")
test_raw = pl.read_csv(RAW_DIR / "test.csv")
sample_sub_raw = pl.read_csv(RAW_DIR / "sample_submission.csv")

# 以降のセルでは作業用のコピーを使う
train = train_raw.clone()
test = test_raw.clone()

print("train", train.shape, " test", test.shape)
print("train only:", sorted(set(train.columns) - set(test.columns)))
print("submission", sample_sub_raw.shape, sample_sub_raw.columns)import matplotlib.pyplot as plt / import seaborn as sns | グラフを描くライブラリ。plt で図の枠を作り、sns でヒストグラム・箱ひげ図・ヒートマップを描く |
|---|---|
from scipy.stats import ks_2samp | 2 つの分布のずれを測る KS 統計量を出す(1-8) |
Path(...) / "data" | フォルダーのパスを / でつないで作る |
path.mkdir(parents=True, exist_ok=True) | 保存先のフォルダーを作る。すでにあれば何もしない |
pl.read_csv(path) | CSV を Polars の DataFrame として読み込む |
df.clone() | DataFrame のコピーを作る。中身は複製せずに共有するので軽い。元の train_raw などは読んだときのまま残る |
df.shape | (行数, 列数) のタプルを返す |
df.columns | 列名の一覧をリストとして取得する |
set(train.columns) - set(test.columns) | 集合の差で、train にだけある列(目的変数)を特定する |
結果
train (691369, 14)  test (296302, 13)
train only: ['addicted_label']
submission (296302, 2) ['id', 'addicted_label']
train は 691,369 行・14 列、test は 296,302 行・13 列である。train にだけある列は addicted_label の 1 つなので、これが目的変数である。test の 296,302 行が、提出ファイルの行数になる。sample_submission は 296,302 行・2 列(id・addicted_label)で、提出ファイルはこの形にそろえる(3-7 で確かめる)。
次の 1-2 では、この目的変数 addicted_label の分布を見る。
1-2目的変数の分布を見る
次にやること
前の節で、目的変数が addicted_label だと分かった。次は値ごとの件数と陽性率(positive rate)を確認し、層化分割(StratifiedKFold)が必要か、評価指標(evaluation metric) ROC-AUC がなぜ使われるのかを確かめる。
理由
CV の分け方を決める(層化分割):陽性と陰性の比率が偏っている場合、通常の KFold でランダムに分けると、Fold ごとに陽性率がぶれる。すると Fold 間のスコア差が広がり、検証の信頼性が下がる。偏りがあれば、各 Fold の陽性率を元データとそろえる StratifiedKFold(2-2)を使う。
Accuracy が指標として使いにくい理由:陽性率が高いと、すべての行を「1(陽性)」と予測するだけで正解率(Accuracy)が陽性率と同じ値になる。Accuracy では「陽性ばかり当てて陰性を無視するモデル」と「よいモデル」の差が見えにくくなる。閾値(threshold)に依存せず、確率の並び順のよさを測る ROC-AUC がこのコンペの指標になっているのはそのためである。
コード
TARGET = "addicted_label"

print(train[TARGET].value_counts().sort(TARGET))
# .to_numpy() で NumPy 配列にしてから平均する(Polars の .mean() のままだと、エディターの型チェックが警告を出す)
print("陽性率:", round(train[TARGET].to_numpy().mean(), 4))
次に、同じ件数を棒グラフにする。棒の上に件数と割合を書く。
_counts = train[TARGET].value_counts().sort(TARGET)

_fig, _ax = plt.subplots(figsize=(5, 3.5))
_bars = _ax.bar(_counts[TARGET].cast(pl.String), _counts["count"], color=[C0, C1], width=0.45,
               alpha=0.5, edgecolor="black")   # 半透明の棒に黒い枠線
_ax.bar_label(_bars, labels=[f"{_n:,}\n({_n / train.height:.1%})" for _n in _counts["count"]],
              fontweight="bold")
_ax.set_ylim(0, _counts["count"].to_numpy().max() * 1.25)   # 棒の上の文字が枠に収まるように
_ax.set_title(f"{TARGET} (train)", fontweight="bold")
_fig.tight_layout()
_figdf[col].value_counts() | 各値の出現件数を集計する(.sort(col) で値の順に並べる) |
|---|---|
df[col].mean() | 0/1 の二値ラベルなら、平均値がそのまま陽性率になる |
plt.subplots(figsize=(幅, 高さ)) | 図(_fig)とグラフの枠(_ax)を作る。大きさはインチで指定する |
ax.bar(x, 高さ, color=[...], alpha=0.5, edgecolor="black") | 棒グラフを描く。0 を青(C0)、1 を赤(C1)にする。alpha は透明度(0.5 で半透明)、edgecolor は枠線の色で、第1章の図は半透明の棒に黒い枠線を付ける |
ax.bar_label(bars, labels=[...]) | 棒の上に文字を書く |
_fig(セルの最後の行) | marimo では、セルの最後に置いた図がそのまま表示される。名前を _ で始めると、そのセルの中だけの名前になり、ほかのセルの _fig とぶつからない |
結果
shape: (2, 2)
┌────────────────┬────────┐
│ addicted_label ┆ count  │
╞════════════════╪════════╡
│ 0              ┆ 200895 │
│ 1              ┆ 490474 │
└────────────────┴────────┘
陽性率: 0.7094
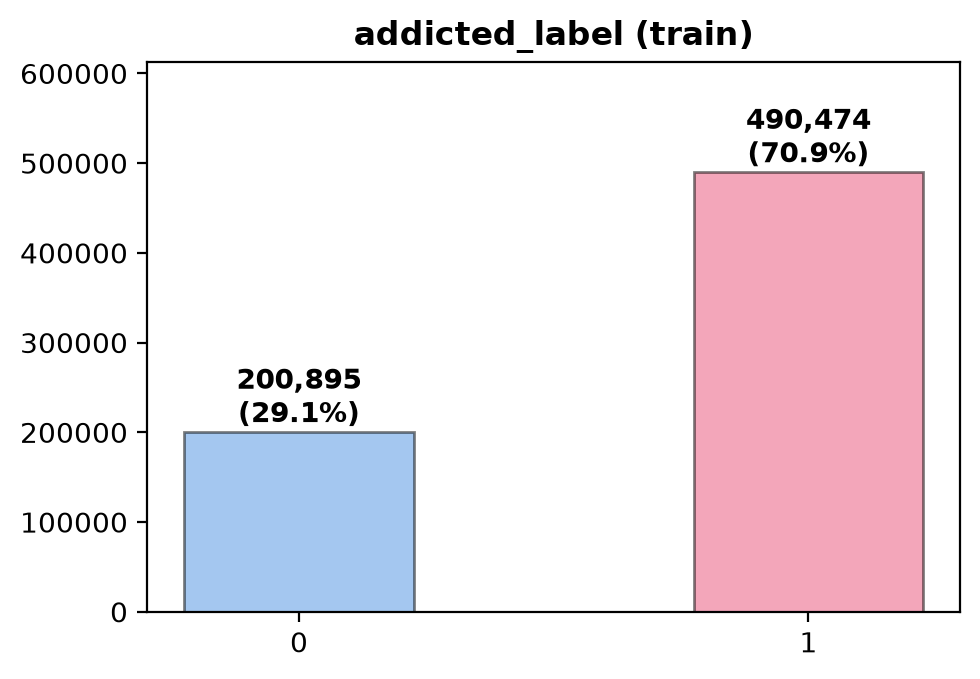
- このグラフを使う理由
- 値が 0 と 1 の 2 つしかないので、件数を比べるには棒の長さが最も素直である。表の数字よりも、偏りの大きさが一目で分かる。
- 何を見るか
- 0 と 1 の棒の高さの比。偏りが大きければ、層化分割(2-2)と、偏りに左右されない指標(ROC-AUC)が必要になる。
- 見方
- 横軸は
addicted_labelの値、縦軸は件数。青が 0、赤が 1。棒の上の数字は件数と、全体に占める割合である。
0 が 200,895 件、1 が 490,474 件で、陽性率は 0.7094(約 70.9%)である。図 1.1 の棒グラフでも、赤(1)の棒は青(0)の棒の 2.4 倍の高さがある。偏りが大きいので、CV には StratifiedKFold を使う(2-2)。また、すべて「1」と予測するだけで Accuracy は 70.94% になるため、Accuracy では改善を正しく測れない。ROC-AUC で評価するのが妥当である。
次の 1-3 では、目的変数以外の列を数値列とカテゴリ列に仕分ける。
1-3列の型を仕分ける
次にやること
前の節で目的変数の性質が分かった。次は残りの列を「数値列のリスト」と「カテゴリ列のリスト」に分ける。この 2 つのリストは以降のほぼ全工程で使い回すので、列名を手で打たずにスキーマから機械的に作る。
理由
ID 列の混入によるリーク(leakage)を防ぐ:id 列は数値型(Int64)であるが、ただの識別子(identifier)で特徴量(feature)ではない。S6E8 の id は train(0〜691,368)と test(691,369〜)で連番が続いているため、特徴量に混ぜると「ID の大きさで目的変数を覚える」ことが起きる。CV のスコアは不自然に高くなるのに、test では当たらなくなる。リストを作る時点で (ID, TARGET) をはっきり除外する。
「数値型だが中身はカテゴリ」の列に気をつける:郵便番号や地区コード、機種コードのように、型は数値でも中身は順序のないカテゴリという列がありえる。is_numeric() だけで仕分けると、大小に意味のない記号を数値として分割してしまう。n_unique() と列名の意味もあわせて確認する習慣をつける。
コード
ID = "id"  # TARGET は 1-2 で定義済み

num_cols = [c for c, dt in train.schema.items()
            if dt.is_numeric() and c not in (ID, TARGET)]
cat_cols = [c for c, dt in train.schema.items()
            if dt == pl.String and c not in (ID, TARGET)]

print("numeric:", num_cols)
print("categorical:", cat_cols)
# 数値にもカテゴリにも入らなかった列(Boolean や日付など)。空でなければ、扱いを決める
other_cols = [c for c in train.columns if c not in num_cols + cat_cols + [ID, TARGET]]
print("other:", other_cols)
# 数値列の種類の数。種類が少ない数値列は、中身がカテゴリかもしれない
print("n_unique:", {c: train[c].n_unique() for c in num_cols})df.schema | 列名とデータ型の対応を取得する |
|---|---|
dtype.is_numeric() | 整数型(Int64 など)・浮動小数点型(Float64 など)なら True を返す |
dtype == pl.String | 文字列型(カテゴリ候補)かどうかを判定する |
df[col].n_unique() | 列の値の種類の数を数える(欠損も 1 種類と数える) |
結果
numeric: ['age', 'daily_screen_time_hours', 'social_media_hours', 'gaming_hours',
          'work_study_hours', 'sleep_hours', 'notifications_per_day',
          'app_opens_per_day', 'weekend_screen_time']
categorical: ['gender', 'stress_level', 'academic_work_impact']
other: []
n_unique: {'age': 19, 'daily_screen_time_hours': 1390, 'social_media_hours': 722,
           'gaming_hours': 402, 'work_study_hours': 601, 'sleep_hours': 452,
           'notifications_per_day': 232, 'app_opens_per_day': 167,
           'weekend_screen_time': 1438}
数値列が 9 個、カテゴリ列が 3 個に分かれた。other は空で、S6E8 の列はすべて数値列かカテゴリ列に入った。True / False の列や日付の列があるデータでは、ここに列名が出る。id と目的変数は数値列に入っていない。数値列の種類の数は、最も少ない age でも 19 種類(年齢)で、ほかは 167〜1,438 種類ある。列名を見ても、コードや番号の列はない。このコンペでは「数値型だが中身はカテゴリ」という列は見当たらず、きれいに分かれている。
次の 1-4 では、各列にどれだけ欠損があるかを数える。
1-4欠損を数える
次にやること
前の節で列を数値とカテゴリに分けた。次は列ごとの欠損数と欠損率(missing rate)を一覧にする。埋め方を決めるのはまだ先で、ここでは「どの列にどれだけ欠けているか」を把握する。
理由
LightGBM は欠損をそのまま扱える:LightGBM などの GBDT(Gradient Boosting Decision Tree:勾配ブースティング決定木)は、各分岐で「欠損を左に送るか右に送るか」を両方試し、よいほうを自動で学習する。そのため、事前に平均値や中央値で埋める必要はない。むしろ平均値で埋めると「欠損していた」という情報が消え、モデルの表現力を下げることがある。
欠損がランダムかどうかを見る(第4章 4-6 につながる):後の 1-6・1-7 で見るとおり、S6E8 では欠損行の陽性率が全体平均(0.7094)とほぼ同じである。これは欠損がランダムに発生している(MCAR: Missing Completely At Random)という見方と矛盾せず、「欠損フラグ(missing indicator)」を作っても予測の手がかりにならないと考えられる(第4章 4-6 で実測する)。
見えない欠損に気をつける:0 や -1、"Unknown"、"None" といった値が、実質的に欠損を表していることがある。これらは null_count() では数えられないので、別のコードで数える。たとえば満足度を 1〜5 で答える列で 0 が出てきたら、「該当なし」「未回答」の意味かもしれない。
見えない欠損は、陽性率まで見る:0 が本当の値(0 時間など)なのか、「該当なし」の印なのかは、件数だけでは分からない。0 の行の陽性率を、0 に近い小さな値の行の陽性率と比べ、そこから飛び離れていれば、0 は特別な印である。null と違ってランダムではないので、第4章の特徴量の手がかりになる(例:0 を欠損にする、0 の数を数える)。
コード
nulls = (
    train.null_count()
    .transpose(include_header=True, header_name="column", column_names=["null_count"])
    .with_columns((pl.col("null_count") / train.height * 100).round(2).alias("null_pct"))
    .filter(pl.col("null_count") > 0)
    .sort("null_count", descending=True)
)
nulls
次に、見えない欠損を数える。数値列は 0 と -1 の件数と、0 の行の陽性率を、文字列の列は「欠損の代わりによく使われる文字列」の件数を出す。
# 見えない欠損: 欠損の代わりに使われがちな値を数える
SENTINELS = ["", "na", "n/a", "none", "null", "nan", "unknown", "missing", "?", "-"]
_rows = []
for _c in num_cols:
    _is0 = train[_c] == 0
    _rows.append({
        "column": _c,
        "n_zero": _is0.sum(),
        "n_minus1": (train[_c] == -1).sum(),
        "rate_if_zero": train.filter(_is0)[TARGET].mean(),  # 0 の行の陽性率
    })
print(
    pl.DataFrame(_rows)
    .filter((pl.col("n_zero") > 0) | (pl.col("n_minus1") > 0))
    .with_columns(pl.col("rate_if_zero").round(4))
)
print("欠損の代わりの文字列:", {
    _c: train[_c].str.to_lowercase().str.strip_chars().is_in(SENTINELS).sum() for _c in cat_cols
})df.null_count() | 列ごとの欠損数を 1 行の DataFrame で集計する |
|---|---|
df.transpose(include_header=True, ...) | 横長の集計結果を縦長の表に変える |
df.with_columns(expr.alias(name)) | 欠損率(null_pct)を計算して列を追加する |
df.filter(cond) / df.sort(col, descending=True) | 欠損のある列だけに絞り、多い順に並べる |
(train[c] == 0).sum() | 0 の件数を数える(True を 1 として足す) |
train.filter(mask)[TARGET].mean() | 0 の行だけに絞って陽性率を出す。0 の行がなければ null になる |
s.str.to_lowercase().str.strip_chars().is_in(list) | 大文字・小文字と前後の空白をそろえてから、欠損の代わりの文字列かどうかを調べる |
結果
┌─────────────────────────┬────────────┬──────────┐
│ column                  ┆ null_count ┆ null_pct │
╞═════════════════════════╪════════════╪══════════╡
│ social_media_hours      ┆ 133995     ┆ 19.38    │
│ gaming_hours            ┆ 126821     ┆ 18.34    │
│ weekend_screen_time     ┆ 112063     ┆ 16.21    │
│ daily_screen_time_hours ┆ 95854      ┆ 13.86    │
│ app_opens_per_day       ┆ 80710      ┆ 11.67    │
│ notifications_per_day   ┆ 67584      ┆ 9.78     │
│ stress_level            ┆ 55148      ┆ 7.98     │
│ work_study_hours        ┆ 51518      ┆ 7.45     │
│ sleep_hours             ┆ 44480      ┆ 6.43     │
│ academic_work_impact    ┆ 44224      ┆ 6.4      │
│ gender                  ┆ 29034      ┆ 4.2      │
│ age                     ┆ 28929      ┆ 4.18     │
└─────────────────────────┴────────────┴──────────┘
特徴量 12 列すべてに欠損があり、欠損率は 4.18%(age)から 19.38%(social_media_hours)である。高めであるが、LightGBM は欠損をそのまま扱えるので、ここでは埋めずに進む。
見えない欠損のほうは、次のとおりであった。
┌────────────────────┬────────┬──────────┬──────────────┐
│ column             ┆ n_zero ┆ n_minus1 ┆ rate_if_zero │
╞════════════════════╪════════╪══════════╪══════════════╡
│ social_media_hours ┆ 12     ┆ 0        ┆ 0.0          │
│ gaming_hours       ┆ 110    ┆ 0        ┆ 0.5          │
│ work_study_hours   ┆ 5      ┆ 0        ┆ 0.2          │
└────────────────────┴────────┴──────────┴──────────────┘
欠損の代わりの文字列: {'gender': 0, 'stress_level': 0, 'academic_work_impact': 0}
0 があるのは時間の 3 列だけで、最も多い gaming_hours でも 110 行(69 万行の 0.02%)である。「0 時間」という本当の値と読めるし、陽性率(0.0〜0.5)は全体より低いが、1-7 で見る「値が小さいほど陽性率が低い」傾向の延長と読めるので、0 を特別な印とみなす理由はない。件数も少なく、影響は小さい。-1 と欠損の代わりの文字列は 0 件であった。S6E8 の欠損は、null だけを見ればよいと分かる。
コンペによっては、ここで数千〜数万行の 0 が見つかり、0 の行の陽性率が全体と大きく違うことがある。そのときは 1-9 の申し送りに書き、第4章で特徴量にする。
ここでデータの形が分かったので、いったん第2章・第3章に進んで最初の提出まで通し、1-5 以降は基準のスコアを手に入れてから戻ってきて進める(理由は 1-9 で述べる)。
1-5数値列の分布を見る(ヒストグラム)
次にやること
1-4 で欠損の量が分かり、第3章で基準のスコアも手に入った。ここからは列ごとの中身を見ていく。まず数値列の代表値(件数・欠損数・平均・標準偏差・最小・四分位数・最大)を一括で確認し、外れ値(outlier)や値の上限・下限を把握する。続けて、列ごとにヒストグラム(histogram:値を区間に分けて件数を棒にしたグラフ)を描き、分布の形を見る。棒は目的変数の 0 と 1 で青と赤に塗り分けて積み上げる。
理由
木モデルは単調な変換で結果が変わらない(第6章 6-3 につながる):決定木(decision tree)の分割は「x ≤ c かどうか」という大小比較だけで行われる。特徴量 x を対数変換(log x)しても標準化((x − μ) / σ)しても、単調に増える変換なら各行の順序は変わらない。分岐(split)のしきい値 c が変換後の値に移るだけで、木が作る分割は同じである。そのため「分布が歪んでいるから対数を取る」「スケールが違うから標準化(standardization)する」という前処理は、木モデルには効果がない。
ただし、第6章で比べる線形モデル(LogisticRegression)や、6-3 で触れるニューラルネット(MLP)は、特徴量と重みの線形結合 Σ wᵢxᵢ を、勾配を使う反復法で最適化するので、正則化と収束のために標準化が必要である(第6章 6-3 で扱う)。
上限・下限で切られた値を見つける:値がキリのよい数字で止まっている列は、アンケートの時点で「○時間以上」とまとめて切られた可能性がある。上限に張り付いたデータは分布が途切れるので、第4章で比率や差分の特徴量を作るときに留意する。ただし、最大値がキリのよい数字というだけでは、切られたのか、自然に裾が細くなって終わったのかは区別できない。最大値の手前でも件数が多いまま途切れていれば切られた形、手前で件数が 0 に近づいていれば自然な裾である。これはヒストグラムを見ると一目で分かる。
0 と 1 で塗り分けて積み上げる:棒の高さ全体が、その区間の件数(分布の形)を表す。その中の赤の割合が、その区間の陽性率を表す。値が大きくなるにつれて赤の割合が増える列は目的変数と関係があり、どの区間でも青と赤の割合が同じ列は関係が薄い。1 枚で「分布の形」と「目的変数との関係」の両方を見られる。数値での確認は 1-7 で行う。
整数の列は区切りを値の間に置く:age のような整数の列を 30 個の区間に等分すると、区間によって入る整数の数が 1 個だったり 2 個だったりする。すると、分布が平らでも棒が櫛の歯のように凸凹になる。整数の列では、区間の幅を整数にし、区切りを整数と整数の間(18.5 など)に置く。
コード
train.select(num_cols).describe().with_columns(pl.col(pl.Float64).round(2))次に、数値列ごとのヒストグラムを 3 列ずつ並べて描く。
_pdf = train.select(num_cols + [TARGET]).to_pandas()
_nrow = (len(num_cols) + 2) // 3   # 1 行に 3 つ並べるときの行数

_fig, _axes = plt.subplots(_nrow, 3, figsize=(15, 3.6 * _nrow), squeeze=False)
for _i, (_ax, _c) in enumerate(zip(_axes.ravel(), num_cols)):
    _bin = {"bins": 30}
    if train[_c].dtype.is_integer():   # 整数の列は、区切りを整数と整数の間に置く
        _w = int(np.ceil((train[_c].max() - train[_c].min() + 1) / 30))
        _bin = {"binwidth": _w, "binrange": (train[_c].min() - 0.5, train[_c].max() + 0.5)}
    sns.histplot(data=_pdf, x=_c, hue=TARGET, palette={0: C0, 1: C1}, multiple="stack",
                 alpha=0.5, edgecolor="black", linewidth=0.5, legend=(_i == 0), ax=_ax, **_bin)
    _ax.set_title(_c)
    _ax.set_xlabel("")
for _ax in _axes.ravel()[len(num_cols):]:   # 余った枠は消す
    _ax.set_visible(False)
_fig.tight_layout()
_figdf.describe() | 件数・欠損数・平均・標準偏差・最小・四分位(quartile)・最大をまとめて出す |
|---|---|
pl.col(pl.Float64).round(2) | 浮動小数点数列を一括で小数点以下2桁に丸める(表を読みやすくする) |
df.to_pandas() | seaborn に渡すために pandas の DataFrame に変える |
plt.subplots(行, 列, squeeze=False) | グラフの枠を格子状に作る。squeeze=False にすると、列の数が少なく 1 行になっても _axes が 2 次元の配列のままになり、同じコードで扱える |
_axes.ravel() | 格子状の枠を 1 列に並べ直し、列名と 1 つずつ組にできるようにする |
sns.histplot(data, x=列, hue=TARGET, multiple="stack") | ヒストグラムを描く。hue で目的変数ごとに色を分け、multiple="stack" で積み上げる。palette で 0 を青、1 を赤にする |
binwidth=幅, binrange=(下限, 上限) | 区間の幅と範囲を指定する。整数の列で区切りを値の間に置くのに使う |
ax.set_visible(False) | 列の数が 3 の倍数でないときに余る枠を消す |
結果
shape: (9, 10)
┌────────────┬──────────┬─────────────────────────┬────────────────────┬──────────────┬──────────────────┬─────────────┬───────────────────────┬───────────────────┬─────────────────────┐
│ statistic  ┆ age      ┆ daily_screen_time_hours ┆ social_media_hours ┆ gaming_hours ┆ work_study_hours ┆ sleep_hours ┆ notifications_per_day ┆ app_opens_per_day ┆ weekend_screen_time │
│ ---        ┆ ---      ┆ ---                     ┆ ---                ┆ ---          ┆ ---              ┆ ---         ┆ ---                   ┆ ---               ┆ ---                 │
│ str        ┆ f64      ┆ f64                     ┆ f64                ┆ f64          ┆ f64              ┆ f64         ┆ f64                   ┆ f64               ┆ f64                 │
╞════════════╪══════════╪═════════════════════════╪════════════════════╪══════════════╪══════════════════╪═════════════╪═══════════════════════╪═══════════════════╪═════════════════════╡
│ count      ┆ 662440.0 ┆ 595515.0                ┆ 557374.0           ┆ 564548.0     ┆ 639851.0         ┆ 646889.0    ┆ 623785.0              ┆ 610659.0          ┆ 579306.0            │
│ null_count ┆ 28929.0  ┆ 95854.0                 ┆ 133995.0           ┆ 126821.0     ┆ 51518.0          ┆ 44480.0     ┆ 67584.0               ┆ 80710.0           ┆ 112063.0            │
│ mean       ┆ 26.62    ┆ 7.64                    ┆ 2.47               ┆ 1.46         ┆ 2.37             ┆ 6.8         ┆ 145.89                ┆ 102.64            ┆ 9.48                │
│ std        ┆ 5.15     ┆ 2.72                    ┆ 1.32               ┆ 0.93         ┆ 1.26             ┆ 1.23        ┆ 65.92                 ┆ 48.09             ┆ 2.86                │
│ min        ┆ 18.0     ┆ 0.5                     ┆ 0.0                ┆ 0.0          ┆ 0.0              ┆ 4.5         ┆ 20.0                  ┆ 15.0              ┆ 0.51                │
│ 25%        ┆ 22.0     ┆ 5.48                    ┆ 1.45               ┆ 0.7          ┆ 1.36             ┆ 5.78        ┆ 93.0                  ┆ 64.0              ┆ 7.28                │
│ 50%        ┆ 27.0     ┆ 7.77                    ┆ 2.31               ┆ 1.33         ┆ 2.2              ┆ 6.8         ┆ 150.0                 ┆ 104.0             ┆ 9.58                │
│ 75%        ┆ 31.0     ┆ 9.84                    ┆ 3.37               ┆ 2.09         ┆ 3.2              ┆ 7.87        ┆ 204.0                 ┆ 145.0             ┆ 11.75               │
│ max        ┆ 35.0     ┆ 15.0                    ┆ 8.0                ┆ 4.0          ┆ 6.0              ┆ 9.0         ┆ 250.0                 ┆ 180.0             ┆ 17.56               │
└────────────┴──────────┴─────────────────────────┴────────────────────┴──────────────┴──────────────────┴─────────────┴───────────────────────┴───────────────────┴─────────────────────┘
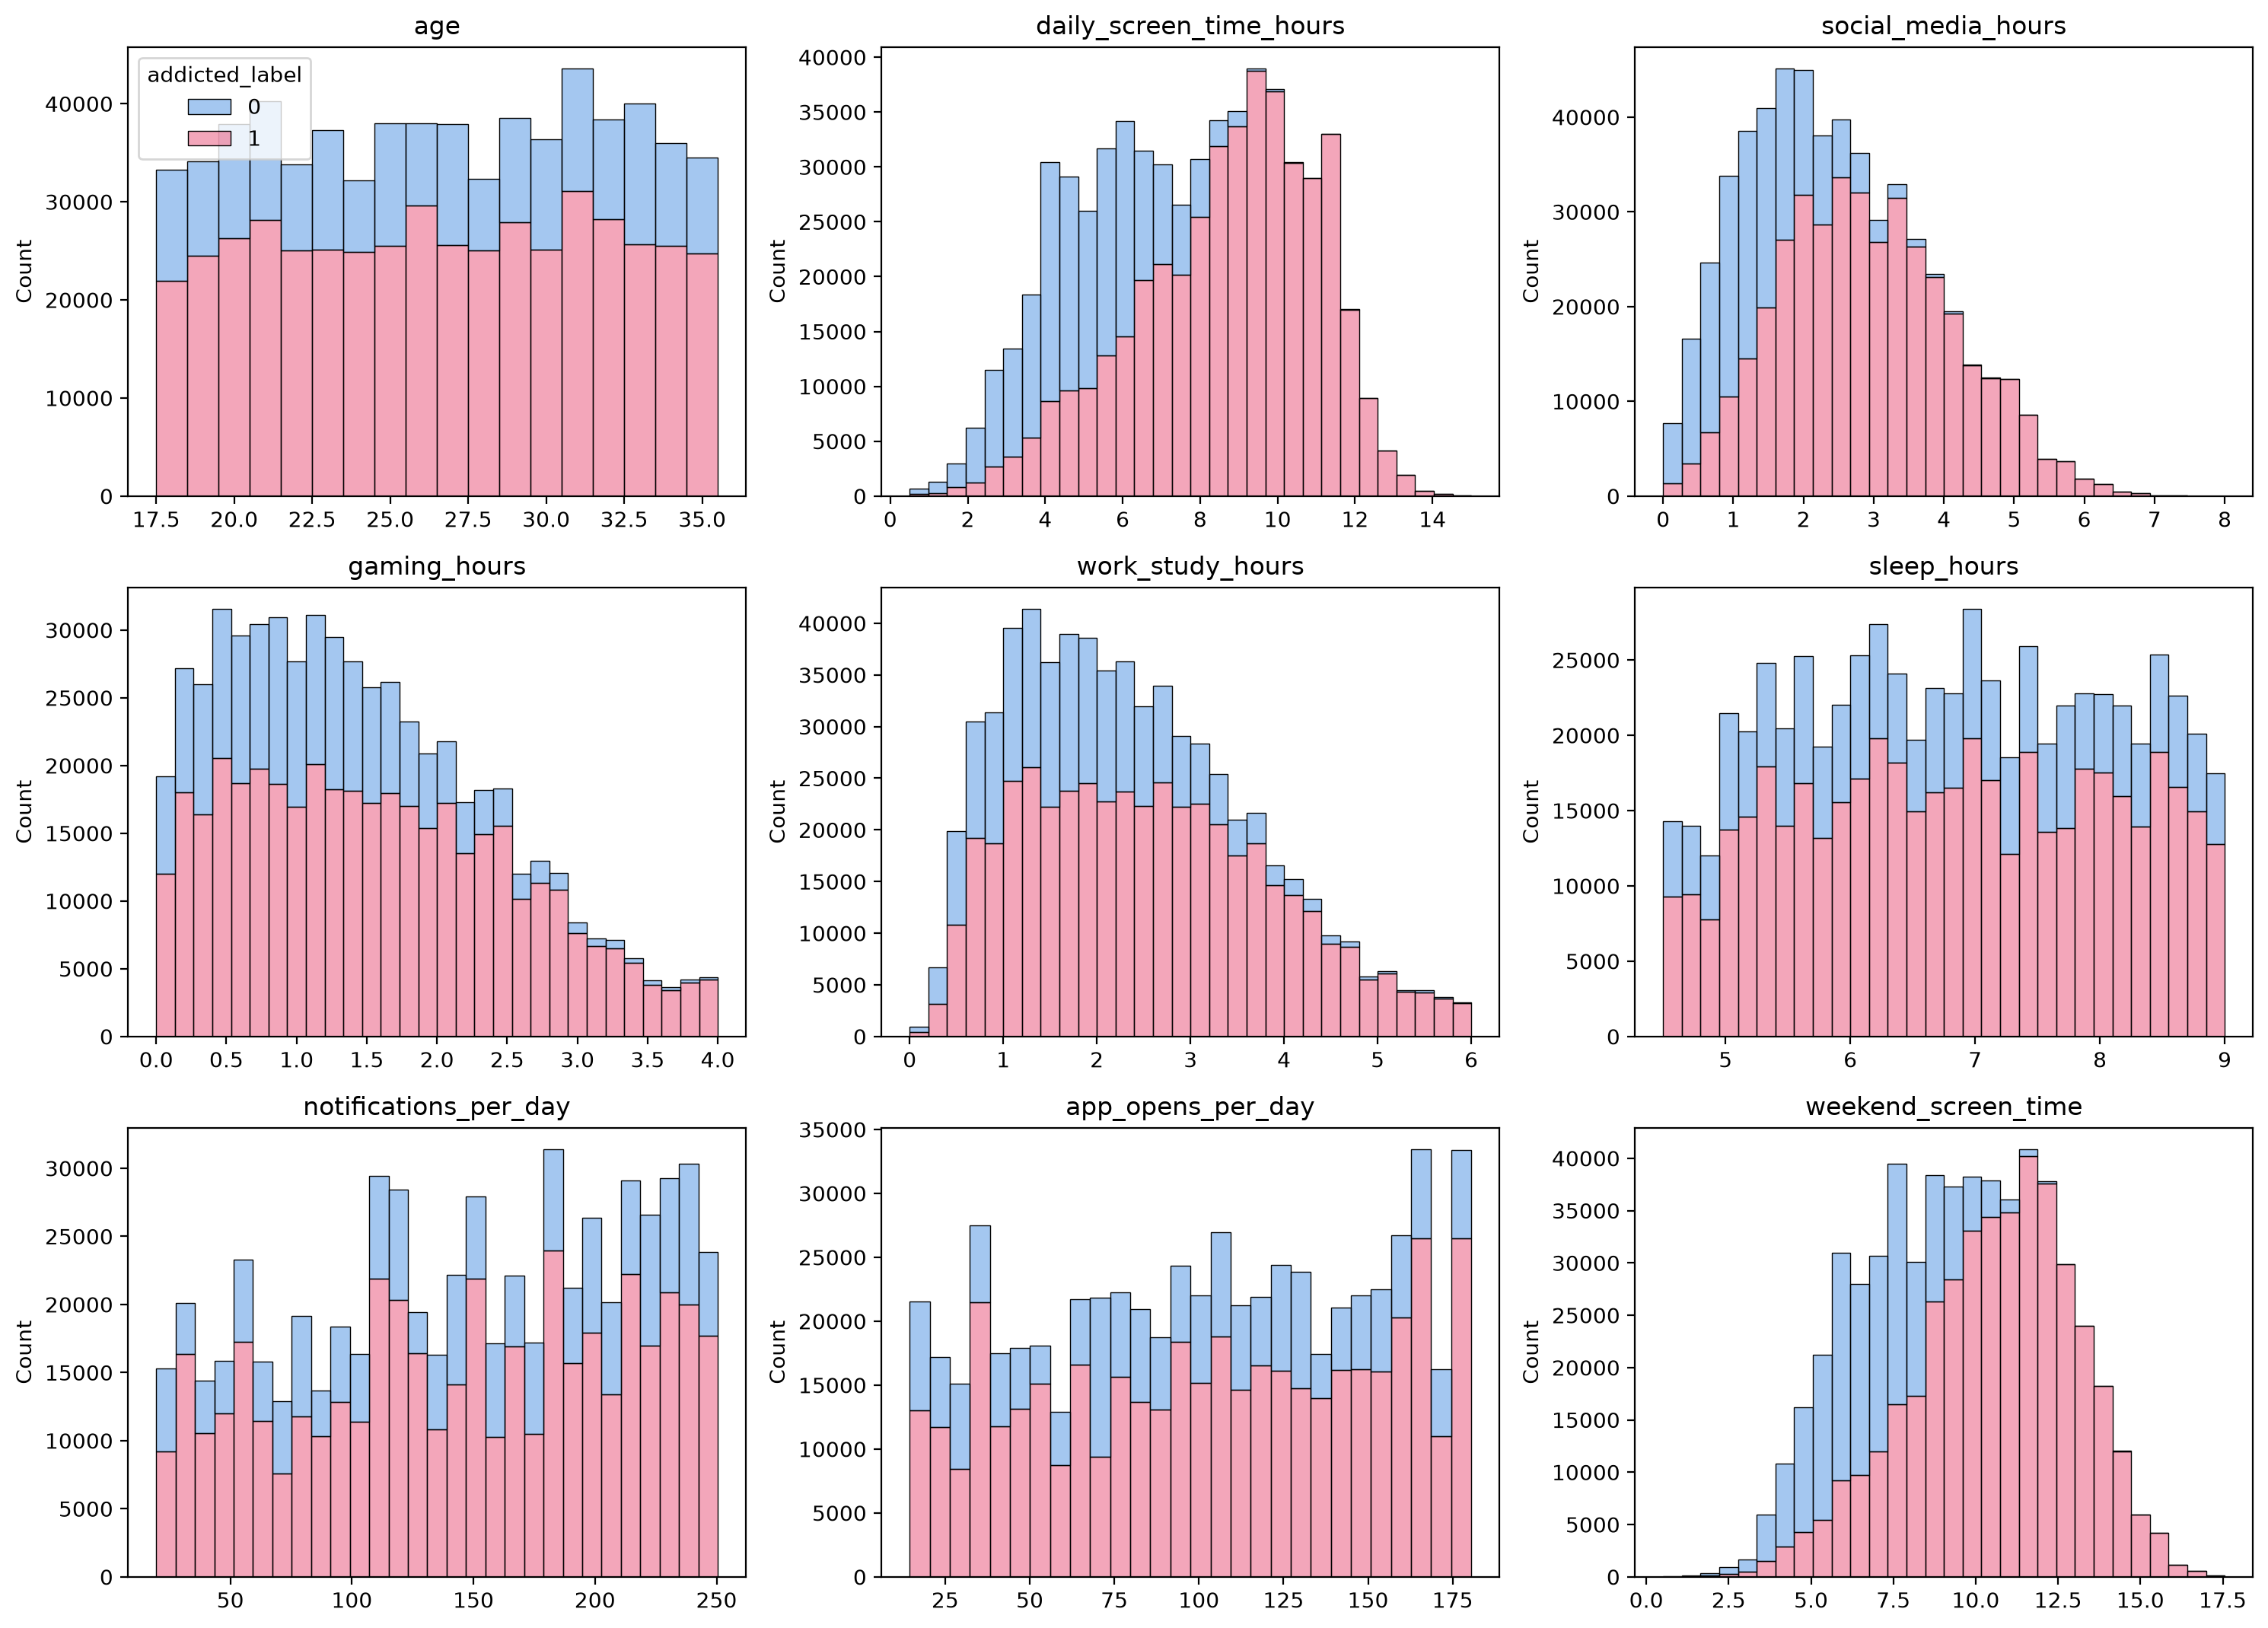
- このグラフを使う理由
- 列の分布の形(山の位置・裾・途切れ方)を見るには、ヒストグラムが基本である。さらに 0 と 1 で塗り分けて積み上げると、同じ 1 枚で目的変数との関係も見える。
describe()の表では、途切れ方や山の数は分からない。 - 何を見るか
- ① 最大値や最小値の手前で、件数が残ったまま途切れていないか(上限・下限で切られた値)。② 値が大きくなると、赤の割合が増えるか減るか(目的変数との関係)。
- 見方
- 1 つの枠が 1 列。横軸は列の値、縦軸は件数。0(青)の上に 1(赤)を積み上げていて、棒全体の高さがその区間の件数、赤の割合がその区間の陽性率である。
gaming_hours の最大値が 4.0、work_study_hours が 6.0、social_media_hours が 8.0 と、キリのよい数字で止まっている。図 1.2 のヒストグラムで見ると、この 3 列の止まり方は違う。gaming_hours と work_study_hours は、最大値の直前の区間にも 3,000 件以上が残ったまま、そこで途切れている。「4 時間以上」「6 時間以上」をまとめて切ったような形なので、第4章で比率や差分を作るときに留意する。一方 social_media_hours は、7 時間を過ぎると件数が 0 に近づき、8.0 の手前の区間には数件しかない。これは自然な裾で、切られた形ではない。age(18〜35)・sleep_hours(4.5〜9.0)・notifications_per_day(20〜250)・app_opens_per_day(15〜180)は、区間ごとの凸凹はあるものの、範囲の両端まで件数が大きく減らずに続き、端で途切れる。決まった範囲の中から値が作られた列と読める。木モデルを使う限り、対数変換や標準化はしない。
図 1.2 では、色の分かれ方も列によって違う。daily_screen_time_hours・weekend_screen_time・social_media_hours は、値が小さい区間では青が多く、値が大きい区間ではほぼ赤だけになる。age・sleep_hours・notifications_per_day・app_opens_per_day は、どの区間でも赤が 7 割前後で、割合がほとんど変わらない。どの列が効きそうかの見当がここでつくので、1-7 で数値として確かめる。
次の 1-6 では、カテゴリ列ごとに目的変数の陽性率を見る。
1-6カテゴリごとの件数と陽性率を比べる
次にやること
前の節で数値列の値の範囲が分かった。次はカテゴリ列について、カテゴリごとの「件数」と「陽性率」を同時に集計し、その列に予測の手がかりがあるかを確かめる。集計した表は、カテゴリごとに 0 と 1 の割合を積み上げた棒グラフにもする。
理由
件数と陽性率をセットで見る:陽性率だけを見ると、数件しかないカテゴリでたまたま陽性率 100% になっているような、見かけだけの差にだまされる。件数が十分にあって初めて、陽性率の差が信頼できる。この考え方は第4章 4-8 の Target Encoding のスムージングにつながる。
「効かない」と分かることにも価値がある(第4章 4-5、第6章 6-2 につながる):予測力のない列だと分かっていれば、第4章でカテゴリ同士の掛け合わせや複雑な集約特徴量を作って時間を使うことを避けられる(第4章 4-5 で確かめる)。また第6章 6-2 で、カテゴリの扱いが得意な CatBoost でも、その得意な処理を使わずに済ませてよい理由の説明にもなる。
割合の棒に、全体の陽性率の線を引く:棒の高さを 1(100%)にそろえ、下から 0 の割合(青)、その上に 1 の割合(赤)を積む。青と赤の境目が、そのカテゴリの陽性率の位置になる。全体の陽性率の位置に点線を引けば、境目が点線から上下にずれたカテゴリが、陽性率が全体と違うカテゴリである。棒の上には件数 n を書き、件数と陽性率を一緒に見る。
種類の多い列は描かない:名前やチケット番号のように種類が数百ある列を棒グラフにすると、棒が多すぎて読めない。そうした列は第4章で加工してから扱う(4-7)ので、ここでは種類が 20 以下の列だけを描く。
コード
for c in cat_cols:
    print(
        train.group_by(c)
        .agg(pl.len().alias("n"),
             pl.col(TARGET).mean().round(4).alias("rate"))
        .sort(c)
    )
次に、同じ集計を積み上げ棒グラフにする。
_plot_cols = [c for c in cat_cols if train[c].n_unique() <= 20]   # 種類が多すぎる列は描かない
_rate_all = train[TARGET].to_numpy().mean()

_fig, _axes = plt.subplots(1, len(_plot_cols), figsize=(4.5 * len(_plot_cols), 3.8), squeeze=False)
for _ax, _c in zip(_axes[0], _plot_cols):
    _t = (
        train.group_by(_c)
        .agg(pl.len().alias("n"), pl.col(TARGET).mean().alias("rate"))
        .with_columns(pl.col(_c).cast(pl.String).fill_null("null"))   # 欠損も 1 本の棒にする
        .sort(_c)
    )
    _ax.bar(_t[_c], 1 - _t["rate"], color=C0, alpha=0.5, edgecolor="black", label="0")    # 下に 0 の割合
    _ax.bar(_t[_c], _t["rate"], bottom=1 - _t["rate"], color=C1, alpha=0.5, edgecolor="black",
            label="1")                                                                         # 上に 1 の割合
    _ax.axhline(1 - _rate_all, color="black", linestyle="--", linewidth=1)    # 全体の陽性率の位置
    for _x, _n in enumerate(_t["n"]):
        _ax.text(_x, 1.02, f"n={_n:,}", ha="center", fontsize=8)
    _ax.set_ylim(0, 1.12)
    _ax.set_title(_c, fontweight="bold")
_axes[0, -1].legend(title=TARGET, loc="upper left", bbox_to_anchor=(1, 1))
_fig.tight_layout()
_figdf.group_by(col) | 列の値ごとにグループ化する(Polars では null も 1 グループとして残る) |
|---|---|
pl.len().alias("n") | 各グループの件数を数える |
pl.col(TARGET).mean().alias("rate") | 各グループの目的変数の平均(=陽性率)を計算する |
df.sort(col) | カテゴリ名の順に並べて見やすくする |
df[c].n_unique() | 種類の数を数える。20 以下の列だけを描く |
ax.bar(x, 高さ, bottom=下端) | bottom を指定すると、その高さから上に棒を積む。0 の割合の上に 1 の割合を積むのに使う |
ax.axhline(y, linestyle="--") | 横に点線を引く。ここでは全体の陽性率の位置(1 − 0.7094)に引く |
ax.text(x, y, 文字) | グラフの好きな位置に文字を書く。棒の上に件数を書くのに使う |
ax.legend(bbox_to_anchor=(1, 1)) | 凡例を、右端のグラフの外側に置く |
結果
┌────────┬────────┬────────┐
│ gender ┆ n      ┆ rate   │
╞════════╪════════╪════════╡
│ null   ┆ 29034  ┆ 0.7088 │
│ Female ┆ 221595 ┆ 0.7038 │
│ Male   ┆ 223662 ┆ 0.7232 │
│ Other  ┆ 217078 ┆ 0.701  │
└────────┴────────┴────────┘
┌──────────────┬────────┬────────┐
│ stress_level ┆ n      ┆ rate   │
╞══════════════╪════════╪════════╡
│ null         ┆ 55148  ┆ 0.709  │
│ High         ┆ 220873 ┆ 0.7114 │
│ Low          ┆ 207783 ┆ 0.7112 │
│ Medium       ┆ 207565 ┆ 0.7057 │
└──────────────┴────────┴────────┘
┌──────────────────────┬────────┬────────┐
│ academic_work_impact ┆ n      ┆ rate   │
╞══════════════════════╪════════╪════════╡
│ null                 ┆ 44224  ┆ 0.7095 │
│ No                   ┆ 316579 ┆ 0.711  │
│ Yes                  ┆ 330566 ┆ 0.7079 │
└──────────────────────┴────────┴────────┘
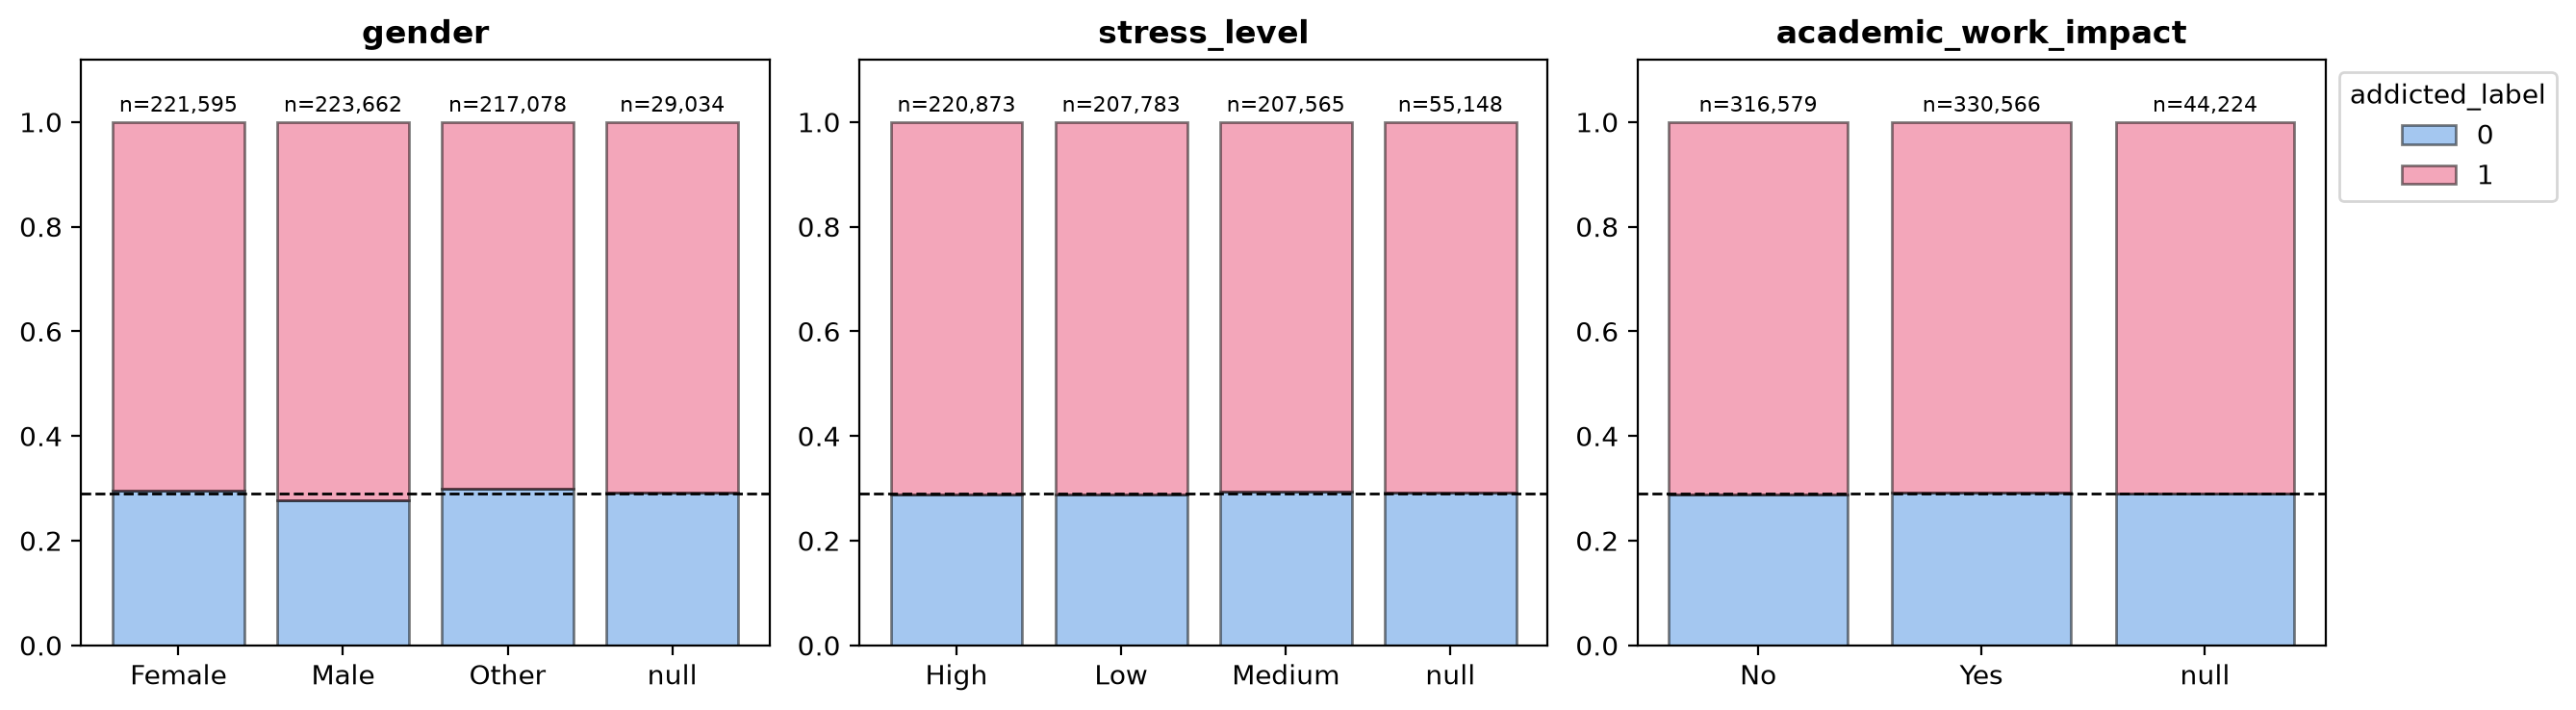
- このグラフを使う理由
- カテゴリごとに件数が違うので、件数の棒ではなく、高さを 100% にそろえた割合の棒にする。こうすると、カテゴリどうしの陽性率を同じ物差しで比べられる。件数は棒の上に書き、少なすぎるカテゴリを見落とさないようにする。
- 何を見るか
- 青と赤の境目が、点線(全体の陽性率)からどれだけ上下にずれているか。ずれが大きく、件数 n も十分なカテゴリがあれば、その列は予測の手がかりになる。
- 見方
- 1 つの枠が 1 列、1 本の棒が 1 つのカテゴリ(
nullは欠損)。縦軸は割合で、下の青が 0、上の赤が 1。黒い点線は全体の陽性率の位置、棒の上の n は件数である。
3 つのカテゴリ列(gender, stress_level, academic_work_impact)は、どのカテゴリも 20 万件以上の件数があるのに、陽性率は全体平均 0.7094 の前後 ±0.015 以内(0.701〜0.723)に収まっている。件数が足りないのではなく、これらの列は単体では予測にほとんど役立たない、と読める。図 1.4 の積み上げ棒グラフでも、どの棒の青と赤の境目も点線にほぼ重なる。最も離れている gender の Male でも、陽性率 0.7232 と全体の 0.7094 の差は 0.014 で、グラフではほとんど見分けられない。
Polars の group_by は欠損も 1 グループとして扱う。上の null 行がそれで、欠損している人の陽性率がそのまま読める。どの列も null 行の陽性率は全体平均とほぼ同じである。
次の 1-7 では、数値列と目的変数の関係を見る。
1-7数値列を 4 区間に分けて陽性率の変わり方を見る(四分位)
次にやること
前の節で、カテゴリ列は単体ではほとんど効かないと分かった。次は数値列 9 列のそれぞれを四分位(qcut)で同じ件数の 4 区間に分け、区間ごとの陽性率を出して、目的変数との関係の形を見る。全列に同じ集計を回し、1 列 1 行の表にまとめる。続けて、0 と 1 の分布の違いを箱ひげ図(box plot)で見て、最後に数値列同士の相関をヒートマップにする。
理由
相関係数(correlation coefficient)では見えない形がある:ピアソンの相関係数は直線的な関係しか捉えない。U 字型や、ある値を超えると急に確率が上がるような関係は、相関がほぼゼロに見えて見落とされる。区間ごとに陽性率を出せば、曲がった関係やしきい値の位置が直接見える。決定木が学ぶのもこの「しきい値による階段状の形」なので、モデルの見え方に近い確認方法である。
強い列を見つけ、特徴量の仮説を立てる(第4章 4-4 の出発点):1 列だけで陽性率が大きく動く列が見つかれば、ベースラインのスコア水準の見当がつく。また「ほかの時間系の列(work_study_hours など)と組み合わせた比率や差分が効くのではないか」という第4章の特徴量の仮説(4-4)がここから生まれる。
全列を 1 つの表に並べる:1 列ずつ見ていくと、どの列が強いのかを比べにくい。全列の区間ごとの陽性率を 1 つの表に並べ、4 区間の陽性率の最大と最小の差(振れ幅)で並べ替えれば、強い列と弱い列が一目で分かる。相関係数も同じ表に並べ、区間で見た形と食い違う列がないかを確かめる。
欠損行の陽性率を再確認する:区間に分けると、欠損の行も null という 1 つの区間として集計できる。1-4 で述べた「欠損はランダム(MCAR)」かどうかを、ここでも確かめられる。
箱ひげ図で 0 と 1 の分布を並べる:表の陽性率は「その区間の何割が 1 か」を表す。逆に「0 の人と 1 の人で、値の分布がどれだけずれているか」を見るのが箱ひげ図である。箱の下端と上端が 25% 点と 75% 点、箱の中の線が中央値、ひげが箱から箱の長さの 1.5 倍までの範囲で、その外の点が外れ値である。青と赤の箱が上下にずれていれば、その列は 0 と 1 を見分ける手がかりになる。
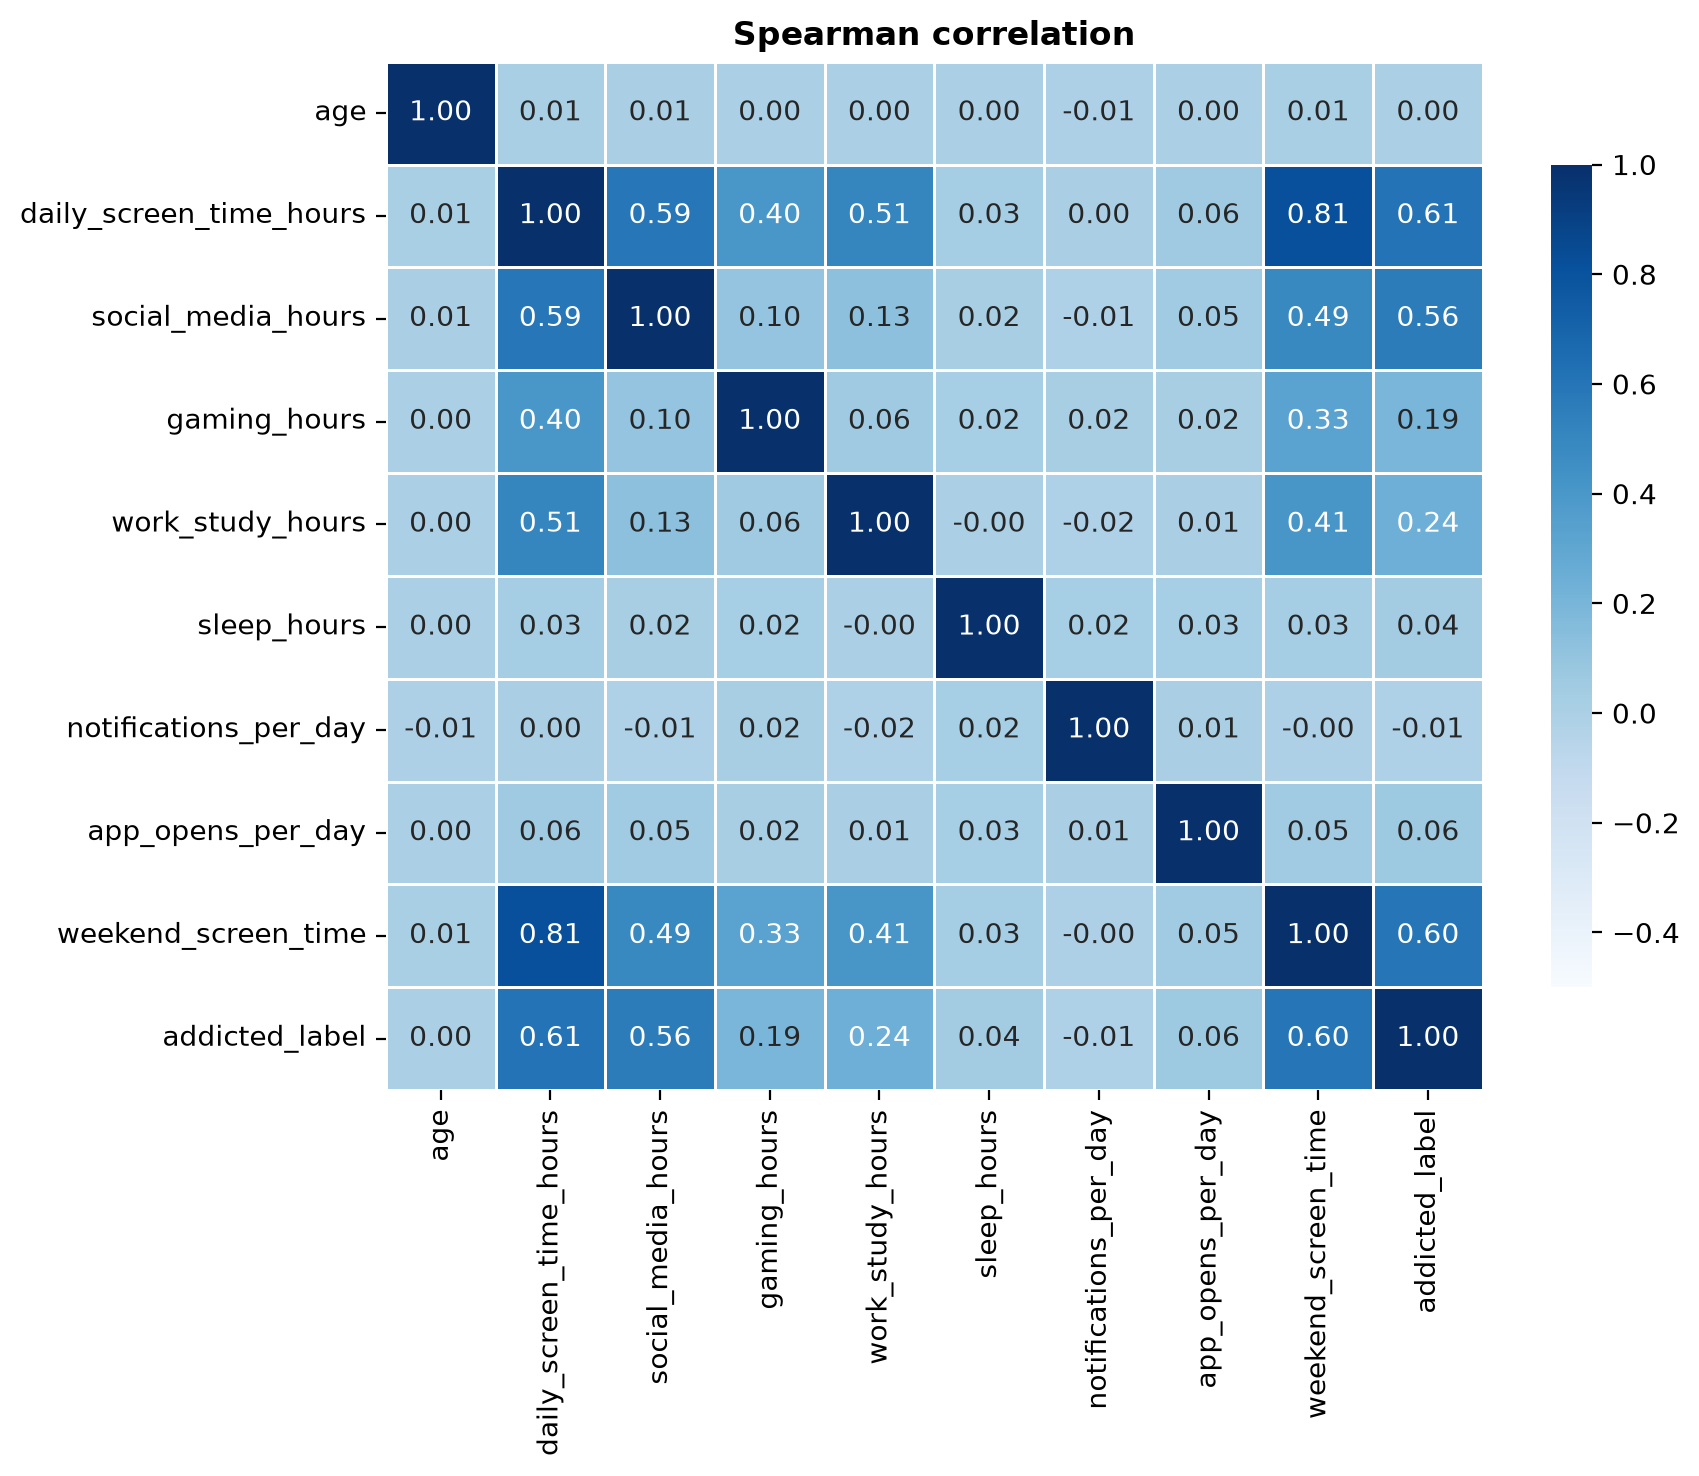
列同士の相関も見る(第4章 4-4 につながる):表の相関係数は、各列と目的変数の関係だけである。列同士が強く相関していれば、同じ情報を 2 回持っていることになる。逆に、合計と内訳のような関係にある列は、比率や差分を作ると新しい情報が取り出せる。ここでは順位で測るスピアマンの相関係数(Spearman correlation)を使う。値の大きさではなく順位の相関なので、曲がっていても単調な関係なら高く出る。相関係数の色は、青の濃淡にする。濃いほど正の相関が強い。このデータには強い負の相関がないので、色の範囲を −0.5〜1 にして、正の側を細かく塗り分ける。
コード
_rows = []
for _c in num_cols:
    _t = (
        train
        .with_columns(
            pl.col(_c).qcut(4, labels=["Q1", "Q2", "Q3", "Q4"], allow_duplicates=True)
            .cast(pl.String).fill_null("null")   # 欠損の行は "null" という区間にする
            .alias("bin")
        )
        .group_by("bin")
        .agg(pl.col(TARGET).mean().alias("rate"))
    )
    _rate = dict(zip(_t["bin"], _t["rate"]))
    _q = [_rate[_b] for _b in ("Q1", "Q2", "Q3", "Q4") if _b in _rate]
    _rows.append({
        "column": _c,
        **{_b: round(_rate[_b], 4) if _b in _rate else None   # 欠損のない列は null 区間がないので None
           for _b in ("Q1", "Q2", "Q3", "Q4", "null")},
        "range": round(max(_q) - min(_q), 4),                      # 4 区間の陽性率の振れ幅
        "corr": round(train.select(pl.corr(_c, TARGET)).item(), 4),  # ピアソン相関
    })

print(pl.DataFrame(_rows).sort("range", descending=True))
次に、数値列ごとに 0 と 1 の箱ひげ図を並べる。
_pdf = train.select(num_cols + [TARGET]).to_pandas()
_nrow = (len(num_cols) + 2) // 3

_fig, _axes = plt.subplots(_nrow, 3, figsize=(15, 3.6 * _nrow), squeeze=False)
for _ax, _c in zip(_axes.ravel(), num_cols):
    sns.boxplot(data=_pdf, x=TARGET, y=_c, hue=TARGET, palette={0: C0, 1: C1},
                saturation=1, legend=False, fliersize=1, linecolor="black",
                boxprops={"alpha": 0.5}, ax=_ax)   # 箱は半透明、線は黒(ほかの図と同じ見た目)
    _ax.set_title(_c)
    _ax.set_ylabel("")
for _ax in _axes.ravel()[len(num_cols):]:
    _ax.set_visible(False)
_fig.tight_layout()
_fig
最後に、数値列と目的変数のスピアマン相関をヒートマップにする。
_corr = train.select(num_cols + [TARGET]).to_pandas().corr(method="spearman")

_fig, _ax = plt.subplots(figsize=(9, 7.5))
sns.heatmap(_corr, annot=True, fmt=".2f", cmap="Blues", vmin=-0.5, vmax=1.0,
            linewidths=0.5, cbar_kws={"shrink": 0.8}, ax=_ax)
_ax.set_title("Spearman correlation", fontweight="bold")
_fig.tight_layout()
_figpl.col(c).qcut(4, labels=[...]) | 値を四分位で 4 つの同件数の区間に分け、ラベルを付ける |
|---|---|
allow_duplicates=True | 同じ値が多く分位点が重なるときのエラーを避ける |
.cast(pl.String).fill_null("null") | 区間のラベルを文字列にし、欠損の行を "null" という名前の区間にする |
dict(zip(keys, values)) | 区間名から陽性率を引ける辞書にする。欠損のない列には "null" の区間がないので、辞書にない区間は None にする |
pl.corr(a, b) | 2 列のピアソン相関係数を出す。欠損のある行は除いて計算される |
df.sort(col, descending=True) | 振れ幅の大きい順に並べる |
sns.boxplot(data, x=TARGET, y=列, hue=TARGET) | 目的変数の 0 と 1 ごとに箱ひげ図を描く。hue と palette で 0 を青、1 を赤にし、saturation=1 で指定した色をそのまま使う。fliersize は外れ値の点の大きさ |
pandas_df.corr(method="spearman") | 全列の組み合わせのスピアマン相関係数を表にする。欠損は組み合わせごとに除いて計算される |
sns.heatmap(表, annot=True, fmt=".2f", cmap="Blues", vmin=-0.5, vmax=1.0) | 表を青の濃淡で描く。annot=True でマスに値を書き、vmin・vmax で色の範囲を −0.5〜1 に固定する。linewidths はマスの区切り線、cbar_kws={"shrink": 0.8} は右の色の目盛りの長さ |
結果
┌─────────────────────────┬────────┬────────┬────────┬────────┬────────┬────────┬─────────┐
│ column                  ┆ Q1     ┆ Q2     ┆ Q3     ┆ Q4     ┆ null   ┆ range  ┆ corr    │
╞═════════════════════════╪════════╪════════╪════════╪════════╪════════╪════════╪═════════╡
│ daily_screen_time_hours ┆ 0.3056 ┆ 0.5875 ┆ 0.9463 ┆ 0.9985 ┆ 0.7113 ┆ 0.693  ┆ 0.6114  │
│ weekend_screen_time     ┆ 0.3124 ┆ 0.606  ┆ 0.9226 ┆ 0.9979 ┆ 0.7107 ┆ 0.6855 ┆ 0.5899  │
│ social_media_hours      ┆ 0.3231 ┆ 0.6488 ┆ 0.8825 ┆ 0.9864 ┆ 0.7094 ┆ 0.6633 ┆ 0.5324  │
│ work_study_hours        ┆ 0.6026 ┆ 0.6268 ┆ 0.7242 ┆ 0.8852 ┆ 0.7106 ┆ 0.2826 ┆ 0.2514  │
│ gaming_hours            ┆ 0.6408 ┆ 0.6262 ┆ 0.7043 ┆ 0.866  ┆ 0.7105 ┆ 0.2399 ┆ 0.2053  │
│ app_opens_per_day       ┆ 0.6945 ┆ 0.6762 ┆ 0.7127 ┆ 0.7526 ┆ 0.7128 ┆ 0.0764 ┆ 0.0635  │
│ sleep_hours             ┆ 0.6756 ┆ 0.7197 ┆ 0.6985 ┆ 0.743  ┆ 0.7134 ┆ 0.0675 ┆ 0.0425  │
│ notifications_per_day   ┆ 0.7084 ┆ 0.7231 ┆ 0.709  ┆ 0.6967 ┆ 0.7102 ┆ 0.0264 ┆ -0.0116 │
│ age                     ┆ 0.7016 ┆ 0.7129 ┆ 0.7238 ┆ 0.6992 ┆ 0.7134 ┆ 0.0246 ┆ 0.004   │
└─────────────────────────┴────────┴────────┴────────┴────────┴────────┴────────┴─────────┘
強い列は 3 つある。daily_screen_time_hours(振れ幅 0.693)、weekend_screen_time(0.6855)、social_media_hours(0.6633)は、どれも Q1 の 0.31〜0.32 から Q4 の 0.99〜1.00 まで単調に増える。平日・休日・SNS の画面時間の 3 列が、ほぼ同じ強さで効いている。
中くらいの列が 2 つある。work_study_hours(0.2826)と gaming_hours(0.2399)は、Q1〜Q2 ではほぼ横ばいで、Q3・Q4 で上がる。値が大きい側でだけ効く形である。残りの app_opens_per_day・sleep_hours・notifications_per_day・age は振れ幅が 0.08 未満で、単体ではほとんど効かない。
相関係数の大小は、振れ幅の順とほぼ同じである。このデータには、U 字型のように相関係数では見落とす形の列はなかった。
欠損行の陽性率(null の列)は 9 列とも 0.7094〜0.7134 で、全体平均 0.7094 に近い。どの数値列でも、欠損している人の陽性率は全体と変わらない。1-4 で述べた「欠損はランダム(MCAR)」と矛盾しない結果である。
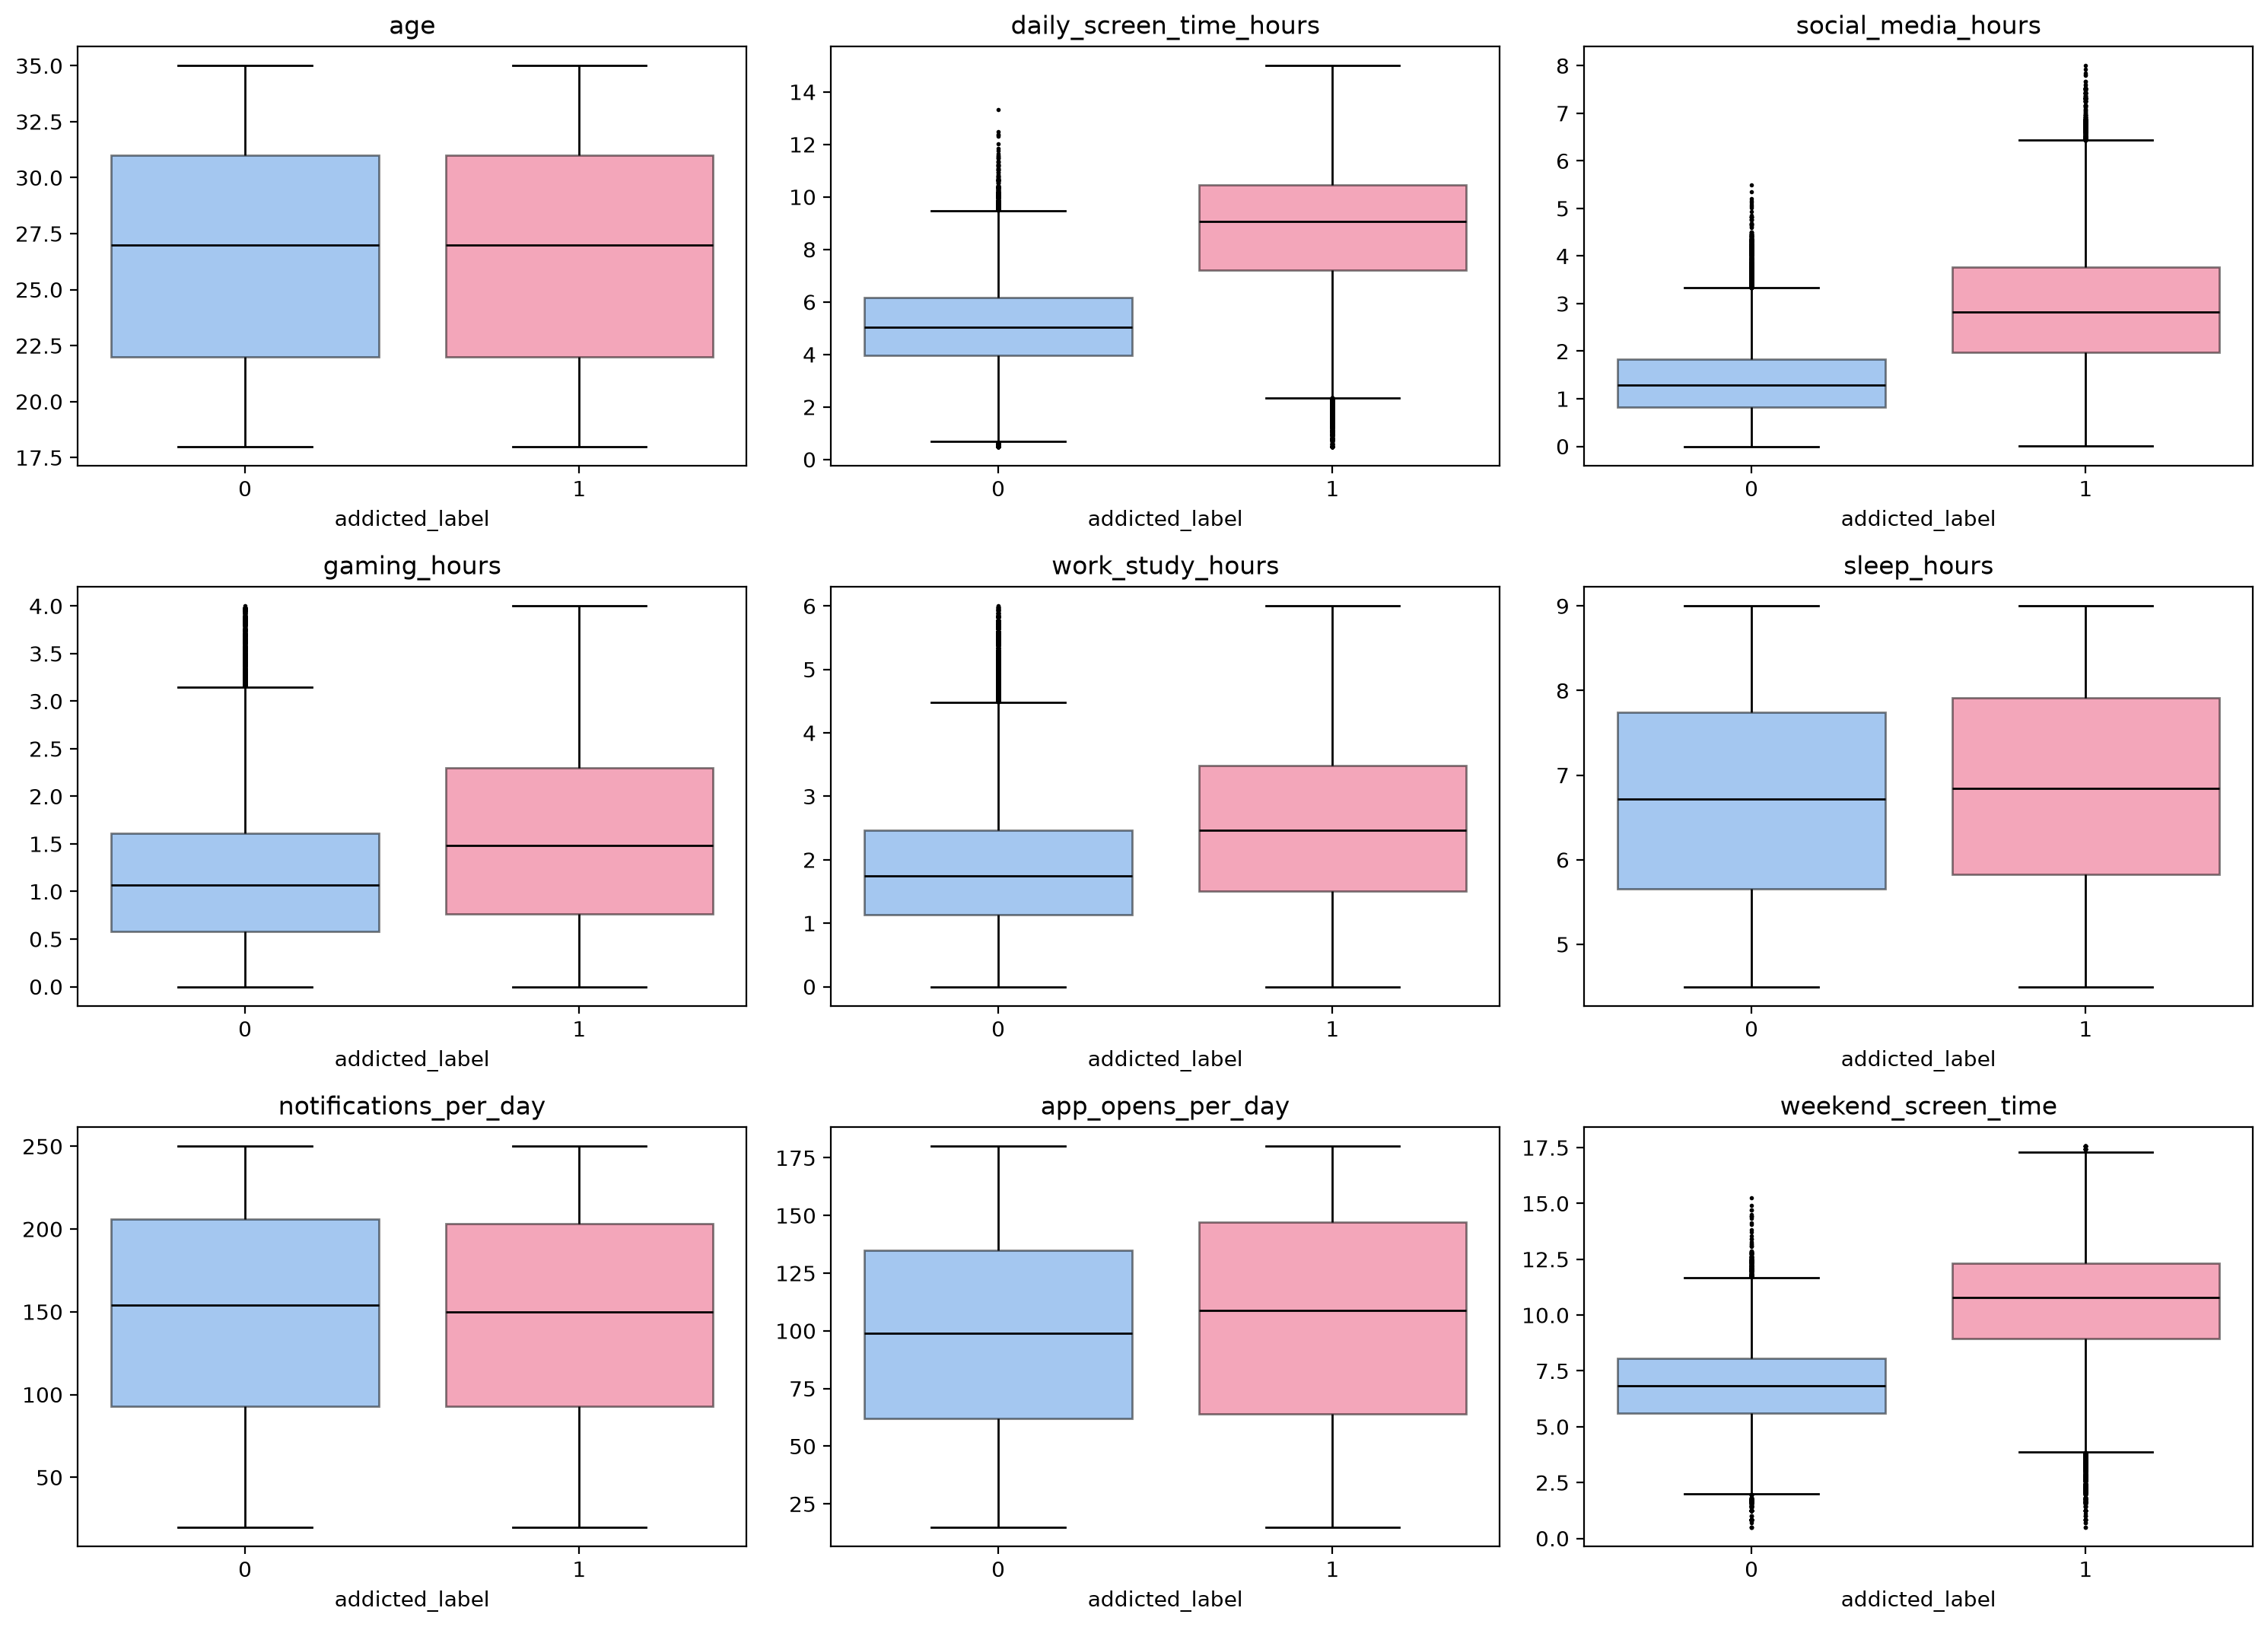
- このグラフを使う理由
- 1-7 の表は「区間ごとに何割が 1 か」を見た。逆向きに「0 の人と 1 の人で、値の分布がどれだけずれているか」を見るには、2 つの分布を横に並べて比べられる箱ひげ図が向いている。9 列を同じ形で並べられるのも利点である。
- 何を見るか
- 青と赤の箱が上下にずれているか、重なっているか。箱が重ならないほどずれていれば、その列 1 つで 0 と 1 をかなり見分けられる。
- 見方
- 1 つの枠が 1 列。横軸は目的変数(青が 0、赤が 1)、縦軸は列の値。箱の下端・中の線・上端が 25% 点・中央値・75% 点で、ひげは箱の長さの 1.5 倍までの範囲、その外の点は外れ値である。
図 1.5 の箱ひげ図では、表で強いと分かった 3 列の青と赤の箱が、上下に重ならない。daily_screen_time_hours は 0 の中央値が 5.04、1 の中央値が 9.07 で、0 の箱の上端(75% 点 6.16)が 1 の箱の下端(25% 点 7.21)より下にある。weekend_screen_time(中央値 6.82 と 10.79)と social_media_hours(1.29 と 2.82)も同じである。gaming_hours(1.07 と 1.48)と work_study_hours(1.75 と 2.47)は、箱が大きく重なりながら、1 のほうが上にずれている。残りの 4 列は箱がほぼ同じ高さにあり、age は 25% 点・中央値・75% 点(22・27・31)が 0 と 1 で全く同じである。表の振れ幅の順と同じ結果である。
- このグラフを使う理由
- 9 列と目的変数の 10 列どうしの相関は 45 組あり、表で読むのは大変である。色の濃さにすると、強く相関している組がすぐに見つかる。値の大きさではなく順位で測るスピアマン相関にして、曲がっていても単調な関係を拾う。
- 何を見るか
- ① 最下行で、目的変数と強く相関する列。② 目的変数以外の列どうしで濃いマス。合計と内訳のように強く相関する組は、比率や差分の特徴量の候補になる(第4章 4-4)。
- 見方
- 縦と横に同じ列が並び、マスの数字は 2 つの列の順位相関係数(-1〜1)。青が濃いほど正の相関が強い。色の範囲は −0.5〜1 で、相関が 0 付近のマスは薄い水色になる。対角線は自分自身との相関なので 1 である。
図 1.6 のヒートマップの最下行(addicted_label)の値の大小の順は、表の corr と同じである(daily_screen_time_hours 0.61、weekend_screen_time 0.60、social_media_hours 0.56)。列同士では、daily_screen_time_hours と weekend_screen_time の相関が 0.81 と最も高い。平日と休日の画面時間は、ほぼ同じ情報を持っている。daily_screen_time_hours は social_media_hours(0.59)・work_study_hours(0.51)・gaming_hours(0.40)とも相関している。1 日の画面時間の中に、SNS・勉強や仕事・ゲームの時間が含まれている可能性がある。合計と内訳の関係なら、「画面時間のうち勉強や仕事が占める割合」のような比率や差分を作ると、新しい情報を取り出せる見込みがある。これは第4章 4-4 で試す。一方、age・sleep_hours・notifications_per_day・app_opens_per_day は、どの列との相関も絶対値で 0.06 以下である。
次の 1-8 では、train と test の分布に差がないかを確かめる。
1-8train と test の分布差を確認する(Adversarial Validation)
次にやること
前の節までで、train の中の傾向が分かった。次は、train で学習したモデルが test でも通用するかを確かめるため、両者の分布にずれ(共変量シフト、covariate shift)がないかを敵対的検証(Adversarial Validation)で調べる。ずれが見つかったら、欠損率と値の分布を train と test で並べたグラフで、ずれの中身を確かめる。
理由
敵対的検証の考え方と判断の目安:CV のスコアがよくても、train と test の分布が違えば、本番の test(LB)ではスコアが大きく下がることがある。敵対的検証では「train か test か」を当てる分類モデルを学習させる。両者の分布が同じなら、モデルは区別できず AUC は 0.50 付近(ランダムな推測)になる。AUC が 0.60 や 0.70 を超えるなら、train と test を見分けられる列があり、分布がずれていることを意味する。0.50 と 0.60 の間なら小さなずれがあるので、何で見分けているのかを調べてから判断する。
ID 列は必ず除く:id 列を入れたまま実行すると AUC は 1.0 になる。ID は train(0〜691,368)と test(691,369〜)で番号の範囲が分かれているので、ID だけで train と test を見分けられてしまうからである。ID 列を除いた特徴量だけで実行する。
Playground コンペでも確認する理由:Kaggle Playground Series は、通常は同じ生成モデルから train と test がまとめて作られているので、分布差はほとんどなく AUC は 0.50 付近になることが多い。それでも初日に確かめる価値がある。ずれの有無と、ずれがあるならその中身が分かっていれば、後で「CV が上がったのに LB が下がった」ときに、原因が分布のずれなのか、自分の特徴量のリークや検証設計のミスなのかを切り分けられるからである。
ずれの中身を切り分ける:AUC が 0.50 から離れたら、値の分布が違うのか、欠損の起き方が違うのかを分けて調べる。列ごとの欠損率を train と test で並べ、さらに「欠損かどうか(0/1)だけ」と「欠損のない行の値だけ」でそれぞれ敵対的検証を行う。どちらで見分けられるかで、ずれの中身が分かる。
重要度だけで原因の列を決めない:敵対的検証のモデルの特徴量の重要度(feature importance)を見ると、見分けるのに使った列が分かる。ただし、分布がほとんど同じとき、モデルは偶然の差を拾って、値の種類が多い数値列を広く使う。重要度が数列に横並びなら、特定の列のせいではないと読み、上の切り分けに進む。
値の分布は 1 列ずつ重ねて見る(KS 統計量・PSI):欠損を除いた値の分布を、train と test で重ねて描く。数値列は密度の曲線(KDE:kernel density estimation。ヒストグラムを滑らかにしたもの)を重ね、2 つの分布の累積の割合の差の最大値である KS 統計量(Kolmogorov–Smirnov statistic)を添える。0 なら同じ分布で、0.1 を超えると目で見ても分かるずれになる。カテゴリ列は割合の棒を並べ、PSI(Population Stability Index)を添える。PSI は各カテゴリの割合の差に、割合の比の対数を掛けて足したもので、0.1 未満なら安定、0.25 以上なら大きなずれとみなす。
サンプルを抜いて回す:1-1 で見たとおり行数が多いので、train と test から 30,000 行ずつ抜き出して計算時間を抑える。どちらかが 30,000 行より少ないデータ(Titanic など)では、少ないほうの行数にそろえて抜き出す。
コード
# np・LGBMClassifier・StratifiedKFold・roc_auc_score は 1-1 でインポート済み
n = min(30_000, train.height, test.height)   # 小さいデータでは、少ないほうの行数にそろえる
tr = train.drop([ID, TARGET]).sample(n=n, seed=42)
te = test.drop(ID).sample(n=n, seed=42)

# age などは train が整数・test が小数と型が違うので、vertical_relaxed で型をそろえてつなぐ
X_adv = pl.concat([tr, te], how="vertical_relaxed").with_columns(
    [pl.col(c).cast(pl.Categorical) for c in cat_cols]
).to_pandas()
y_adv = np.r_[np.zeros(n), np.ones(n)]

scores = []
for tr_i, va_i in StratifiedKFold(3, shuffle=True, random_state=42).split(X_adv, y_adv):
    m = LGBMClassifier(n_estimators=200, verbose=-1).fit(X_adv.iloc[tr_i], y_adv[tr_i])
    # np.asarray で配列にそろえてから、陽性クラスの列を取る(理由は 3-4)
    scores.append(roc_auc_score(y_adv[va_i], np.asarray(m.predict_proba(X_adv.iloc[va_i]))[:, 1]))

print("adversarial AUC:", round(np.mean(scores), 4))
# 0.50 付近 → 同一分布。0.60 以上 → 分布のずれを調査
続けて、最後の Fold のモデル m が、どの列を使って見分けたかを棒グラフにする。
_imp = pl.DataFrame({
    "column": X_adv.columns,
    "gain": m.booster_.feature_importance("gain"),   # その列の分岐で、損失がどれだけ減ったかの合計
}).sort("gain")

_fig, _ax = plt.subplots(figsize=(7, 4))
_ax.barh(_imp["column"], _imp["gain"], color="#4A90E2", edgecolor="black")
_ax.set_title("adversarial validation: importance (gain, last fold)", fontweight="bold")
_fig.tight_layout()
_fig| 敵対的検証(自作) | 「train か test か」を当てる分類モデルを作り、その AUC を測る |
|---|---|
pl.concat([a, b], how="vertical_relaxed") | 縦に結合する。列の型が違うとき(整数と小数など)は、広いほうの型にそろえてからつなぐ。敵対的検証のデータ作りに使う |
df.sample(n=..., seed=...) | 大きなデータから検証用のサンプルを抜き出す |
m.booster_.feature_importance("gain") | LightGBM の特徴量の重要度。"gain" は、その列での分岐が損失をどれだけ減らしたかの合計で、使った回数("split")より効き方の大きさを表す |
ax.barh(名前, 値) | 横向きの棒グラフを描く。列名が長いときに読みやすい |
次に、ずれの中身を切り分ける。列ごとの欠損率を train と test で比べ、欠損フラグだけ・欠損のない行だけで敵対的検証をやり直す。
_feat = [c for c in test.columns if c != ID]

# ① 列ごとの欠損率(%)を train と test で並べる(次のグラフでも使うので null_cmp に入れる)
null_cmp = (
    pl.DataFrame({
        "column": _feat,
        "train_null_pct": [round(train[c].null_count() / train.height * 100, 2) for c in _feat],
        "test_null_pct": [round(test[c].null_count() / test.height * 100, 2) for c in _feat],
    })
    .with_columns((pl.col("test_null_pct") - pl.col("train_null_pct")).round(2).alias("diff"))
    .sort("diff")
)
print(null_cmp)

def _adv_auc(X: pl.DataFrame, y: np.ndarray) -> float:
    """上と同じ 3-Fold の敵対的検証を行い、AUC の平均を返す。"""
    _Xp = X.to_pandas()
    _s = []
    for _tr, _va in StratifiedKFold(3, shuffle=True, random_state=42).split(_Xp, y):
        _m = LGBMClassifier(n_estimators=200, verbose=-1).fit(_Xp.iloc[_tr], y[_tr])
        _s.append(roc_auc_score(y[_va], np.asarray(_m.predict_proba(_Xp.iloc[_va]))[:, 1]))
    return round(float(np.mean(_s)), 4)

# ② 欠損かどうか(0/1)だけで当てる
_flags = pl.concat([tr, te], how="vertical_relaxed").select(
    [pl.col(c).is_null().cast(pl.Int8) for c in _feat]
)
print("欠損フラグだけ  :", _adv_auc(_flags, y_adv))

# ③ 欠損のない行だけで、値から当てる
_tr_c, _te_c = tr.drop_nulls(), te.drop_nulls()
_X_c = pl.concat([_tr_c, _te_c], how="vertical_relaxed").with_columns(
    [pl.col(c).cast(pl.Categorical) for c in cat_cols]
)
_y_c = np.r_[np.zeros(_tr_c.height), np.ones(_te_c.height)]
print("欠損のない行だけ:", _adv_auc(_X_c, _y_c))
①の欠損率を、train と test の棒を並べたグラフにする。
_x = np.arange(null_cmp.height)

_fig, _ax = plt.subplots(figsize=(11, 3.8))
_ax.bar(_x - 0.2, null_cmp["train_null_pct"], 0.4, color=C_TRAIN, alpha=0.85, edgecolor="black", label="train")
_ax.bar(_x + 0.2, null_cmp["test_null_pct"], 0.4, color=C_TEST, alpha=0.85, edgecolor="black", label="test")
_ax.set_xticks(_x, null_cmp["column"], rotation=30, ha="right")
_ax.set_ylabel("null %")
_ax.set_title("null ratio by column (train vs test)", fontweight="bold")
_ax.legend()
_fig.tight_layout()
_fig
最後に、欠損を除いた値の分布を、train と test で列ごとに重ねる。最初のセルで抜き出した 30,000 行ずつ(tr・te)を使う。
_cols = num_cols + [c for c in cat_cols if train[c].n_unique() <= 20]
_nrow = (len(_cols) + 3) // 4   # 1 行に 4 つ並べる

_fig, _axes = plt.subplots(_nrow, 4, figsize=(16, 3.4 * _nrow), squeeze=False)
for _ax, _c in zip(_axes.ravel(), _cols):
    _a, _b = tr[_c].drop_nulls(), te[_c].drop_nulls()   # 欠損は ① で見たので、値だけを比べる
    if _c in num_cols:   # 数値列: 密度の曲線を重ね、KS 統計量を出す
        sns.kdeplot(_a.to_numpy(), ax=_ax, color=C_TRAIN, fill=True, alpha=0.3, linewidth=2, label="train")
        sns.kdeplot(_b.to_numpy(), ax=_ax, color=C_TEST, fill=True, alpha=0.3, linewidth=2, label="test")
        _ax.set_title(f"{_c}  KS={ks_2samp(_a.to_numpy(), _b.to_numpy()).statistic:.4f}", fontweight="bold", fontsize=10)
    else:                # カテゴリ列: 割合の棒を並べ、PSI を出す
        _p = (
            _a.value_counts(normalize=True).rename({"proportion": "train"})
            .join(_b.value_counts(normalize=True).rename({"proportion": "test"}),
                  on=_c, how="full", coalesce=True)
            .fill_null(1e-6)   # 片方にしかないカテゴリで、0 で割らないようにする
            .sort(_c)
        )
        _psi = ((_p["train"] - _p["test"]) * (_p["train"] / _p["test"]).log()).sum()
        _xc = np.arange(_p.height)
        _ax.bar(_xc - 0.2, _p["train"], 0.4, color=C_TRAIN, alpha=0.85, label="train")
        _ax.bar(_xc + 0.2, _p["test"], 0.4, color=C_TEST, alpha=0.85, label="test")
        _ax.set_xticks(_xc, _p[_c])
        _ax.set_title(f"{_c}  PSI={_psi:.4f}", fontweight="bold", fontsize=10)
    _ax.set_xlabel("")
    _ax.set_ylabel("")
for _ax in _axes.ravel()[len(_cols):]:
    _ax.set_visible(False)
_axes[0, 0].legend()
_fig.tight_layout()
_figs.null_count() / df.height | 列の欠損率を出す |
|---|---|
pl.col(c).is_null().cast(pl.Int8) | 欠損かどうかを 0/1 の列にする |
def _adv_auc(X: pl.DataFrame, y: np.ndarray) -> float | 引数の後の : pl.DataFrame と -> float は型ヒント。「Polars の表と NumPy 配列を受け取り、小数を返す」ことを書いておく。実行には影響しない。書く範囲は 3-4 で決める |
df.drop_nulls() | どこか 1 列でも欠損している行を除く |
ax.bar(x ± 0.2, 高さ, 0.4) | 幅 0.4 の棒を左右に 0.2 ずつずらし、train と test の棒を横に並べる |
ax.set_xticks(位置, 名前, rotation=30) | 横軸の目盛りに列名を書く。長い名前は斜めにする |
sns.kdeplot(値, fill=True, alpha=0.3) | 密度の曲線(KDE)を描き、下を薄く塗る。2 本重ねても両方見える |
ks_2samp(a, b).statistic | 2 つの分布の KS 統計量。累積の割合の差の最大値で、0 に近いほど同じ分布 |
s.value_counts(normalize=True) | カテゴリごとの割合を出す(列名は proportion) |
df.join(other, on=c, how="full", coalesce=True) | train と test の割合をカテゴリで横に並べる。片方にしかないカテゴリも残す |
| PSI の式 | Σ (train の割合 − test の割合) × log(train の割合 / test の割合)。0.1 未満なら安定 |
結果
adversarial AUC: 0.5453
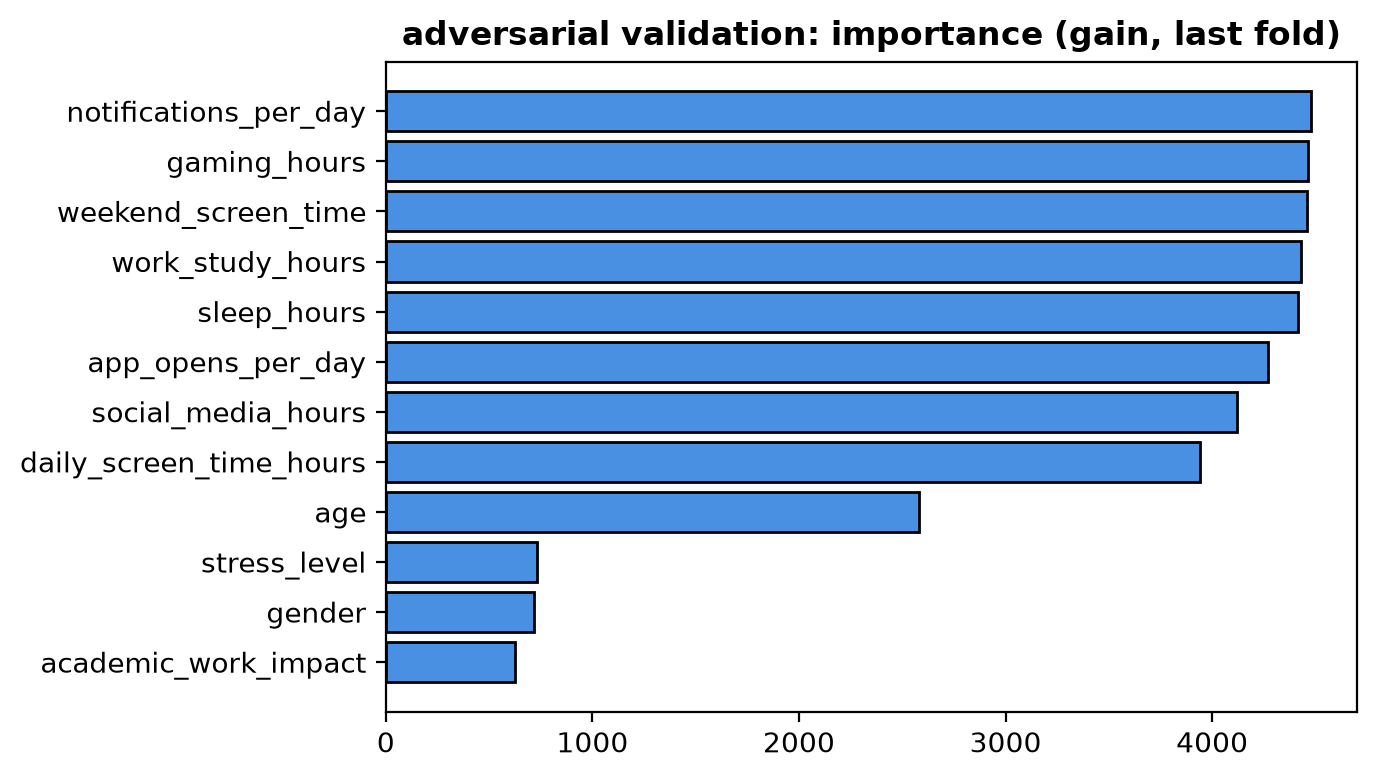
- このグラフを使う理由
- 敵対的検証の AUC は「見分けられるかどうか」しか教えない。どの列で見分けたかの手がかりとして、まずモデルの重要度を見る。列名が長いので横棒にする。
- 何を見るか
- 1〜2 列だけが飛び抜けて長いか、何列も横並びか。飛び抜けた列があれば、その列の分布が train と test で違う疑いがある。横並びなら、特定の列のせいではない。
- 見方
- 縦軸は列、横軸は gain(その列の分岐で損失が減った量の合計)。
敵対的検証の AUC は 0.5453 で、0.50 より高い。0.60 には届かないが、モデルは train と test をわずかに見分けている。
図 1.7 の重要度を見ると、age 以外の数値列 8 列の gain は 3,900〜4,500 にほぼ横並びで、特定の列が飛び抜けてはいない。後の①の表で欠損率の差が大きい social_media_hours・app_opens_per_day・daily_screen_time_hours は、むしろ数値列の中で下位にある。重要度からは、何で見分けているのかは読み取れない。
そこで、何で見分けているのかを切り分けた。
┌─────────────────────────┬────────────────┬───────────────┬───────┐
│ column                  ┆ train_null_pct ┆ test_null_pct ┆ diff  │
╞═════════════════════════╪════════════════╪═══════════════╪═══════╡
│ social_media_hours      ┆ 19.38          ┆ 16.0          ┆ -3.38 │
│ app_opens_per_day       ┆ 11.67          ┆ 8.68          ┆ -2.99 │
│ daily_screen_time_hours ┆ 13.86          ┆ 11.07         ┆ -2.79 │
│ stress_level            ┆ 7.98           ┆ 6.62          ┆ -1.36 │
│ gender                  ┆ 4.2            ┆ 4.8           ┆ 0.6   │
│ weekend_screen_time     ┆ 16.21          ┆ 17.11         ┆ 0.9   │
│ sleep_hours             ┆ 6.43           ┆ 7.58          ┆ 1.15  │
│ age                     ┆ 4.18           ┆ 5.78          ┆ 1.6   │
│ gaming_hours            ┆ 18.34          ┆ 20.05         ┆ 1.71  │
│ notifications_per_day   ┆ 9.78           ┆ 11.55         ┆ 1.77  │
│ work_study_hours        ┆ 7.45           ┆ 9.37          ┆ 1.92  │
│ academic_work_impact    ┆ 6.4            ┆ 8.68          ┆ 2.28  │
└─────────────────────────┴────────────────┴───────────────┴───────┘
欠損フラグだけ  : 0.5574
欠損のない行だけ: 0.5115
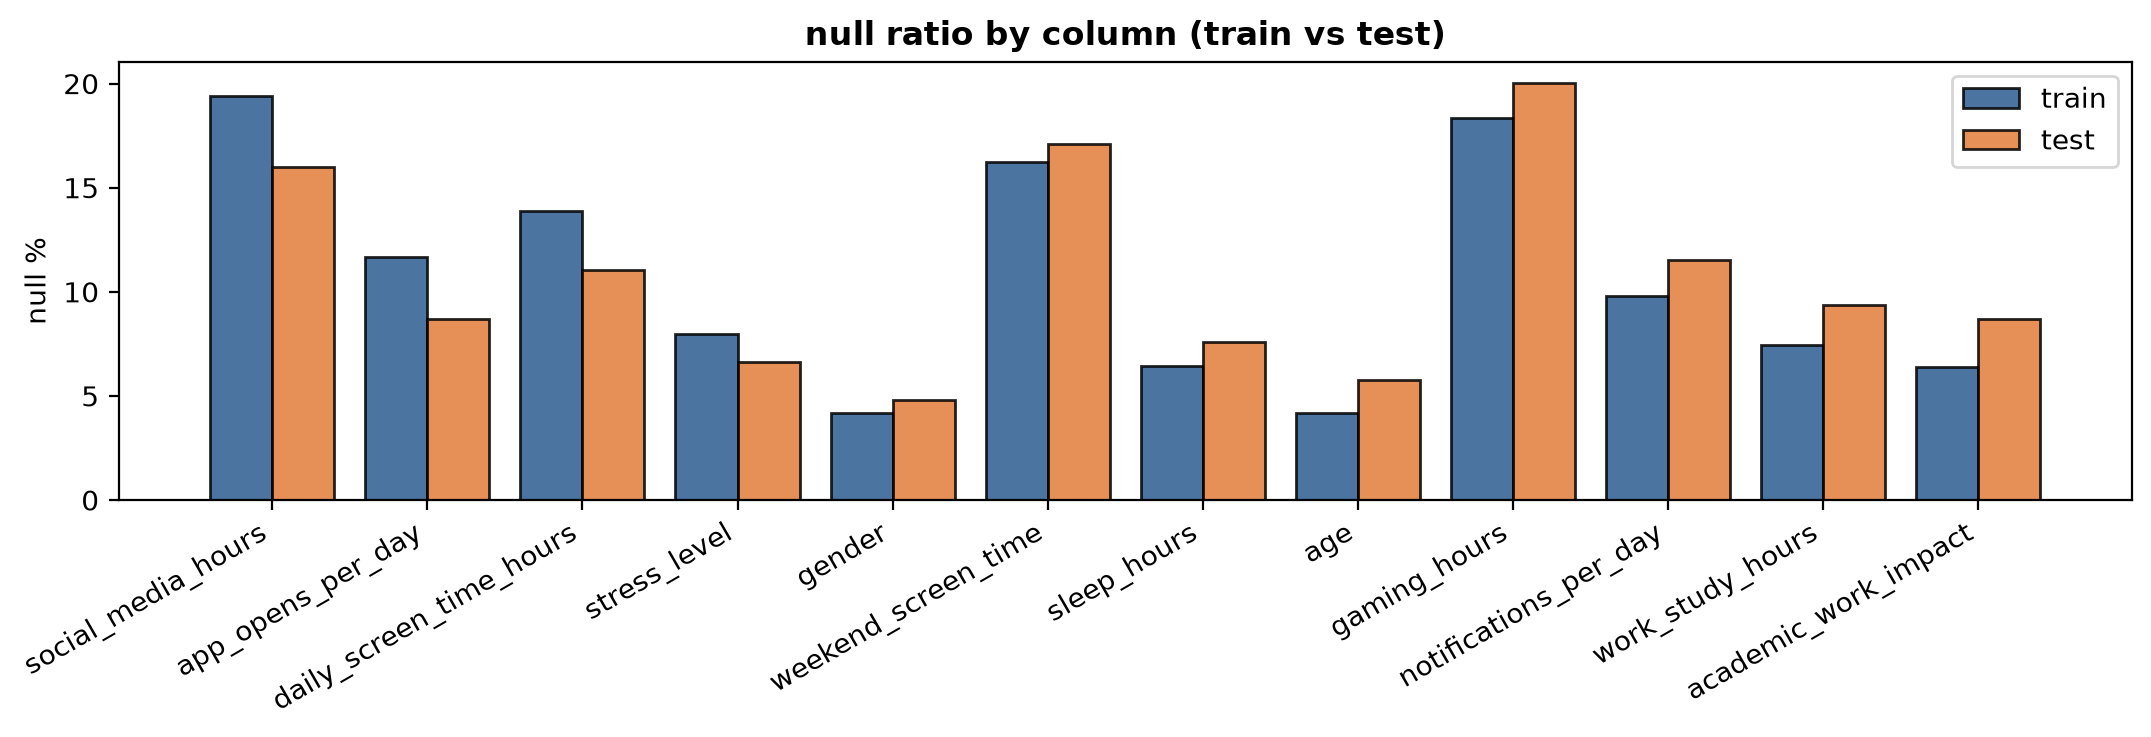
- このグラフを使う理由
- train と test の欠損率を列ごとに比べるので、2 本の棒を隣に並べる。数字は表でも読めるが、どの列でどちらが多いかという向きは、棒のほうが速く読める。
- 何を見るか
- 紺とオレンジの高さの差。差がどの列にもあり、その向きが列によって違うなら、欠損の起き方そのものが train と test で違う。
- 見方
- 横軸は列(test − train の差が小さい順)、縦軸は欠損率(%)。紺が train、オレンジが test である。
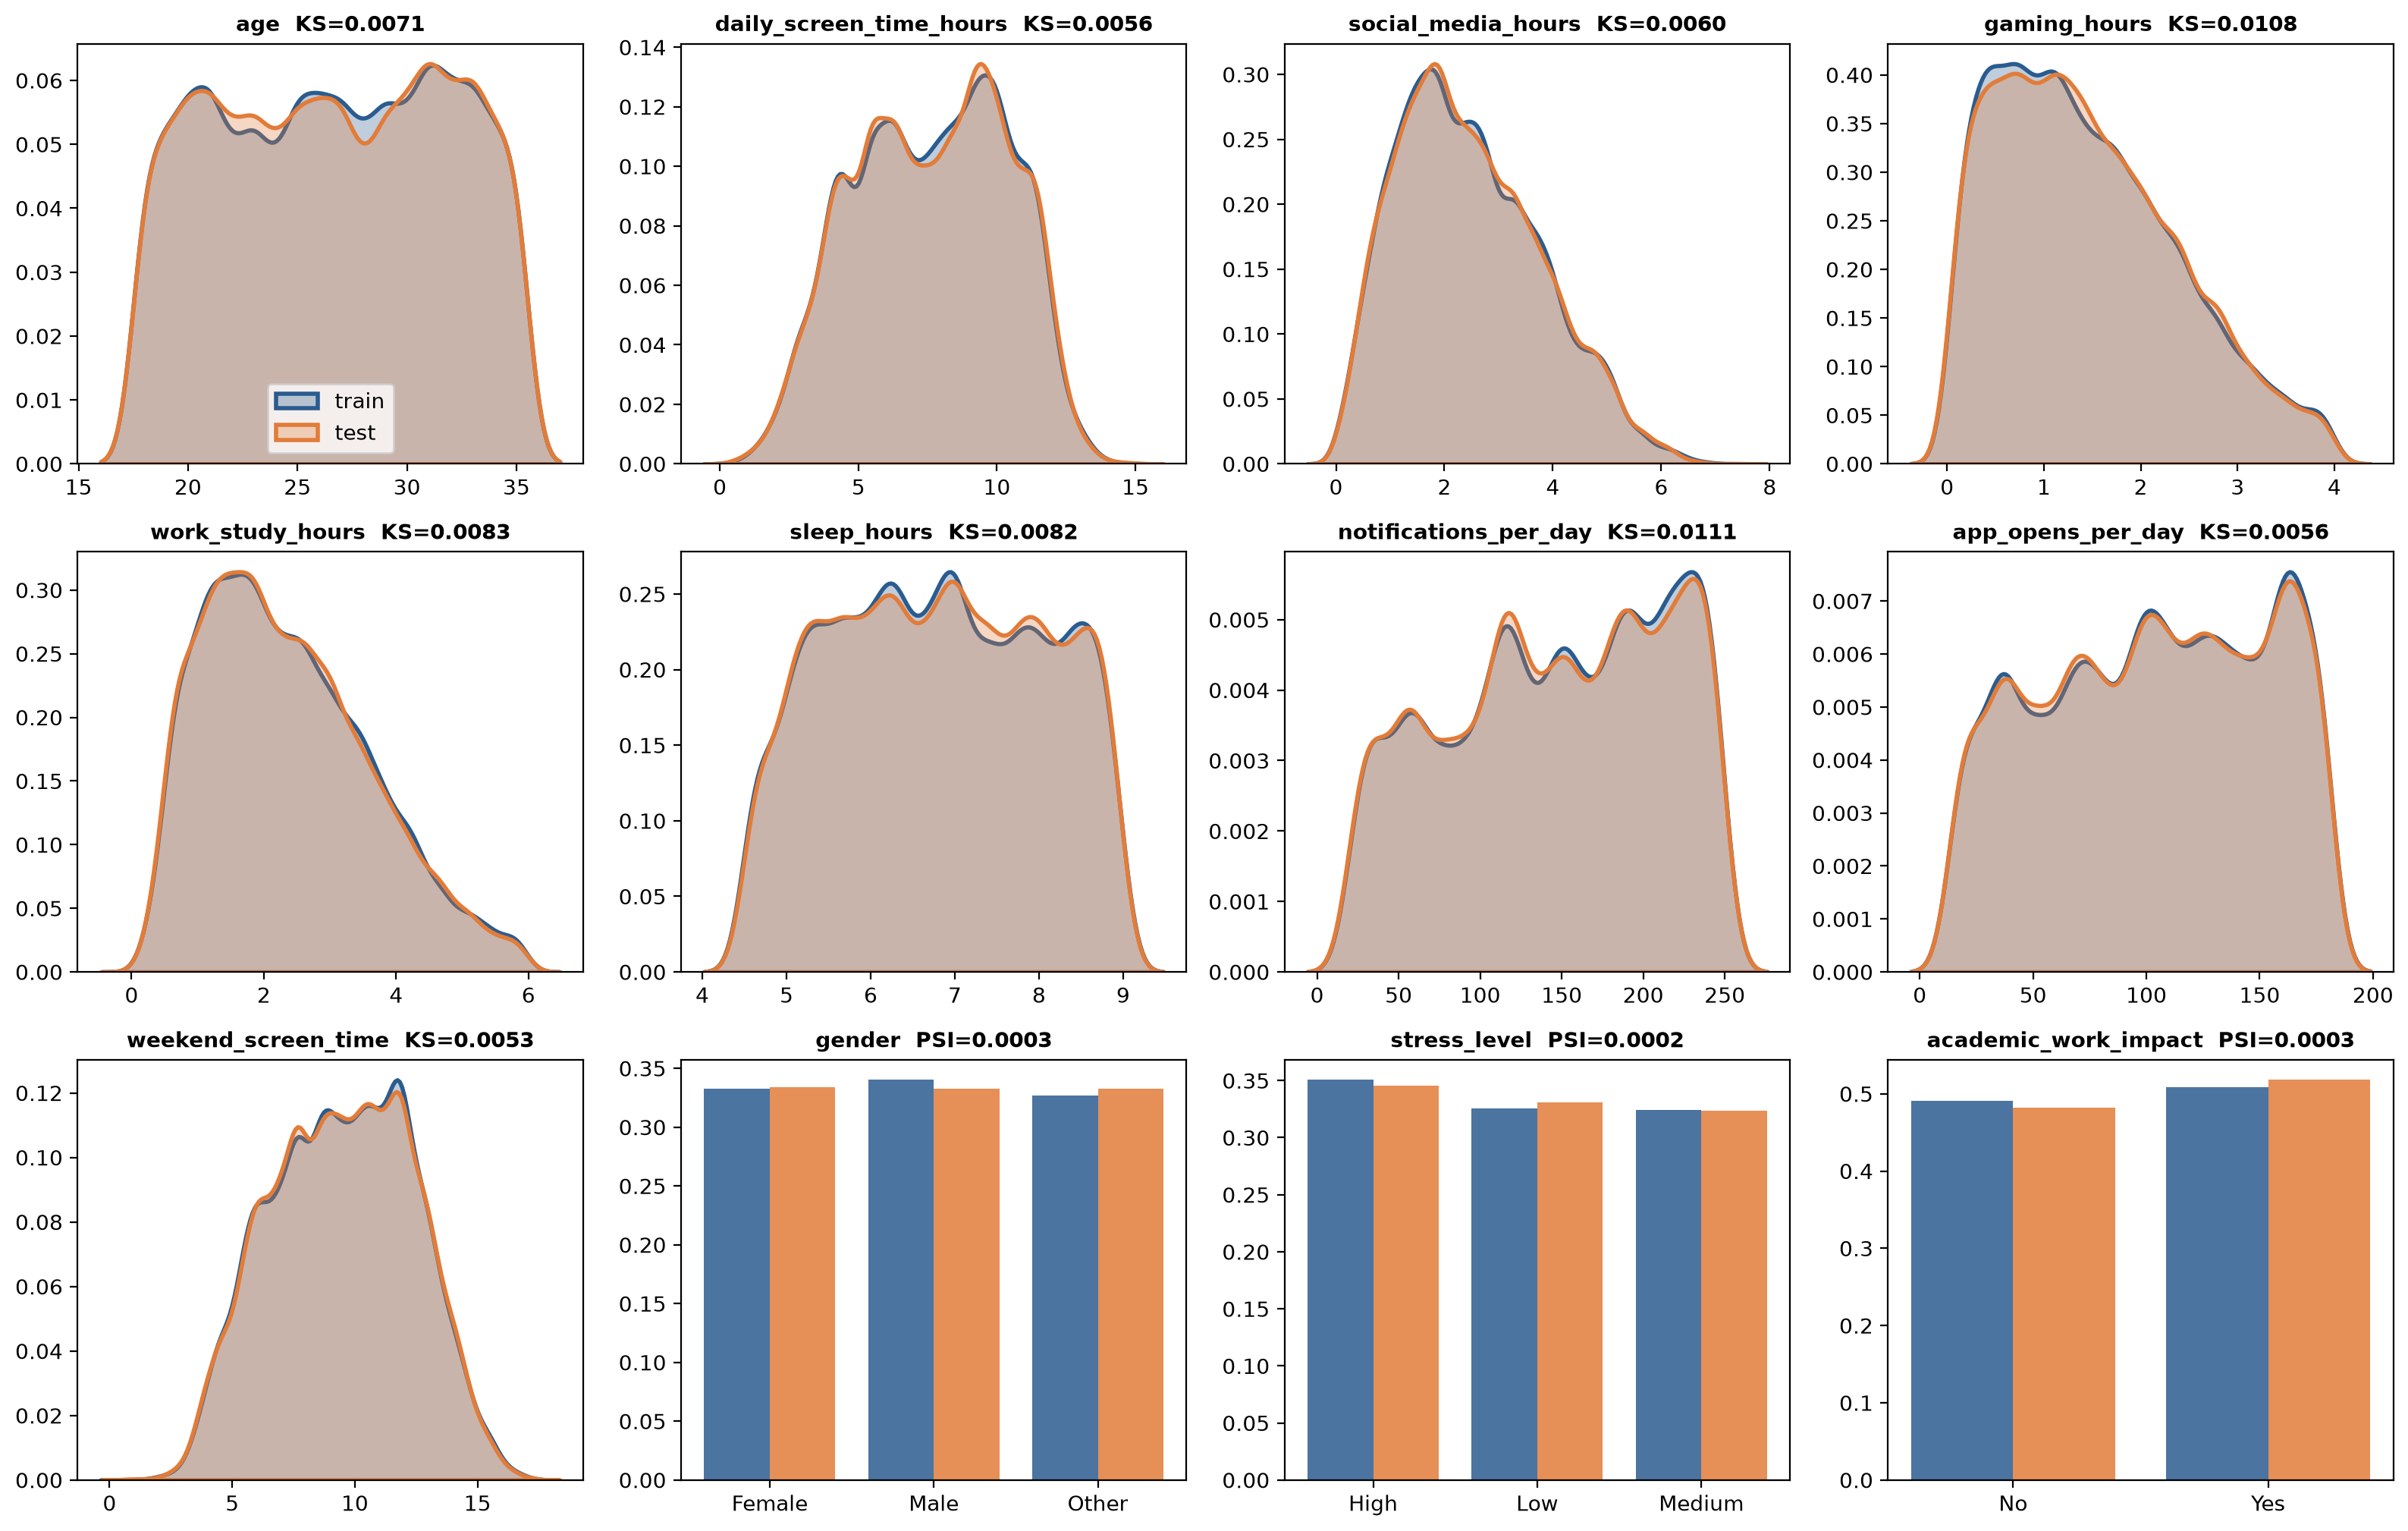
- このグラフを使う理由
- 値の分布を train と test で比べるには、2 つの分布を同じ枠に重ねるのが最も直接的である。行数の違う 2 つを比べられるように、数値列は面積 1 の密度の曲線(KDE)、カテゴリ列は割合の棒にする。目で見た印象を数字で確かめるため、KS 統計量と PSI を枠の上に添える。
- 何を見るか
- 紺とオレンジが重なっているか。形がずれている列があれば、その列の値の分布が test で違う。KS・PSI が 0.1 を超える列も同じ意味である。
- 見方
- 1 つの枠が 1 列。数値列(最初の 9 枠)は横軸が値、縦軸が密度。カテゴリ列(最後の 3 枠)は横軸がカテゴリ、縦軸が割合。紺が train、オレンジが test で、KS・PSI は 0 に近いほど同じ分布である。
違いは値ではなく、列ごとの欠損率にある。欠損率は列によって train と test で最大 3.38 ポイント違う(social_media_hours は train 19.38%、test 16.0%)。欠損フラグだけで当てると AUC は 0.5574 で、全列を使ったとき(0.5453)よりも高い。一方、欠損のない行だけで値から当てると 0.5115 で、0.50 に近い。値の分布は train と test でほぼ同じで、違うのは欠損の起き方である。
図 1.8 と 図 1.9 でも、同じことが分かる。図 1.8 の欠損率の棒は、social_media_hours・app_opens_per_day・daily_screen_time_hours などで train(紺)が高く、academic_work_impact・work_study_hours などで test(オレンジ)が高い。一方、図 1.9 の欠損を除いた値の分布は、どの列も紺とオレンジがほぼ重なる。KS 統計量は数値 9 列とも 0.012 未満(最大は notifications_per_day の 0.0111)、カテゴリ 3 列の PSI は 0.0003 以下で、目安の 0.1 よりはるかに小さい。
この結果をどう扱うか:1-6・1-7 で見たとおり、train では欠損している人の陽性率は全体平均とほぼ同じで、欠損は目的変数と関係がない。そのため、欠損率が test で少し違っても、予測の当たり方が大きく変わるとは考えにくく、CV のスコアを基準に実験を進める。ただし、欠損そのものを材料にする特徴量(欠損フラグや欠損数、4-6)は、train と test で値の分布が変わる。今後 CV と LB の動きが食い違ったら、リークや検証設計とあわせて、この欠損率の違いを疑う。
次の 1-9 では、ここまでの結果を次の工程への申し送りにまとめ、EDA を締める。
1-9EDA を締める
次にやること
1-8 までで、目的変数・欠損・列ごとの傾向・train と test の分布差を確かめた。最後に、次の工程に渡す申し送り事項を数行にまとめる。グラフの枚数ではなく、この数行が EDA の成果物である。
理由
「次の工程の判断が書けたら終わり」という終わりの基準:EDA はいくらでも時間を使えてしまう作業である。きれいなグラフを描くことが目的になると、何日もかかる。EDA の成果物は、「CV はどう分けるか」「欠損はどう扱うか」「どの列が有望か」「どの列を後回しにするか」という次の工程の判断である。この 4 点を書けたら EDA は終える。
工程の順番(1-1〜1-4 → 第2章・第3章 → 1-5〜1-9):EDA を 1-9 まで終えてからモデルに進む必要はない。データの形と欠損が分かった時点(1-4)でいったん第2章・第3章に進み、最初の提出まで通して基準の CV スコアを手に入れるほうが効率的である。基準のスコアがない状態で 1-5〜1-8 を深く掘っても、その気づきが本当にスコアを上げるのかを確かめられないからである。
コード
この節ではコードを書かない。1-2〜1-8 の出力を読み、申し送りを文章でまとめる。
結果
1. CV 設計      : 陽性率 0.709 と偏り → StratifiedKFold(5) を使う
2. 欠損の扱い   : 4〜19%。欠損行の陽性率は全体と同じ(ランダム欠損)
                  → 埋めずに LightGBM にそのまま渡す
                  train と test で欠損率が最大 3.4 ポイント違う(値の分布は同じ)
                  → 欠損フラグを使うときは test での効き方に注意
3. 有望な特徴量 : 画面時間 3 列(daily / weekend / social_media)が単調に強い
                  (Q1 0.31〜0.32 → Q4 0.99〜1.00)。work_study / gaming は中程度
                  → 画面時間とほかの時間の比率・差分を第4章で試す
4. 効かない列   : gender / stress_level / academic_work_impact
                  いずれも陽性率が全体平均 ±0.015 以内。優先度を下げる
1 は 1-2 の陽性率 0.7094 から、2 は 1-4・1-6・1-7・1-8 の欠損の集計から、3 は 1-7 の区間ごとの陽性率から、4 は 1-6 のカテゴリ別の陽性率から導いた判断である。この 4 行が、第2章以降の工程の出発点になる。
本の順番どおり 1-4 のあと第2・3章を通した場合は、ここから第4章へ進む。まだの場合は、次の第2章で申し送りの 1 番(CV 設計)を受けて、分割方法を選び、分割をファイルに固定する。