CH 6ほかのモデルと比べる(モデル比較)
第5章でパラメータと木の数を決めた LightGBM は、OOF AUC 0.964792 に到達した。この章では、同じ分割・同じ特徴量のまま XGBoost・CatBoost・LogisticRegression を並べて、性能・計算時間・予測の相関を測る。XGBoost と CatBoost も第5章と同じ手順で調整してから比べる。目的は単体で最も強いモデルを探すことだけではない。第7章のアンサンブルに向けて、「違う間違え方をする」予測を集めることである。ただし単体スコアが低すぎるモデルは、混ぜると足を引っ張る。多様性と、足手まといにならない精度の両方を見ていく。
6-1比べる条件をそろえる
次にやること
第5章で LightGBM のパラメータが決まった。次は、ほかのモデルと比べるための土台として、第4章の特徴量と固定した分割を読み込み、全モデルで共有する変数を用意する。
理由
モデル以外の条件を変えない:モデル比較で最も重要なのは、分割・特徴量・評価指標を同じにすることである。条件がずれると、スコアの差がモデルの違いから来たのか、前処理や分割の違いから来たのか分からなくなる。
同じ分割:CV 分割が違うと、スコアの差がアルゴリズムの優劣なのか、たまたま簡単な Fold に当たっただけなのか判定できない。folds.csv の 5-Fold を全モデルで共有する。
同じ特徴量と同じ指標:第4章で作った features_v1(14 列)をすべてのモデルに入れる。5-1 と同じく、目的変数と fold は Parquet の中の列から取り、folds.csv と照合してから使う。評価は全 Fold の OOF 予測を結合して ROC-AUC を一括で計算する。こうすると、モデルの構造そのものの差だけが残る。
コード
# 必要なライブラリを用途ごとにインポートする
import json
import time
from collections.abc import Callable
from pathlib import Path
from typing import Any

import matplotlib.pyplot as plt
import numpy as np
import optuna
import pandas as pd
import polars as pl
import seaborn as sns
from catboost import CatBoostClassifier
from lightgbm import LGBMClassifier
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from xgboost import XGBClassifier

# Optuna のログ出力を静かにする(6-4 の探索で使う)
optuna.logging.set_verbosity(optuna.logging.WARNING)

# パスと定数を 1 か所で定義する
PROJECT = Path(r"D:\kaggle\smartphone-addiction_s6e8")   # データの置き場所。自分の環境に合わせて書き換える
DATA_DIR = PROJECT / "data"
PROCESSED_DIR = DATA_DIR / "processed"
CONFIGS_DIR = PROJECT / "configs"
RESULTS_DIR = PROJECT / "results"

ID = "id"
TARGET = "addicted_label"

# グラフでのモデルの色(第6・7章で共通)
MODEL_COLORS = {"lightgbm": "#55A868", "xgboost": "#4A90E2", "catboost": "#E67E22", "logistic_regression": "#8C8C8C"}

# 第4章の特徴量(id・目的変数・fold つき)と固定分割 folds、第5章の最良パラメータを読み込む
train_all = pl.read_parquet(PROCESSED_DIR / "features_v1_train.parquet")
test_all = pl.read_parquet(PROCESSED_DIR / "features_v1_test.parquet")
folds_df = pl.read_csv(PROCESSED_DIR / "folds.csv")

# 第2章の分割と、行ごとに同じ並びかを確かめる(5-1 と同じ)
assert train_all[ID].equals(folds_df[ID]), "id の並びが folds.csv と一致しません"
assert train_all["fold"].equals(folds_df["fold"]), "fold が folds.csv と一致しません"

with open(CONFIGS_DIR / "selected_params.json", "r", encoding="utf-8") as f:
    lgb_params = json.load(f)["params"]

# 特徴量だけの表と、目的変数・分割・test の id に分ける
train_feat = train_all.drop([ID, TARGET, "fold"])
test_feat = test_all.drop(ID)
y_all = train_all[TARGET].to_numpy()
folds = train_all["fold"].to_numpy()
test_ids = test_all[ID]          # 6-7 で test 予測に付ける
n_folds = int(folds.max() + 1)

# 特徴量列の定義。カテゴリ列は型から決める(Parquet は第4章の Enum 型をそのまま保っている)
feature_cols = [c for c in train_feat.columns]
cat_cols = [c for c, dt in train_feat.schema.items() if not dt.is_numeric()]
num_cols = [c for c in feature_cols if c not in cat_cols]

print(f"特徴量数: {len(feature_cols)} (数値列: {len(num_cols)}, カテゴリ列: {len(cat_cols)})")
print(f"レコード数: {len(y_all)}, 分割数: {n_folds}-Fold")pl.read_parquet(path) | 第4章で作った特徴量 Parquet を読み込む |
|---|---|
pl.read_csv(path) | 固定分割 folds.csv を読み込み、Parquet の id・fold と照合する |
df.drop([ID, TARGET, "fold"]) | 特徴量ではない列を外す。test は id だけを外す |
json.load(f) | 第5章で保存した LightGBM のパラメータを読み込む |
roc_auc_score(y_true, y_pred) | 全 Fold の OOF 予測値を結合して一括評価する(6-5 で使う) |
結果
特徴量数: 14 (数値列: 11, カテゴリ列: 3)
レコード数: 691369, 分割数: 5-Fold
特徴量は 14 列で、そのうち数値列が 11、カテゴリ列が 3 である。691,369 行を 5-Fold に分けている。この 3 つ(分割・特徴量・指標)をこの章のすべてのモデルで使う。
次の 6-2 では、GBDT 三種の違いを確かめ、それぞれに合う形で入力データを用意する。
6-2GBDT 三種の違いを知り、入力を準備する
次にやること
前の節で、全モデル共通の特徴量と分割がそろった。次は、LightGBM・XGBoost・CatBoost の違いを確かめ、カテゴリ列をそれぞれが受け取れる型に直す。
理由
GBDT 三種は木の育て方が違う:テーブルコンペで主に使う 3 つの GBDT(勾配ブースティング決定木)は、木の成長のさせ方とカテゴリ変数(categorical variable)の扱いが異なる。
| LightGBM | Leaf-wise(葉優先)。損失減少量が最大の葉を深く掘る。高速・高精度だが過学習リスクあり |
|---|---|
| XGBoost | Depth-wise(深さ優先)。木全体をレベル単位で均等に分割。均整の取れた構造で安定 |
| CatBoost | Symmetric Trees(対称木)。同じ深さの全ノードが同一の分岐条件を共有。過学習に強い |
LightGBM:損失の減少が大きいノードを非対称に深く伸ばす。複雑な相互作用(interaction)を捉えやすく高精度になりやすい一方、正則化による制約が欠かせない。
XGBoost:木全体を均等に伸ばすため、極端な過学習を起こしにくいモデルである。ヒストグラム法(tree_method="hist")と enable_categorical=True で、安定して高い精度を出す。
CatBoost:対称木(完全二分木)を使い、同じ深さのノードでは同じ特徴量・同じしきい値で分割する。推論が速く、過学習を抑えやすい構造である。
カテゴリ列の影響(第1章 1-6 とのつながり):CatBoost の最大の強みは、順序付き Target Encoding(Ordered Target Encoding)によるカテゴリ変数の自動処理である。しかし第1章 1-6 で確認したとおり、このデータ(S6E8)は数値列(特に screen_time 系)が中心で、カテゴリ列(gender など)は目的変数にほとんど効かない。そのため CatBoost の強みは活きず、カテゴリの処理に時間がかかるだけである。6-4 では、カテゴリを one-hot で扱う設定にして学習を速くする。EDA で掴んだデータの性質が、そのままモデルの設定の決め方につながる。
入力の型を分ける:LightGBM と XGBoost はカテゴリ列を pandas の category 型で受け取る。CatBoost は文字列で受け取り、欠損は "missing" という文字列で埋める。
コード
# LightGBM と XGBoost 用: category 型に変換
X_train_cat = train_feat.select(feature_cols).to_pandas()
X_test_cat = test_feat.select(feature_cols).to_pandas()
for c in cat_cols:
    X_train_cat[c] = X_train_cat[c].astype("category")
    X_test_cat[c] = X_test_cat[c].astype("category")
# CatBoost 用: カテゴリ列を文字列にし、欠損は "missing" で埋める(Polars で変換してから pandas にする)
X_train_cb = train_feat.select(feature_cols).with_columns(
    pl.col(cat_cols).cast(pl.String).fill_null("missing")
).to_pandas()
X_test_cb = test_feat.select(feature_cols).with_columns(
    pl.col(cat_cols).cast(pl.String).fill_null("missing")
).to_pandas()
print("[PASS] GBDT 3種用の入力データ準備完了")df.select(cols).to_pandas() | Polars の特徴量列を選び、pandas に変換してモデルに渡せる形にする |
|---|---|
s.astype("category") | LightGBM・XGBoost 用にカテゴリ型へ変換する |
pl.col(cat_cols).cast(pl.String).fill_null("missing") | CatBoost 用に文字列へ変換し、欠損を "missing" で埋める。pandas の astype(str).fillna("missing") は、pandas 2 系では欠損が先に "nan" という文字列になって埋まらないので、Polars の側で変換する |
結果
[PASS] GBDT 3種用の入力データ準備完了
LightGBM・XGBoost 用の X_train_cat / X_test_cat と、CatBoost 用の X_train_cb / X_test_cb ができた。中身の値は同じで、カテゴリ列の型だけが違う。
次の 6-3 では、決定木以外のモデル(LogisticRegression)を加え、そのために必要になる前処理を組み立てる。
6-3決定木以外のモデルと、必要な前処理
次にやること
前の節で、GBDT 三種の入力がそろった。次は、決定木とは違う予測を出すモデルとして LogisticRegression を加え、標準化・欠損補完・One-Hot をまとめたパイプラインを作る。
理由
決定木と違う予測分布が得られる:線形モデルやニューラルネットワークを加えると、決定木とは異なる予測が得られる。ここで、第1章 1-5 で触れた「なぜ木モデルでは前処理が要らなかったのか」の答えが出る。
標準化(StandardScaler)が必要な理由:決定木は各特徴量の値の大小関係(しきい値での分割)しか見ない。スケールを変えても分岐点が変わるだけで、学習結果は変わらない。しかし線形モデル(LogisticRegression)やニューラルネット(MLP)は、特徴量と重みの線形結合 Σ wᵢxᵢ を計算し、勾配を使う反復法で最適化する。スケールがそろっていないと、分散の大きな特徴量の重みが小さくなり、L1/L2 正則化が特定の変数に偏ってかかる。正則化を公平にかけ、最適化を安定させるために標準化する。
欠損値補完(SimpleImputer)が必要な理由:木モデルは欠損値(NaN)をそのまま受け入れ、どちらの枝に振り分けるかを学習する。一方、線形モデルや MLP は入力に NaN があると ValueError: Input X contains NaN を出して止まる。そのため中央値で補完する。
One-Hot Encoding が必要な理由:木モデルはカテゴリ型をそのまま扱えるが、線形モデルは文字列やカテゴリ型を直接解釈できない。ダミー変数に展開する。drop="first" で多重共線性を防ぐ。
Pipeline にまとめる:ColumnTransformer と Pipeline を使うと、これらの前処理を Fold ごとに学習データだけで fit でき、検証データの情報が漏れない。
コード
# Pipeline・ColumnTransformer などは 6-1 でインポート済み
num_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
])
cat_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("onehot", OneHotEncoder(drop="first", sparse_output=False, handle_unknown="ignore")),
])
lr_preprocessor = ColumnTransformer(
    transformers=[
        ("num", num_pipeline, num_cols),
        ("cat", cat_pipeline, cat_cols),
    ]
)
lr_model = Pipeline([
    ("prep", lr_preprocessor),
    ("lr", LogisticRegression(max_iter=500, random_state=42)),
])
print("[PASS] 線形モデル用パイプライン構築完了")ColumnTransformer(transformers) | 数値列とカテゴリ列で異なる前処理パイプラインを結合する |
|---|---|
SimpleImputer(strategy) | 欠損値を中央値または最頻値で補完する |
StandardScaler() | 数値を平均 0、分散 1 に標準化する |
OneHotEncoder(drop="first") | カテゴリ列をダミー変数化し、多重共線性を防ぐ |
結果
[PASS] 線形モデル用パイプライン構築完了
前処理と LogisticRegression を 1 つにまとめた lr_model ができた。fit を呼ぶたびに、補完・標準化・One-Hot もその Fold の学習データだけで学習し直される。
次の 6-4 では、4 つを比べる前に、XGBoost と CatBoost も第5章と同じ手順で調整する。
6-4XGBoost と CatBoost も同じ手順で調整する
次にやること
前の節までで、4 つのモデルの入力と LogisticRegression のパイプラインがそろった。比べる前に、XGBoost と CatBoost も第5章の LightGBM と同じ手順(30% サンプル / 3-Fold / early stopping / TPE で 25 試行 → 全データの 5-Fold で木の数を決める)で調整する。
理由
調整の手間もそろえる:LightGBM だけを第5章で調整し、XGBoost と CatBoost を手で決めた設定のまま比べると、表は「調整したモデルと、調整していないモデル」の比較になる。そのスコアの差は、モデルの種類の差とは言えない。6-1 で分割・特徴量・指標をそろえたのと同じく、調整にかける手間もそろえてから比べる。
探す範囲は役割で対応させる:XGBoost は、木の深さ max_depth(3〜10)、葉に必要な重みの合計 min_child_weight(1〜300、LightGBM の min_child_samples に当たる)、行と列のサンプリング、L1/L2 正則化を探す。CatBoost は、深さ depth(4〜8)、L2 正則化 l2_leaf_reg、行のサンプリング subsample(既定の MVS でも使えるが、ここでは行を一様に選ぶ bootstrap_type="Bernoulli" にする)、列のサンプリング rsm を探す。CatBoost は対称木で、深さ 10 だと葉が 1024 枚になり学習が非常に遅くなるので、深さは 8 までにする。
CatBoost のカテゴリは one-hot にする:1-6 のとおり、このデータのカテゴリ列は欠損を含めても 3〜4 種類しかなく、陽性率もほぼ同じである。CatBoost 得意の順序付き Target Encoding を計算しても得るものは少なく、時間だけがかかる。30% サンプルの 1 Fold・300 本で測ると、既定の設定では 14.9 秒、one_hot_max_size=10(10 種類以下のカテゴリは one-hot で扱う)では 3.9 秒で、AUC はほぼ同じ(0.951334 と 0.951351)であった。探索では何百回も学習するので、one-hot にする。
関数にして 2 つのモデルで使い回す:モデルごとに違うのは、探す範囲(suggest_xgb / suggest_cb)と、early stopping 付きの学習の書き方(fit_es)だけである。探索から木の数の決定までを tune にまとめ、2 つのモデルで同じ関数を呼ぶ。
コード
# optuna と StratifiedKFold は 6-1 でインポート済み

# 5-2 と同じ 30% サンプルと探索用 3-Fold
np.random.seed(42)
sample_idx = np.random.choice(len(y_all), size=int(len(y_all) * 0.3), replace=False)
sample_idx.sort()
y_sub = y_all[sample_idx]
sub_folds = list(StratifiedKFold(n_splits=3, shuffle=True, random_state=42).split(np.zeros(len(y_sub)), y_sub))

# 5-3 と同じく、学習率 0.1・上限 10000 本・100 本改善なしで停止
XGB_FIXED = dict(learning_rate=0.1, n_estimators=10000, early_stopping_rounds=100, eval_metric="auc",
                 tree_method="hist", enable_categorical=True, random_state=42, n_jobs=-1)
CB_FIXED = dict(learning_rate=0.1, iterations=10000, early_stopping_rounds=100, eval_metric="AUC",
                bootstrap_type="Bernoulli", cat_features=cat_cols, one_hot_max_size=10,
                random_seed=42, verbose=0, thread_count=-1)

def suggest_xgb(trial: optuna.Trial) -> dict[str, Any]:
    return dict(
        max_depth=trial.suggest_int("max_depth", 3, 10),
        min_child_weight=trial.suggest_float("min_child_weight", 1.0, 300.0, log=True),
        subsample=trial.suggest_float("subsample", 0.6, 1.0),
        colsample_bytree=trial.suggest_float("colsample_bytree", 0.6, 1.0),
        reg_alpha=trial.suggest_float("reg_alpha", 1e-3, 10.0, log=True),
        reg_lambda=trial.suggest_float("reg_lambda", 1e-3, 10.0, log=True),
    )

def suggest_cb(trial: optuna.Trial) -> dict[str, Any]:
    return dict(
        depth=trial.suggest_int("depth", 4, 8),
        l2_leaf_reg=trial.suggest_float("l2_leaf_reg", 1e-3, 10.0, log=True),
        subsample=trial.suggest_float("subsample", 0.6, 1.0),
        rsm=trial.suggest_float("rsm", 0.6, 1.0),
    )

def fit_es(name: str, params: dict[str, Any], X_tr: pd.DataFrame, y_tr: np.ndarray,
           X_va: pd.DataFrame, y_va: np.ndarray):
    """early stopping 付きで学習し、(モデル, 止まった木の数) を返す"""
    if name == "xgboost":
        m = XGBClassifier(**params).fit(X_tr, y_tr, eval_set=[(X_va, y_va)], verbose=False)
        return m, m.best_iteration + 1
    m = CatBoostClassifier(**params).fit(X_tr, y_tr, eval_set=(X_va, y_va))
    return m, m.get_best_iteration() + 1

def tune(name: str, X_all: pd.DataFrame, fixed: dict[str, Any], suggest: Callable,
         n_trials: int = 25) -> dict[str, Any]:
    """第5章と同じ手順: 30% / 3-Fold で探索 → 全データ 5-Fold で木の数を決める"""
    X_sub = X_all.iloc[sample_idx].reset_index(drop=True)

    def objective(trial):
        params = {**fixed, **suggest(trial)}
        scores, iters = [], []
        for tr_idx, va_idx in sub_folds:
            m, n = fit_es(name, params, X_sub.iloc[tr_idx], y_sub[tr_idx], X_sub.iloc[va_idx], y_sub[va_idx])
            scores.append(roc_auc_score(y_sub[va_idx], m.predict_proba(X_sub.iloc[va_idx])[:, 1]))
            iters.append(n)
        trial.set_user_attr("best_iters", iters)
        return float(np.mean(scores))

    study = optuna.create_study(direction="maximize", sampler=optuna.samplers.TPESampler(seed=42))
    t0 = time.time()
    study.optimize(objective, n_trials=n_trials)
    print(f"[{name}] 探索 {n_trials} 試行: {time.time() - t0:.1f} 秒 | Best #{study.best_trial.number} 探索スコア {study.best_value:.6f}")
    for k, v in study.best_params.items():
        print(f"  {k}: {v:.6f}" if isinstance(v, float) else f"  {k}: {v}")

    # 5-5 と同じく、全データの 5-Fold で early stopping をかけ、止まった本数の中央値に固定する
    es_params = {**fixed, **study.best_params}
    best_iters = []
    for f in range(n_folds):
        tr, va = folds != f, folds == f
        _, n = fit_es(name, es_params, X_all[tr], y_all[tr], X_all[va], y_all[va])
        best_iters.append(n)
    n_fixed = int(np.median(best_iters))
    print(f"[{name}] 全データの木の数: {best_iters} → 中央値 {n_fixed}")

    params = {k: v for k, v in es_params.items() if k not in ("early_stopping_rounds", "eval_metric")}
    params["n_estimators" if name == "xgboost" else "iterations"] = n_fixed
    return params

xgb_params = tune("xgboost", X_train_cat, XGB_FIXED, suggest_xgb)
cb_params = tune("catboost", X_train_cb, CB_FIXED, suggest_cb)XGBClassifier(early_stopping_rounds=100, eval_metric="auc") | XGBoost の early stopping。止める条件はコンストラクタで渡す |
|---|---|
fit(..., eval_set=[(X_va, y_va)], verbose=False) | XGBoost に検証データを渡す |
m.best_iteration + 1 | XGBoost で最も良かった木の番号(0 始まり)を本数に直す |
CatBoostClassifier(one_hot_max_size=10) | 種類が 10 以下のカテゴリ列を one-hot で扱う |
m.get_best_iteration() + 1 | CatBoost で最も良かった木の番号を本数に直す |
X_all[tr] | pandas の DataFrame を bool 配列で行選択する |
結果
[xgboost] 探索 25 試行: 1523.8 秒 | Best #15 探索スコア 0.961864
  max_depth: 4
  min_child_weight: 10.227255
  subsample: 0.925913
  colsample_bytree: 0.610205
  reg_alpha: 1.555892
  reg_lambda: 0.682397
[xgboost] 全データの木の数: [3068, 3141, 3433, 3253, 3442] → 中央値 3253
[catboost] 探索 25 試行: 2393.1 秒 | Best #12 探索スコア 0.961095
  depth: 4
  l2_leaf_reg: 9.050882
  subsample: 0.998338
  rsm: 0.878862
[catboost] 全データの木の数: [6006, 7885, 7527, 7424, 6705] → 中央値 7424
探索スコア:XGBoost は 0.961864 で、第5章の LightGBM(0.961898)とほぼ同じである。CatBoost は 0.961095 である。選ばれたのは、XGBoost と CatBoost が深さ 4、LightGBM が深さ 3 の浅い木であった。
木の数:全データで止まった本数の中央値は、XGBoost が 3253 本、CatBoost が 7424 本で、どちらも上限の 10000 本には当たっていない。CatBoost は同じ深さの分岐条件を全ノードで共有する対称木なので、1 本あたりの表現力が小さく、ほかの 2 つより多くの木を必要としたと考えられる。
時間:探索にかかった時間は XGBoost が約 25 分、CatBoost が約 40 分で、LightGBM(約 7 分)よりずっと長くかかった。3 つのモデルに同じ手間をかけると、合わせて 1 時間以上になる。時間の限られたコンペでは、5-2 のように先に見積もってから試行回数を決めるべきである。
次の 6-5 では、LightGBM(第5章)と、ここで決めた XGBoost・CatBoost のパラメータ、LogisticRegression の 4 つを同じ 5-Fold で回して比べる。
6-54 つのモデルを同じ手順で回す
次にやること
前の節で、XGBoost と CatBoost のパラメータが決まった。次は、LightGBM・XGBoost・CatBoost・LogisticRegression の 4 つを同じ 5-Fold で学習し、OOF AUC と学習時間を並べる。最後に、Fold ごとの AUC と、精度と時間の関係をグラフにする。
理由
設定を辞書にまとめて同じループで回す:モデルごとに「作り方(factory)」「入力データ」を model_configs にまとめ、1 つのループで学習する。モデルごとに別のコードを書くと、分割や評価の手順がずれやすくなる。同じループなら、違うのはモデルだけである。
木の数は固定して回す:3 つの GBDT は、どれも木の数を全データの early stopping で決めて固定している(LightGBM 5268 本、XGBoost 3253 本、CatBoost 7424 本)。ここでは early stopping を使わずに、その本数で学習する。5-5 と同じく、検証データを見て止めた甘めのスコアではなく、正直なスコアで比べるためである。
4 種に絞る:このデータ(691,369 行)では、MLPClassifier(多層パーセプトロン)は多層の重み更新と逆伝播の計算量が大きく、1 Fold に数十分かかる。そこで比較するモデルを LightGBM / XGBoost / CatBoost / LogisticRegression の 4 種に絞った。
OOF と test 予測を同時に貯める:各 Fold で検証データの予測を OOF 配列に入れ、test の予測を 5 分の 1 ずつ足す。こうすると 6-7 で保存して、第7章で学習をやり直さずに使える。
同じ Fold どうしで比べる:GBDT の 3 つの差は 0.0003〜0.0007 しかなく、棒グラフでは同じ長さに見える。4-2 と同じく、Fold ごとの AUC を折れ線で並べ、どの Fold でも順位が同じかを見る。全部の Fold で上にあれば、その差は分割の運ではない。
精度と時間を 1 枚で見る:横軸に 5-Fold の学習時間、縦軸に OOF AUC を取ると、「少し精度が上がる代わりに何倍時間がかかるか」が分かる。時間はモデルによって 100 倍以上違うので、横軸は対数にする。
コード
# 4 モデルの 5-Fold 学習と評価を実行する(値の型がモデルごとに違うので dict[str, Any])
model_configs: dict[str, dict[str, Any]] = {
    "lightgbm": {
        "factory": lambda: LGBMClassifier(**lgb_params, n_jobs=-1),
        "fit_kwargs": {"categorical_feature": cat_cols},   # LightGBM だけはカテゴリ列を明示する(3-2)
        "X_train": X_train_cat,
        "X_test": X_test_cat,
    },
    "xgboost": {
        "factory": lambda: XGBClassifier(**xgb_params),
        "X_train": X_train_cat,
        "X_test": X_test_cat,
    },
    "catboost": {
        "factory": lambda: CatBoostClassifier(**cb_params),
        "X_train": X_train_cb,
        "X_test": X_test_cb,
    },
    "logistic_regression": {
        "factory": lambda: lr_model,
        "X_train": X_train_cat,
        "X_test": X_test_cat,
    },
}

n_samples = len(y_all)
n_test_samples = len(X_test_cat)

oof_predictions = {name: np.zeros(n_samples, dtype=np.float64) for name in model_configs}
test_predictions = {name: np.zeros(n_test_samples, dtype=np.float64) for name in model_configs}
comparison_records = []
fold_scores_by_model = {}   # グラフ用に、モデルごとの Fold 別スコアを残す

for model_name, cfg in model_configs.items():
    print(f"--- Evaluating {model_name} ---")
    start_time = time.time()
    fold_scores = []
    X_tr_source = cfg["X_train"]
    X_te_source = cfg["X_test"]

    for f_idx in range(n_folds):
        f_start = time.time()
        idx_tr = np.where(folds != f_idx)[0]
        idx_va = np.where(folds == f_idx)[0]

        clf = cfg["factory"]()
        clf.fit(X_tr_source.iloc[idx_tr], y_all[idx_tr], **cfg.get("fit_kwargs", {}))

        pred_va = clf.predict_proba(X_tr_source.iloc[idx_va])[:, 1]
        oof_predictions[model_name][idx_va] = pred_va
        test_predictions[model_name] += clf.predict_proba(X_te_source)[:, 1] / n_folds

        score = roc_auc_score(y_all[idx_va], pred_va)
        fold_scores.append(score)
        print(f"  Fold {f_idx}: AUC = {score:.6f} ({time.time() - f_start:.1f}s)")

    elapsed = time.time() - start_time
    total_auc = roc_auc_score(y_all, oof_predictions[model_name])
    std_auc = float(np.std(fold_scores))
    fold_scores_by_model[model_name] = fold_scores

    comparison_records.append({
        "model": model_name,
        "oof_auc": round(total_auc, 6),
        "fold_std": round(std_auc, 6),
        "train_time_sec": round(elapsed, 1),
    })
    print(f"  --> {model_name} OOF AUC: {total_auc:.6f}, Fold std: {std_auc:.6f}, Total Time: {elapsed:.1f}s")

comp_summary_df = pd.DataFrame(comparison_records)
次に、左に GBDT 3 つの Fold ごとの AUC、右に 4 つのモデルの学習時間と OOF AUC を描く。
_df = comp_summary_df.set_index("model")

_fig, (_ax1, _ax2) = plt.subplots(1, 2, figsize=(13, 4.2))
# 左: GBDT 3 つの Fold ごとの AUC(LogisticRegression は低すぎて同じ軸に入らないので除く)
for _m in ["lightgbm", "xgboost", "catboost"]:
    _ax1.plot(range(n_folds), fold_scores_by_model[_m], "o-", color=MODEL_COLORS[_m], alpha=0.85,
              markeredgecolor="black",
              label=f"{_m} (OOF {_df.loc[_m, 'oof_auc']:.6f})")
_ax1.set_xticks(range(n_folds), [f"fold{_i}" for _i in range(n_folds)])
_ax1.set_ylabel("ROC AUC")
_ax1.set_title("AUC by fold (GBDT)", fontweight="bold")
_ax1.legend()
_ax1.grid(True, linestyle=":", alpha=0.6)
# 右: 学習時間(対数)と OOF AUC。名前が重ならないように、時間の短い順に上・下・上・下と交互に書く
for _k, _m in enumerate(_df["train_time_sec"].sort_values().index):
    _t, _a = _df.loc[_m, "train_time_sec"], _df.loc[_m, "oof_auc"]
    _ax2.scatter(_t, _a, s=100, color=MODEL_COLORS[_m], alpha=0.85, edgecolor="black")
    _ax2.annotate(f"{_m}\n{_a:.6f}", (_t, _a), textcoords="offset points",
                  xytext=(0, 8 if _k % 2 == 0 else -28), ha="center", fontsize=8)
_ax2.margins(y=0.15)   # 上下に書いた名前が枠に収まるように
_ax2.set_xscale("log")
_ax2.set_xlim(2, 5000)   # 左端の名前が枠に収まるように
_ax2.set_xlabel("time for 5-fold CV (sec, log scale)")
_ax2.set_ylabel("OOF ROC AUC")
_ax2.set_title("accuracy vs time", fontweight="bold")
_ax2.grid(True, linestyle=":", alpha=0.6)
_fig.tight_layout()
_figLGBMClassifier(**lgb_params) | 第5章で決めたパラメータ(木の数を含む)で LightGBM を作る |
|---|---|
XGBClassifier(**xgb_params) | 6-4 で決めたパラメータで XGBoost を作る |
CatBoostClassifier(**cb_params) | 6-4 で決めたパラメータで CatBoost を作る(cat_features も中に入っている) |
clf.predict_proba(X)[:, 1] | 陽性クラス(依存あり)の予測確率を取り出す |
np.std(fold_scores) | Fold 間の AUC のばらつきを測る |
df.set_index("model") / df.loc[名前, 列] | モデル名で行を引けるようにし、OOF AUC や時間を取り出す |
ax.plot(x, y, "o-") | 点を線でつないだ折れ線を描く |
ax.set_xscale("log") | 横軸を対数にする。10 秒・100 秒・1000 秒が等間隔に並ぶ |
s.sort_values().index | 時間の短い順に並べたモデル名を取り出す。名前を上下交互に書く順番に使う |
ax.margins(y=0.15) | 縦軸の上下に 15% の余白を取る |
結果
--- Evaluating lightgbm ---
  Fold 0: AUC = 0.963995 (28.5s)
  Fold 1: AUC = 0.964791 (27.1s)
  Fold 2: AUC = 0.965022 (25.9s)
  Fold 3: AUC = 0.965583 (25.5s)
  Fold 4: AUC = 0.964572 (26.3s)
  --> lightgbm OOF AUC: 0.964792, Fold std: 0.000522, Total Time: 133.2s
--- Evaluating xgboost ---
  Fold 0: AUC = 0.964388 (28.8s)
  Fold 1: AUC = 0.965095 (27.9s)
  Fold 2: AUC = 0.965184 (27.8s)
  Fold 3: AUC = 0.965783 (30.4s)
  Fold 4: AUC = 0.964894 (29.9s)
  --> xgboost OOF AUC: 0.965067, Fold std: 0.000451, Total Time: 144.7s
--- Evaluating catboost ---
  Fold 0: AUC = 0.963748 (194.1s)
  Fold 1: AUC = 0.964294 (216.9s)
  Fold 2: AUC = 0.964628 (216.0s)
  Fold 3: AUC = 0.965132 (218.1s)
  Fold 4: AUC = 0.964110 (221.2s)
  --> catboost OOF AUC: 0.964382, Fold std: 0.000471, Total Time: 1066.3s
--- Evaluating logistic_regression ---
  Fold 0: AUC = 0.913693 (2.1s)
  Fold 1: AUC = 0.914185 (1.8s)
  Fold 2: AUC = 0.915224 (1.8s)
  Fold 3: AUC = 0.915996 (1.9s)
  Fold 4: AUC = 0.914796 (1.9s)
  --> logistic_regression OOF AUC: 0.914775, Fold std: 0.000802, Total Time: 9.5s
XGBoost:OOF AUC 0.965067 で、4 つの中で最も高い精度である。5 つの Fold すべてで LightGBM を上回り、差(+0.000275)はノイズフロア 0.000163 も採択の閾値 +0.000200 も超えている。同じ手間で調整すると、単体の最良は LightGBM ではなく XGBoost であった。
LightGBM:0.964792 で 2 番目である。学習と予測にかかった時間は 133.2 秒で、3 つの GBDT の中では最も速いモデルである。
CatBoost:0.964382 で、LightGBM とは 0.0004 の差である。ただし 7424 本の木を学習するので 1066.3 秒(約 18 分)かかり、LightGBM の約 8 倍の時間がかかった。
LogisticRegression:9.5 秒と最も速いが、スコアは 0.914775 である。非線形な関係を捉えきれていない。
GBDT の 3 つは 0.9644〜0.9651 の狭い範囲に収まった。どのモデルも Fold 間 std は 0.00045〜0.0008 程度で、Fold による大きなぶれはない。
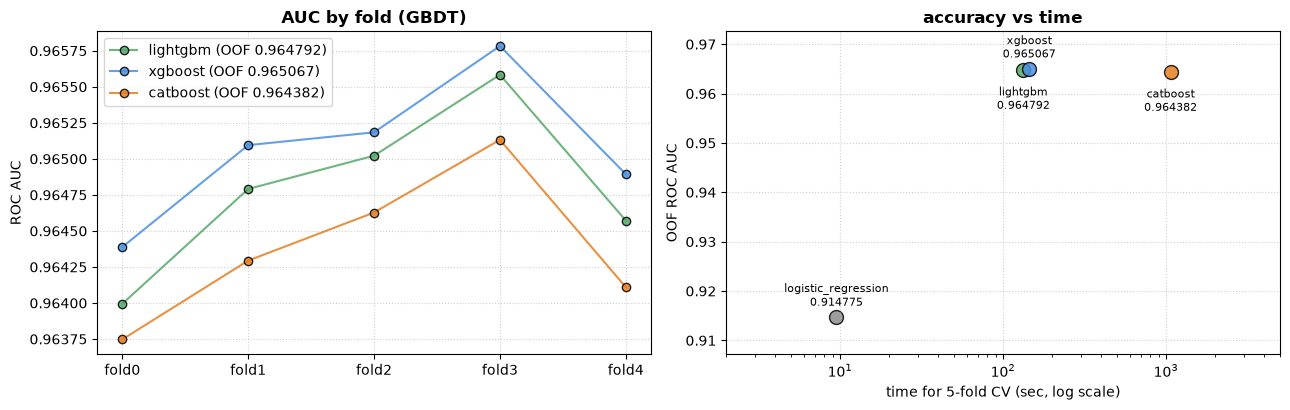
- このグラフを使う理由
- GBDT 3 つの差は 0.0003〜0.0007 しかなく、棒グラフでは同じ長さに見える。Fold ごとの折れ線にすると、順位が 5 Fold で一貫しているか(分割の運ではないか)を確かめられる。右は、精度だけでなく時間も比べるために、2 つを縦と横の軸に取った散布図にする。
- 何を見るか
- 左では、線どうしが交差していないか。交差せずに上下の順が保たれていれば、その差は分割の運ではない。右では、少しの精度のために何倍の時間がかかるか。
- 見方
- 左は、横軸が Fold、縦軸が ROC AUC で、緑が LightGBM、青が XGBoost、オレンジが CatBoost。右は、横軸が 5-Fold の学習時間(秒、対数)、縦軸が OOF AUC で、灰色が LogisticRegression である。学習時間は実行するたびに変わる。
図 6.1 の左の折れ線では、5 つの Fold すべてで青(XGBoost)が緑(LightGBM)より上、緑がオレンジ(CatBoost)より上にある。3 本の線は同じ形に上下していて、どのモデルも fold3 が最も高く、fold0 が最も低い。Fold の難しさはモデルに関係なく共通で、そのうえで順位が 5 Fold とも変わらないので、XGBoost・LightGBM・CatBoost の順の差は分割の運ではない。
図 6.1 の右では、LogisticRegression だけが左下に離れていて、GBDT の 3 つは上にほぼ横一列に並ぶ。精度はほとんど同じなのに、時間は CatBoost だけが右に大きく離れている。なお、学習時間は実行するたびに、マシンの混み具合で変わる。上の出力と図は同じ実行のものである。以前に同じコードを回したときは、XGBoost・CatBoost・LogisticRegression が 1.1〜2.2 倍ほど時間がかかり、この 3 つの AUC は小数 6 桁まで同じであった(LightGBM は、第5章で選ばれたパラメータがそのときと違うので比べない)。速い順(LogisticRegression・LightGBM・XGBoost・CatBoost)は今回も同じである。自分で回すときも、時間の数字そのものより、モデルどうしの順と桁を見る。
次の 6-6 では、4 つのモデルの OOF 予測がどれくらい似ているか(相関)を測る。
6-6予測同士の相関を見る
次にやること
前の節で、4 つのモデルの単体スコアが出た。次は、4 つの OOF 予測同士の相関行列を計算し、モデルの間にどれくらい多様性があるかを測る。相関行列はヒートマップにし、相関 0.995 と 0.85 が実際にどれくらいの違いかを、予測どうしの散布図でも見る。
理由
多様性の測り方:ピアソン相関は、予測確率のスケールも含めた似かたを測る。スピアマン順位相関は、順序の似かたを測る。ROC-AUC は順位で決まる指標なので、スピアマン相関を見ると「順位付けがどれくらい違うか」がつかめる。
相関の限界:「相関が低いモデルほどアンサンブルが効く」とは限らない。単体スコアが大きく劣るモデルは、相関が低くても、混ぜると全体の精度を下げる。相関と単体スコアはセットで見る。
高精度同士の小さな差:相関が非常に高いモデル同士でも、木の育て方が違えば予測に小さなずれ(残差の差)が残る。精度が同じくらいのモデル同士なら、この小さな差を平均することで、予測のぶれを減らせることがある。
相関の数字を散布図で見る:相関 0.995 と 0.85 の違いは、数字だけでは想像しにくい。2 つのモデルの OOF 予測を横軸と縦軸に取って点を打つと、相関が高いほど点が対角線に集まる。69 万点をそのまま打つと塗りつぶされるので、平面を六角形の区画に分けて点の数を色の濃さで表す(hexbin)。
コード
oof_df = pd.DataFrame(oof_predictions)
corr_pearson = oof_df.corr(method="pearson")
corr_spearman = oof_df.corr(method="spearman")
print("--- ピアソン相関行列 ---")
print(corr_pearson.round(4))
print("\n--- スピアマン順位相関行列 ---")
print(corr_spearman.round(4))
次に、2 つの相関行列をヒートマップにする。
_fig, _axes = plt.subplots(1, 2, figsize=(13, 5))
for _ax, (_name, _corr) in zip(_axes, [("Pearson", corr_pearson), ("Spearman", corr_spearman)]):
    sns.heatmap(_corr, annot=True, fmt=".4f", cmap="coolwarm", vmin=0.8, vmax=1.0,
                square=True, cbar=False, ax=_ax)
    _ax.set_title(f"{_name} correlation of OOF predictions", fontweight="bold")
_fig.tight_layout()
_fig
最後に、XGBoost の予測を横軸に取り、LightGBM(相関が高い)と LogisticRegression(相関が低い)の予測を縦軸にした散布図を並べる。
_fig, _axes = plt.subplots(1, 2, figsize=(11, 4.8))
for _ax, _other in zip(_axes, ["lightgbm", "logistic_regression"]):
    _ax.hexbin(oof_df["xgboost"], oof_df[_other], gridsize=60, bins="log", mincnt=1, cmap="Greys")
    _ax.plot([0, 1], [0, 1], color="gray", linestyle="--", linewidth=1)   # 2 つの予測が同じなら、点はこの線に乗る
    _ax.set_xlabel("xgboost (OOF)")
    _ax.set_ylabel(f"{_other} (OOF)")
    _ax.set_title(f"pearson {corr_pearson.loc['xgboost', _other]:.4f}", fontweight="bold")
_fig.tight_layout()
_figdf.corr(method="pearson") | 予測確率値そのものの線形相関を見る(ブレンディングの相性) |
|---|---|
df.corr(method="spearman") | 予測確率値の順位相関(rank correlation)を見る(ROC-AUC 指標との整合性) |
sns.heatmap(..., vmin=0.8, vmax=1.0, square=True) | 色の範囲を 0.8〜1.0 にして、0.99 台どうしの違いも色で見えるようにする。square=True でマスを正方形にする |
ax.hexbin(x, y, gridsize=60, bins="log", mincnt=1) | 平面を六角形の区画に分け、区画ごとの点の数を色の濃さで描く。bins="log" で数の対数を色にし、点の少ない区画も見えるようにする。mincnt=1 で点のない区画は塗らない |
結果
--- ピアソン相関行列 ---
                     lightgbm  xgboost  catboost  logistic_regression
lightgbm               1.0000   0.9950    0.9935               0.8464
xgboost                0.9950   1.0000    0.9929               0.8453
catboost               0.9935   0.9929    1.0000               0.8489
logistic_regression    0.8464   0.8453    0.8489               1.0000

--- スピアマン順位相関行列 ---
                     lightgbm  xgboost  catboost  logistic_regression
lightgbm               1.0000   0.9964    0.9930               0.9081
xgboost                0.9964   1.0000    0.9934               0.9078
catboost               0.9930   0.9934    1.0000               0.9130
logistic_regression    0.9081   0.9078    0.9130               1.0000
GBDT の 3 つ:互いの相関はピアソンで 0.9929〜0.9950、スピアマンで 0.9930〜0.9964 と、非常に高い。3 つとも深さ 3〜4 の浅い木を数千本並べた、よく似たモデルになったためと考えられる。それでも木の育て方(葉優先・深さ優先・対称木)の違いから、予測に小さなずれが残っている。単体スコアも 0.9644〜0.9651 とほぼ同じなので、混ぜても足を引っ張り合う心配は少ない組み合わせである。
LogisticRegression:GBDT との相関はピアソンで 0.8453〜0.8489(スピアマン 0.9078〜0.9130)で、多様性は最も大きい。しかし単体 AUC は 0.914775 で、XGBoost(0.965067)より約 0.05 低い。等しい重みで混ぜると、全体の精度を大きく下げる。
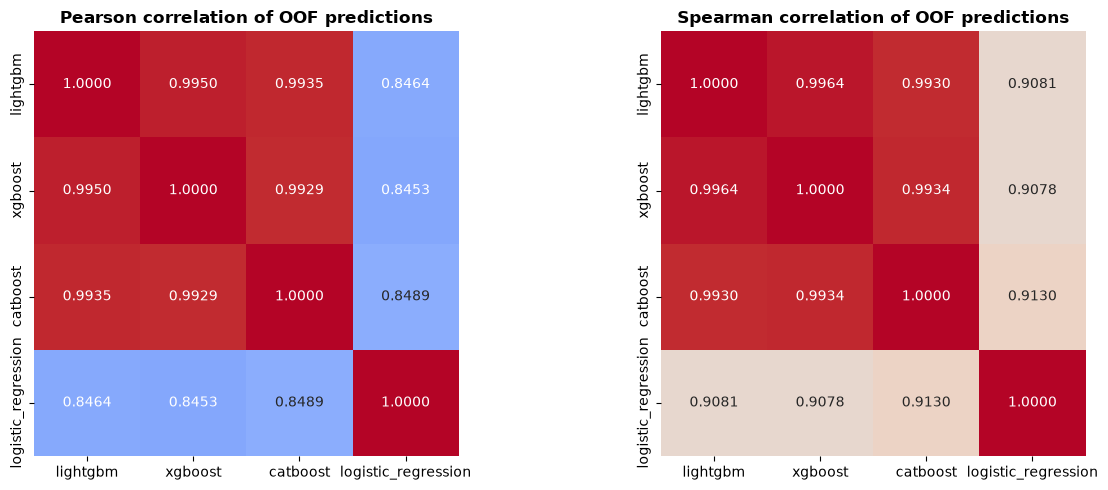
- このグラフを使う理由
- ピアソンとスピアマンの 2 種類の相関行列を並べて比べるには、数字の表より色のほうが速い。0.99 台どうしの違いも色で見えるように、色の範囲を 0.8〜1.0 に絞る。
- 何を見るか
- どのモデルの組が似ていて、どのモデルが離れているか。ピアソンとスピアマンで差が大きい組は、予測の順位は似ていても、確率の値の付け方が違う。
- 見方
- 左がピアソン、右がスピアマン。縦と横にモデルが並び、マスの数字は 2 つのモデルの予測の相関。赤が濃いほど相関が高く、青に寄るほど低い(色の範囲は 0.8〜1.0)。
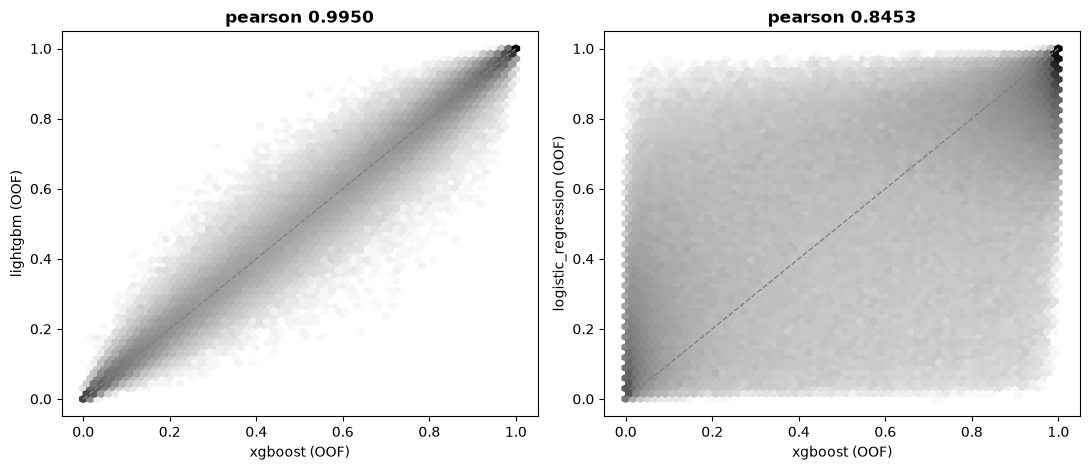
- このグラフを使う理由
- 相関 0.995 と 0.85 の違いは、数字だけでは想像しにくい。2 つのモデルの予測を縦と横に取った散布図にすると、どの行でどれだけずれるかが見える。69 万点をそのまま打つと塗りつぶされるので、点の数を色の濃さで表す hexbin にする。
- 何を見るか
- 点が対角線の近くに集まっているか、広く散らばっているか。対角線から離れた点が、2 つのモデルで予測が食い違う行である。
- 見方
- 横軸は XGBoost の OOF 予測、縦軸は左が LightGBM、右が LogisticRegression の OOF 予測。六角形の区画の濃さが点の数(対数)で、点線は 2 つの予測が同じ値になる線である。
図 6.2 のヒートマップでは、GBDT 3 つどうしのマスがどれも濃い赤で、LogisticRegression の行と列だけが違う色になる(ピアソンでは青、スピアマンでは白に近い色)。ピアソン(左)のほうが LogisticRegression との差がはっきり出るのは、確率の値そのものの付け方が GBDT と大きく違うためである。順位で見るスピアマン(右)では、差は小さくなる。
図 6.3 の散布図を見ると、相関 0.9950 の XGBoost と LightGBM(左)は、点が対角線に沿った細い帯に集まる。全行で見ると 2 つの予測の差の中央値は 0.003 で、XGBoost が 0.3〜0.7 と迷っている行でも、9 割の行は差が ±0.12 に収まる。この小さなずれが、7-1 で平均したときに打ち消し合う部分である。相関 0.8453 の LogisticRegression(右)は、点が四角い範囲いっぱいに広がる。XGBoost が 0.05 未満と予測した 67,369 行でも、LogisticRegression の予測は中央値が 0.12 で、上位 5% の行は 0.52 を超える。違う予測であるのは確かだが、XGBoost のほうが AUC で 0.05 高いので、このずれの多くは LogisticRegression の外れである。相関が低いことと、混ぜて役に立つことは別である。
次の 6-7 では、4 つのモデルの OOF 予測と test 予測をファイルに保存し、第7章に渡す準備をする。
6-7OOF と test の予測を保存する
次にやること
前の節で、4 つのモデルの性能と相関が分かった。次は、第7章のアンサンブル(ブレンディング・スタッキング)で使うために、全モデルの OOF 予測・test 予測と比較表を保存する。
理由
学習をやり直さずに済む:予測値をファイルに保存すれば、第7章で時間のかかるモデル学習(CatBoost だけで約 18 分)をやり直さずに、すぐに重み最適化やブレンド比率の探索に進める。
正解ラベルと fold も一緒に保存する:OOF 予測の横に正解ラベル(addicted_label)と fold を並べると、次の章では読み込むだけで評価や Fold ごとの検証ができる。
コード
# 比較表 CSV の保存
comp_csv_path = RESULTS_DIR / "06_model_comparison.csv"
comp_summary_df.to_csv(comp_csv_path, index=False)
print(f"Saved comparison to {comp_csv_path}")
print(comp_summary_df.to_string(index=False))

# OOF 予測の保存
oof_save_df = pl.DataFrame({
    ID: folds_df[ID],
    "fold": folds_df["fold"],
    TARGET: folds_df[TARGET],
    "pred_lightgbm": oof_predictions["lightgbm"],
    "pred_xgboost": oof_predictions["xgboost"],
    "pred_catboost": oof_predictions["catboost"],
    "pred_logistic_regression": oof_predictions["logistic_regression"],
})
oof_out_path = PROCESSED_DIR / "oof_predictions.parquet"
oof_save_df.write_parquet(oof_out_path)
print(f"Saved OOF predictions to {oof_out_path} (shape: {oof_save_df.shape})")

# Test 予測の保存
test_save_df = pl.DataFrame({
    ID: test_ids,
    "pred_lightgbm": test_predictions["lightgbm"],
    "pred_xgboost": test_predictions["xgboost"],
    "pred_catboost": test_predictions["catboost"],
    "pred_logistic_regression": test_predictions["logistic_regression"],
})
test_out_path = PROCESSED_DIR / "test_predictions.parquet"
test_save_df.write_parquet(test_out_path)
print(f"Saved Test predictions to {test_out_path} (shape: {test_save_df.shape})")
最後に、3-8 の実験記録 experiments.csv に、4 つのモデルの結果を 1 行ずつ足す。
# 3-8 の実験記録に、4 つのモデルの結果を 1 行ずつ足す(学習時間は実行ごとに変わるので記録しない)
_params = {"lightgbm": "ch5_tuned", "xgboost": "ch6_tuned", "catboost": "ch6_tuned", "logistic_regression": "default"}
_log_path = RESULTS_DIR / "experiments.csv"
_row = pl.DataFrame({
    "exp": [f"06_{_r['model']}" for _r in comparison_records],
    "features": ["v1_14"] * len(comparison_records),
    "model": [_r["model"] for _r in comparison_records],
    "params": [_params[_r["model"]] for _r in comparison_records],
    "cv_auc": [_r["oof_auc"] for _r in comparison_records],
    "cv_std": [_r["fold_std"] for _r in comparison_records],
    "public_lb": [None] * len(comparison_records),
    "note": ["6-5"] * len(comparison_records),
})
if _log_path.exists():
    # 同じ実験名(exp)の行は置き換える。marimo がこのセルを再実行しても行は増えない
    _old = pl.read_csv(_log_path).filter(~pl.col("exp").is_in(_row["exp"].to_list()))
    _row = pl.concat([_old, _row], how="diagonal_relaxed")
_row.write_csv(_log_path)
print(_row)oof_predictions.parquet | 各モデルの OOF 予測値 + 正解ラベル(addicted_label)+ fold + id |
|---|---|
test_predictions.parquet | 各モデルの test 予測値(5-Fold 平均)+ id |
06_model_comparison.csv | モデル名・OOF AUC・Fold 間 std・学習時間の比較サマリー |
結果
Saved comparison to D:\kaggle\smartphone-addiction_s6e8\results\06_model_comparison.csv
              model  oof_auc  fold_std  train_time_sec
           lightgbm 0.964792  0.000522           133.2
            xgboost 0.965067  0.000451           144.7
           catboost 0.964382  0.000471          1066.3
logistic_regression 0.914775  0.000802             9.5
Saved OOF predictions to D:\kaggle\smartphone-addiction_s6e8\data\processed\oof_predictions.parquet (shape: (691369, 7))
Saved Test predictions to D:\kaggle\smartphone-addiction_s6e8\data\processed\test_predictions.parquet (shape: (296302, 5))
OOF 予測は 691,369 行 × 7 列(id・fold・正解ラベル・4 モデルの予測)、test 予測は 296,302 行 × 5 列(id・4 モデルの予測)で保存できた。比較表は 6-5 の結果と一致している。
┌────────────────────────┬─────────────┬─────────────────────┬──────────────────────┬──────────┬──────────┬───────────┬───────────────────────────────┐
│ exp                    ┆ features    ┆ model               ┆ params               ┆ cv_auc   ┆ cv_std   ┆ public_lb ┆ note                          │
╞════════════════════════╪═════════════╪═════════════════════╪══════════════════════╪══════════╪══════════╪═══════════╪═══════════════════════════════╡
│ 03_baseline            ┆ baseline_12 ┆ lgbm                ┆ lr0.05_n500          ┆ 0.960379 ┆ 0.000631 ┆ null      ┆ 基準値                        │
│ 04_features_v1         ┆ v1_14       ┆ lgbm                ┆ lr0.05_n500          ┆ 0.960856 ┆ 0.000614 ┆ null      ┆ 4-9: baseline_12 + 2 features │
│ 05_lgbm_tuned          ┆ v1_14       ┆ lgbm                ┆ optuna25_lr0.1_n5268 ┆ 0.964792 ┆ 0.000522 ┆ null      ┆ configs/selected_params.json  │
│ 06_lightgbm            ┆ v1_14       ┆ lightgbm            ┆ ch5_tuned            ┆ 0.964792 ┆ 0.000522 ┆ null      ┆ 6-5                           │
│ 06_xgboost             ┆ v1_14       ┆ xgboost             ┆ ch6_tuned            ┆ 0.965067 ┆ 0.000451 ┆ null      ┆ 6-5                           │
│ 06_catboost            ┆ v1_14       ┆ catboost            ┆ ch6_tuned            ┆ 0.964382 ┆ 0.000471 ┆ null      ┆ 6-5                           │
│ 06_logistic_regression ┆ v1_14       ┆ logistic_regression ┆ default              ┆ 0.914775 ┆ 0.000802 ┆ null      ┆ 6-5                           │
└────────────────────────┴─────────────┴─────────────────────┴──────────────────────┴──────────┴──────────┴───────────┴───────────────────────────────┘
実験記録は 7 行になった。第6章の 4 つのモデルは、同じ 14 列の特徴量・同じ 5-Fold で測ったので、cv_auc の列をそのまま比べられる。
この章で分かったことを、第7章への申し送りとしてまとめる。
1. 全モデルの比較結果サマリー (3 つの GBDT は同じ手順で調整済み):
   - XGBoost:            OOF AUC = 0.965067, Fold std = 0.000451, 時間 =  144.7s (単体最強)
   - LightGBM:           OOF AUC = 0.964792, Fold std = 0.000522, 時間 =  133.2s (最速の GBDT)
   - CatBoost:           OOF AUC = 0.964382, Fold std = 0.000471, 時間 = 1066.3s (木が 7424 本で遅い)
   - LogisticRegression: OOF AUC = 0.914775, Fold std = 0.000802, 時間 =    9.5s (低スコア・単純ブレンド除外)
2. OOF 予測の相関構造:
   - GBDT 3 種どうし:                Pearson = 0.9929〜0.9950, Spearman = 0.9930〜0.9964 (非常に高い相関)
   - GBDT 3 種 vs LogisticRegression: Pearson = 0.8453〜0.8489, Spearman = 0.9078〜0.9130 (低相関だがスコア劣後)
3. 第7章 (アンサンブル) への選定方針:
   - 比較の基準: 単体最強の XGBoost (0.965067)
   - GBDT 3 種は単体スコアがほぼ同じなので、3 つを混ぜる平均・重み付けを主に試す
   - LogisticRegression は単純平均に入れると下がるかを 7-1 で確かめ、スタッキングのメタ特徴量として使う
   - 成果物保存先:
     - data/processed/oof_predictions.parquet (691,369 行 x 7 列)
     - data/processed/test_predictions.parquet (296,302 行 x 5 列)
     - results/06_model_comparison.csv
次の第7章では、ここで保存した予測だけを使ってモデルを混ぜ、単体最強の XGBoost を超えられるかを確かめて、最終提出を決める。