CH 4特徴量を作る(特徴量エンジニアリング)
第3章では LightGBM のベースラインを作り、OOF AUC 0.960379(3-4)を基準値、シードを変えたときの揺らぎ幅 0.000163(3-5)をノイズフロアとして記録した。この章では、この 2 つの数字をものさしにして特徴量を足していく。目的は、思いつく特徴量をたくさん作ることではない。ドメインの仮説から作った特徴量を 1 つずつ足して測り、意味のある改善だけを残すことである。
進め方は 3 段である。評価の仕組みを作る(4-2 で採択ルール、4-3 で測る関数)→ 各節で ① 特徴量を作って中身を見る → ② 評価する。作る処理と測る処理を分けると、新しい列の値がおかしくないかを確かめてから実験でき、どこで何をしているかも追いやすくなる。最後に、採択した特徴量を保存して第5章に渡す。
4-1データと folds.csv を読み込む
次にやること
第3章で、基準値とノイズフロアが決まった。この章は新しいノートブックで始めるので、まずライブラリと定数を用意し、データと第2章 2-2 で保存した固定分割 folds.csv を読み込む。あわせて、以降の実験で使う base_X・y・folds を作る。
理由
fold 列を train_df に持たせる:データと Fold 番号が別々のオブジェクトに分かれていると、絞り込みや並べ替えのときにずれることがある。train_df 自体に fold 列を持たせれば、train_df.filter(pl.col("fold") != f) や train_df.filter(pl.col("fold") == f) のように、学習用と検証用を分かりやすく安全に切り出せる。
横に並べるのではなく id で join する:folds.csv と train.csv の行の順番が何かの理由で入れ替わっていると、列を横にくっつけるだけ(with_columns)では、別の行の Fold 番号が付いてしまう。エラーは出ずにスコアだけがおかしくなる、見つけにくいバグである。共通の識別子 id をキーにして join すれば、行の順番に関係なく正しく対応づけられる。
読み込んだ直後に確かめる:新しいノートブックで始めるときは、読み込んだ直後に行数や欠損を確かめると、あとで型や欠損が原因のエラーに悩まずに済む。ここでは assert で行数の一致と fold 列に欠損がないことを確認する。
実験用の変数をまとめて作る:以降の節では、ベースラインと同じ 12 列の特徴量 base_X(test 側は base_X_test)、目的変数 y、Fold 番号の配列 folds、カテゴリ列の名前 cat_cols を使う。どれも id で結合したあとの train_df から作るので、y と folds の行は必ず対応する。特徴量からは id・目的変数・fold の 3 列を外す。カテゴリ列は 3-2 と同じく pl.Enum にして、train と test で水準をそろえる。
コード
まず、ライブラリと定数を用意する。
# 使うライブラリを用途ごとに直接インポートする
from pathlib import Path
from typing import Any

import matplotlib.pyplot as plt
import numpy as np
import polars as pl
import seaborn as sns
from lightgbm import LGBMClassifier
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold

# データの置き場所と定数を1か所で定義する
PROJECT = Path(r"D:\kaggle\smartphone-addiction_s6e8")   # データの置き場所。自分の環境に合わせて書き換える
RAW_DIR = PROJECT / "data" / "raw"
PROCESSED_DIR = PROJECT / "data" / "processed"
RESULTS_DIR = PROJECT / "results"

ID = "id"
TARGET = "addicted_label"
N_SPLITS = 5
SEED = 42

for _d in (PROCESSED_DIR, RESULTS_DIR):
    _d.mkdir(parents=True, exist_ok=True)

# グラフの色(第1章と同じ): 目的変数の 0 = 青・1 = 赤、train = 紺・test = オレンジ
C0, C1 = "#4A90E2", "#E94E77"
C_TRAIN, C_TEST = "#2b5c8f", "#e27c39"次に、データと固定分割を読み込み、id で fold 列を結合して確かめる。
# 1. 生データ(*_raw の名前で読み、読んだときのまま残す)と固定分割の読み込み
train_raw = pl.read_csv(RAW_DIR / "train.csv")
test_raw = pl.read_csv(RAW_DIR / "test.csv")
folds_df = pl.read_csv(PROCESSED_DIR / "folds.csv")

# 2. train_raw に folds.csv の fold 列を結合して、作業用の train_df を作る
#    (id をキーに安全に結合。行の並びは train_raw のまま保つ)。test_df は test_raw のコピー
train_df = train_raw.join(folds_df.select([ID, "fold"]), on=ID, how="left", maintain_order="left")
test_df = test_raw.clone()

# 3. 整合性の検証 (行数の一致と fold の非欠損)
assert train_df.height == folds_df.height, "行数が一致しません"
assert train_df["fold"].null_count() == 0, "fold 列に欠損があります"

print(f"train_df: {train_df.shape} (fold 結合済み)")
print(f"test_df:  {test_df.shape}")
print("Fold 別件数:\n", train_df["fold"].value_counts().sort("fold"))
最後に、fold 列を結合した train_df から、以降の実験で使う base_X・y・folds・cat_cols を作る。
# 目的変数と Fold 番号は、id で結合済みの train_df から取る(行が必ず対応する)
y = train_df[TARGET].to_numpy()
folds = train_df["fold"].to_numpy()

# カテゴリ変数の水準を固定
cat_cols = [c for c, dt in train_df.schema.items() if dt == pl.String]
levels = {
    c: sorted(
        set(train_df[c].drop_nulls().to_list()) | set(test_df[c].drop_nulls().to_list())
    )
    for c in cat_cols
}

def get_base_features(df: pl.DataFrame) -> pl.DataFrame:
    """第3章(3-2)と同一のベースライン特徴量(12列)を生成する。"""
    drop_cols = [c for c in (ID, TARGET, "fold") if c in df.columns]
    return df.drop(drop_cols).with_columns(
        [pl.col(c).cast(pl.Enum(levels[c])) for c in cat_cols]
    )

base_X = get_base_features(train_df)
base_X_test = get_base_features(test_df)
print("base_X", base_X.shape, "base_X_test", base_X_test.shape)pl.read_csv(path) | CSV を Polars の DataFrame として高速に読み込む。生データは 1-1 と同じく *_raw の名前にする |
|---|---|
df.clone() | 作業用のコピーを作る(1-1 と同じ)。中身は複製せずに共有するので軽い |
df.join(other, on=ID, how="left", maintain_order="left") | id 列(ID)をキーにして folds_df の fold 列を train_raw に安全に結合し、作業用の train_df を作る。train_raw は読んだときのまま残る。Polars の結合は、指定しないと行の並びを保つ保証がないので、maintain_order="left" で train_raw の並びを保つ(5-1 で folds.csv と並びが同じかを確かめる) |
assert cond, msg | 行数の一致、および fold 列に欠損が無いことを検証し、エラーの出ないバグを防ぐ |
df["fold"].value_counts().sort("fold") | 各 Fold のサンプル件数を確認する |
pl.col(c).cast(pl.Enum(levels[c])) | カテゴリ列を、train と test で水準をそろえた Enum 型にする |
df.drop([列名, ...]) | id・目的変数・fold のように、特徴量ではない列を外す |
結果
train_df: (691369, 15) (fold 結合済み)
test_df:  (296302, 13)
Fold 別件数:
┌──────┬────────┐
│ fold ┆ count  │
╞══════╪════════╡
│ 0    ┆ 138274 │
│ 1    ┆ 138274 │
│ 2    ┆ 138274 │
│ 3    ┆ 138274 │
│ 4    ┆ 138273 │
└──────┴────────┘
base_X (691369, 12) base_X_test (296302, 12)
train_df は 691,369 行・15 列である。もとの 14 列(id、12 個の特徴量、目的変数)に fold 列が 1 つ加わった。test_df は目的変数がないので 13 列である。各 Fold は 138,274 件(最後の Fold だけ 138,273 件)で、第2章で作った分割がそのまま使えることを確かめられた。base_X と base_X_test はどちらも 12 列で、fold 列が特徴量に紛れ込んでいないことも分かる。
次の 4-2 では、特徴量を足す前に、採択・不採択を決めるルールを関数にする。
4-2特徴量を足す前に採択ルールを決める
次にやること
4-1 でデータの準備ができた。特徴量を作り始める前に、スコアが動いたときに採択するかどうかを決めるルールを先に決め、関数にする。
理由
先に決める:基準値とノイズフロアがないまま実験を始めると、乱数の揺らぎによる小さなスコアの上昇を「改善」と見まちがえ、役に立たない特徴量を抱え込むことになる。S6E8 のシード間の揺らぎ幅は 0.000163 であった(3-5)。基準値はベースラインの OOF AUC 0.960379 である(3-4)。
閾値は +0.000200:0.000163 を切り上げて、「ΔAUC が +0.000200 以上なら採択、それ未満は誤差として不採択」という境界線を引く。先に線を引くことで、ノイズを拾った過学習や、モデルの無駄な複雑化を防げる。
保留帯は保留:0.000163 から 0.000200 の間は、ノイズフロアは超えたが閾値には届かない保留帯である。ここに入ったものは [保留] とし、単独では採択せず、ほかの特徴量と組み合わせたときの動きを見てから決める。
閾値は実務上の目安:ノイズフロアはシード 3 個ぶんからの推定なので、この値自体にも幅がある。閾値は厳密な統計的基準ではなく、判断をそろえるための実務上の目安として使う。
Fold ごとの勝ち負けも見る:OOF 全体の差だけでなく、同じ Fold どうしで比べて、5 Fold のうちいくつで良くなったかも数える。Fold ごとの難しさ(どの行が検証側に入ったか)は、特徴量ありとなしで共通である。同じ Fold どうしの差を見れば、その難しさが打ち消され、特徴量そのものの効果が残る。「全体では +0.00022 だが、良くなったのは 5 Fold 中 2 Fold だけ」という特徴量は、平均がたまたま押し上げられただけの可能性が高いと判断できる。
採択の条件は 2 つ:「全体の差が +0.000200 以上」かつ「5 Fold 中 4 Fold 以上で改善」の両方を満たしたときだけ採択する。全体の差は閾値を超えても、改善した Fold が 3 つ以下なら [保留] にする。
コード
BASE_AUC = 0.960379
NOISE_FLOOR = 0.000163
THRESHOLD = 0.000200
MIN_BETTER_FOLDS = 4  # 5 Fold のうち、この数以上で良くなっていること

def evaluate_change(new_auc: float, n_better: int | None = None, base_auc: float = BASE_AUC):
    """基準との差と判定を返す。n_better は基準より良くなった Fold の数で、None のときは Fold の条件を見ない。"""
    diff = new_auc - base_auc
    folds_ok = n_better is None or n_better >= MIN_BETTER_FOLDS
    if diff >= THRESHOLD and folds_ok:
        verdict = f"[採択] (有意な改善: +{THRESHOLD:.6f} 以上)"
    elif diff >= THRESHOLD:
        verdict = f"[保留] (閾値以上だが改善 Fold が {MIN_BETTER_FOLDS} 未満)"
    elif diff > NOISE_FLOOR:
        verdict = "[保留] (ノイズフロア超えだが閾値未満)"
    elif diff > 0:
        verdict = "[不採択] (ノイズフロア未満の微増 / 誤差)"
    elif diff == 0:
        verdict = "[不採択] (スコア変動なし)"
    else:
        verdict = "[不採択] (スコア悪化)"
    return diff, verdict

diff, verdict = evaluate_change(BASE_AUC)
print(f"基準値: {BASE_AUC:.6f} | 差分: {diff:+.6f} | {verdict}")evaluate_change(new_auc, n_better, base_auc) | 基準値との差分(ΔAUC)と改善した Fold の数から判定結果を返す自作関数 |
|---|---|
int | None | 「整数か None」を表す型ヒント。n_better を渡さなくても呼べるようにする |
結果
基準値: 0.960379 | 差分: +0.000000 | [不採択] (スコア変動なし)
基準値そのものを渡したので差分は 0 で、「スコア変動なし」と判定された。関数が意図どおりに動くかを確かめるための呼び出しである。判定は 6 通りで、+0.000200 以上かつ 4 Fold 以上で改善なら [採択]、+0.000200 以上でも改善 Fold が 3 以下なら [保留]、+0.000163 を超えて +0.000200 未満も [保留]、それ以下は理由を添えて [不採択] になる。
次の 4-3 では、この evaluate_change を使い、特徴量を 1 つ足して CV を回し、判定まで行う関数を作る。
4-31 つずつ足して比べる仕組みを作る(アブレーション)
次にやること
4-2 で判定ルールが決まった。次は、特徴量を足した表を受け取って CV を回し、基準値と比べて判定するところまでを、1 回の呼び出しでできる関数にする。これが「評価の仕組み」である。特徴量を作る処理は、4-4 以降の各節で先に行う。
理由
1 つずつ足す:特徴量を一度にまとめて足すと、効く特徴量と悪くする特徴量が打ち消し合い、何が効いて何が足を引っ張っているのかが分からなくなる。1 つの仮説ごとにベースラインに足して差分(ΔAUC)を測れば、それぞれの特徴量の寄与を切り分けられる。このやり方をアブレーション実験と呼ぶ。アブレーションは本来、全部入りのモデルから 1 つずつ取り除いて、どれだけ悪くなるかを見る実験である。この本では逆向きに、ベースラインに 1 つずつ足して測る形で使う。Kaggle ではどちらもアブレーションと呼ぶことが多い。
分割を固定する:Fold 分割は、第2章で保存した folds.csv に固定して評価する。分割が変わるとその違いによるぶれがスコアに混ざるので、分割を固定してぶれをなくしたうえで比べる。
モデルの設定は変えない:run_cv の中の LightGBM は learning_rate=0.05、n_estimators=500 で、第3章のベースラインと同じ設定である。変えるのは特徴量だけにする。
ベースラインを回し直して、比べる相手にする:4-2 の「改善した Fold の数」を数えるには、ベースラインの Fold 別スコアが要る。新しいノートブックなので、run_cv でベースラインを一度回し、OOF AUC を base_auc、Fold 別スコアを base_fold_scores に入れる。3-4 と同じ 0.960379 が出れば、データの読み込みと分割が第3章と同じだという確認にもなる。
全体の差も Fold の差も、同じ回の結果と比べる:4-2 の BASE_AUC は、第3章の結果を小数 6 桁で書き写した値である。ここで回し直した base_auc とは、7 桁目より下がわずかに違う。全体の差は書き写した値と、Fold の差は回し直した値と比べる、という混ぜ方をしないように、run_ablation ではどちらも回し直した値と比べる。この 2 つは引数として受け取り、既定値を回し直した値にする。こうすると 4-4 以降は run_ablation(name, X_new, y, folds) と書くだけで済み、何と比べているかも関数の定義に書かれた状態になる。
作ったらすぐ 1 回動かす:特徴量を作る前でも、ベースラインそのものを渡せば関数の動きを確かめられる。同じ表・同じ分割・同じシードなので、差は 0、改善 Fold は 0 になるはずである。そうならなければ、比べ方か CV のどこかにずれがある。
コード
def run_cv(X: pl.DataFrame, y: np.ndarray, folds: np.ndarray, seed: int = 42):
    """5-Fold CV を回し、OOF AUC・Fold 別スコア・OOF 予測・重要度を返す。"""
    params: dict[str, Any] = dict(learning_rate=0.05, n_estimators=500, random_state=seed, verbose=-1)
    oof = np.zeros(len(y))
    fold_scores = []
    importance = np.zeros(X.width)   # 5 Fold の特徴量の重要度(gain)の平均
    for f in range(5):
        tr_mask, va_mask = folds != f, folds == f
        model = LGBMClassifier(**params).fit(
            X.filter(tr_mask).to_pandas(), y[tr_mask], categorical_feature=cat_cols
        )
        pred = np.asarray(model.predict_proba(X.filter(va_mask).to_pandas()))[:, 1]
        oof[va_mask] = pred
        fold_scores.append(roc_auc_score(y[va_mask], pred))
        importance += model.booster_.feature_importance("gain") / 5
    return roc_auc_score(y, oof), fold_scores, oof, importance

# ベースラインを回し直す(比べる相手の OOF AUC と Fold 別スコア)
base_auc, base_fold_scores, _, _ = run_cv(base_X, y, folds)
print(f"ベースライン再確認: OOF AUC {base_auc:.6f} | Fold 別 {np.round(base_fold_scores, 6)}")

def run_ablation(name: str, X_new: pl.DataFrame, y: np.ndarray, folds: np.ndarray,
                 base_auc: float = base_auc, base_fold_scores: list[float] = base_fold_scores):
    """特徴量を足した表 X_new で CV を回し、ベースラインと比べて判定する。
    OOF AUC・差・判定・Fold 別スコア・重要度を返す。"""
    auc, fold_scores, _, importance = run_cv(X_new, y, folds)
    n_better = int((np.array(fold_scores) > np.array(base_fold_scores)).sum())
    diff, verdict = evaluate_change(auc, n_better, base_auc=base_auc)
    print(f"{name:<30} | OOF AUC: {auc:.6f} | diff: {diff:+.6f} | 改善 Fold {n_better}/5 | {verdict}")
    return auc, diff, verdict, fold_scores, importance

# 動作確認: ベースラインそのものを渡すと、差は 0 になるはず(戻り値は使わないので _ に入れる)
_ = run_ablation("baseline (動作確認)", base_X, y, folds)run_cv(X, y, folds) | 固定 5-Fold で CV を回し、OOF AUC・Fold 別スコア・OOF 予測・特徴量の重要度(5 Fold の gain の平均、3-4 と同じ)の 4 つを返す |
|---|---|
run_ablation(name, X_new, y, folds) | 特徴量を足した表で CV を回し、差分・改善 Fold・判定を 1 行で出力する。OOF AUC・差分・判定・Fold 別スコア・重要度の 5 つを返し、4-9 のまとめのグラフで使う。比べる相手(base_auc・base_fold_scores)は、省略すると上で回し直したベースラインになる |
def f(..., a=a) | 引数の既定値は、関数を定義した時点の値で決まる。ここでは回し直したベースラインの値が入る |
(np.array(a) > np.array(b)).sum() | Fold ごとに比べて、良くなった Fold の数を数える |
結果
ベースライン再確認: OOF AUC 0.960379 | Fold 別 [0.959435 0.960136 0.960685 0.961348 0.960292]
baseline (動作確認)                | OOF AUC: 0.960379 | diff: +0.000000 | 改善 Fold 0/5 | [不採択] (スコア変動なし)
3-4 と同じ OOF AUC 0.960379、同じ Fold 別スコアが出た。第3章と同じデータ・同じ分割で比べられていることが確かめられる。
run_ablation は、実験の名前と、特徴量を足したあとの表 X_new を受け取り、run_cv で 5-Fold CV を回し、evaluate_change で判定した結果を 1 行で出力する。1 行には OOF AUC、ベースラインとの差(diff)、5 つの Fold のうちベースラインより良くなった数(改善 Fold)、判定が並ぶ。
2 行目が動作確認の結果である。ベースラインそのものを渡したので、diff は +0.000000、改善 Fold は 0/5、判定は「スコア変動なし」になった。同じ条件なら同じスコアが出ることも、これで確かめられた。4-4 以降で出る差は、足した特徴量によるものだと考えてよいことになる。
次の 4-4 からは、各節で「① 特徴量を作って中身を見る → ② run_ablation で評価する」の順に進める。最初は比率・差分・合計である。
4-4比率・差分・合計を作る
次にやること
4-3 で、特徴量を 1 つ足したときにスコアが基準値 0.960379 からどれだけ動くかを測る run_ablation ができた。ここからは実際に特徴量を作る。最初に試すのは、画面時間とほかの時間の比率・差分と、平日と休日を合わせた週の合計である。
理由
仮説の出どころ:1-7 で、画面時間の 3 列(daily_screen_time_hours・weekend_screen_time・social_media_hours)が強く、work_study_hours と gaming_hours も中程度に効くと分かった。そこで「画面時間がほかの生活時間とどう釣り合っているか」が効くのではないか、という仮説を立てる。
木は割り算や引き算を自分で作れない:決定木は「x が c 以下か」でしか分けられない。そのため、単一の列の単調な変換(log や標準化)には影響を受けないが、2 つの列の割り算や引き算は自分では作れない。そのため、意味のありそうな組み合わせを人が作って渡す。
4 つの仮説:work_to_screen_ratio は、スマホの利用が仕事や勉強をどれだけ圧迫しているかのバランスである。non_leisure_screen は、画面時間のうち SNS とゲーム以外(調べ物や作業など)の時間である。social_share は画面時間に占める SNS の割合、total_weekly_screen は平日 5 日と休日 2 日を合わせた週の画面時間である。
1 つずつ測る:効くかどうかは仮説の段階では分からないので、1 つずつ足して測る。
コード
① 特徴量を作る。名前と作り方(Polars の式)を辞書にまとめ、4 つの候補を一度に計算して中身を見る。
ratio_exprs = {
    # 仕事・勉強時間と画面時間の比率
    "work_to_screen_ratio": pl.col("work_study_hours") / (pl.col("daily_screen_time_hours") + 0.1),
    # 娯楽(SNS・ゲーム)以外の画面時間
    "non_leisure_screen": pl.col("daily_screen_time_hours") - (pl.col("social_media_hours") + pl.col("gaming_hours")),
    # 画面時間に占める SNS の割合
    "social_share": pl.col("social_media_hours") / (pl.col("daily_screen_time_hours") + 0.1),
    # 平日 5 日と休日 2 日を合わせた週の画面時間
    "total_weekly_screen": pl.col("daily_screen_time_hours") * 5 + pl.col("weekend_screen_time") * 2,
}
ratio_feats = base_X.select([expr.alias(name) for name, expr in ratio_exprs.items()])
ratio_feats.describe().with_columns(pl.col(pl.Float64).round(2))
作った列の分布を、1-5 と同じく目的変数の 0(青)と 1(赤)で塗り分けたヒストグラムで見る。
_pdf = ratio_feats.with_columns(pl.Series(TARGET, y)).to_pandas()

_fig, _axes = plt.subplots(1, ratio_feats.width, figsize=(4 * ratio_feats.width, 3.4), squeeze=False)
for _i, (_ax, _c) in enumerate(zip(_axes[0], ratio_feats.columns)):
    sns.histplot(data=_pdf, x=_c, hue=TARGET, palette={0: C0, 1: C1}, multiple="stack",
                 bins=30, alpha=0.5, edgecolor="black", linewidth=0.5, legend=(_i == 0), ax=_ax)
    _ax.set_title(_c, fontweight="bold")
    _ax.set_xlabel("")
_fig.tight_layout()
_fig
② 評価する。作った列を 1 本ずつベースラインの 12 列の右に足し、4-3 の run_ablation で測る。
# ループの変数は 4-5 でも使うので、セルの中だけの名前(_ 付き)にする
ratio_results = {}   # 4-9 のまとめのグラフで使うので、結果を名前ごとに残す
for _name in ratio_feats.columns:
    _X_new = base_X.hstack(ratio_feats.select(_name))   # 12 列 + 1 列 = 13 列
    ratio_results[_name] = run_ablation(_name, _X_new, y, folds)
+ 0.1 は 0 で割るのを防ぐための小さな値である。
pl.col(a) / (pl.col(b) + 0.1) | 0 で割らないよう小さな値を足して比率を作る |
|---|---|
expr.alias(name) | 計算した列に名前を付ける |
df.select([式, ...]) | 式を計算して、その列だけの表を作る(ここで初めて計算される) |
df.describe() | 件数・欠損数・平均・最小・四分位・最大をまとめて見る |
df.with_columns(pl.Series(TARGET, y)) | NumPy の目的変数 y を列として足し、seaborn で色分けに使えるようにする |
sns.histplot(..., hue=TARGET, multiple="stack") | 1-5 と同じ、0 と 1 で塗り分けて積み上げるヒストグラム |
df.hstack(other) | 行数の同じ表を横につなげる |
結果
① 作った特徴量の中身
shape: (9, 5)
┌────────────┬──────────────────────┬────────────────────┬──────────────┬─────────────────────┐
│ statistic  ┆ work_to_screen_ratio ┆ non_leisure_screen ┆ social_share ┆ total_weekly_screen │
│ ---        ┆ ---                  ┆ ---                ┆ ---          ┆ ---                 │
│ str        ┆ f64                  ┆ f64                ┆ f64          ┆ f64                 │
╞════════════╪══════════════════════╪════════════════════╪══════════════╪═════════════════════╡
│ count      ┆ 553430.0             ┆ 451246.0           ┆ 502260.0     ┆ 517906.0            │
│ null_count ┆ 137939.0             ┆ 240123.0           ┆ 189109.0     ┆ 173463.0            │
│ mean       ┆ 0.31                 ┆ 3.71               ┆ 0.32         ┆ 57.15               │
│ std        ┆ 0.13                 ┆ 1.94               ┆ 0.13         ┆ 18.47               │
│ min        ┆ 0.0                  ┆ 0.1                ┆ 0.0          ┆ 5.98                │
│ 25%        ┆ 0.21                 ┆ 2.21               ┆ 0.23         ┆ 41.94               │
│ 50%        ┆ 0.32                 ┆ 3.42               ┆ 0.33         ┆ 58.11               │
│ 75%        ┆ 0.41                 ┆ 4.88               ┆ 0.41         ┆ 72.71               │
│ max        ┆ 0.91                 ┆ 14.33              ┆ 0.87         ┆ 106.96              │
└────────────┴──────────────────────┴────────────────────┴──────────────┴─────────────────────┘
4 つの列が 691,369 行ぶんできた。注意すべきは欠損の数である。材料の列のどれか 1 つでも欠けていると、計算結果も欠損になる。3 つの列を使う non_leisure_screen は 240,123 行(約 35%)が欠損で、材料の daily_screen_time_hours の欠損(95,854 行、1-5)より大きく増えている。LightGBM は欠損をそのまま扱えるので学習は止まらないが、値を持つ行は減る。
値のおかしな点はない。non_leisure_screen の最小値は 0.1 で負の値がなく、「画面時間 ≧ SNS + ゲーム」というつじつまが合っている。比率の 2 列は 0〜0.9 に収まっている。
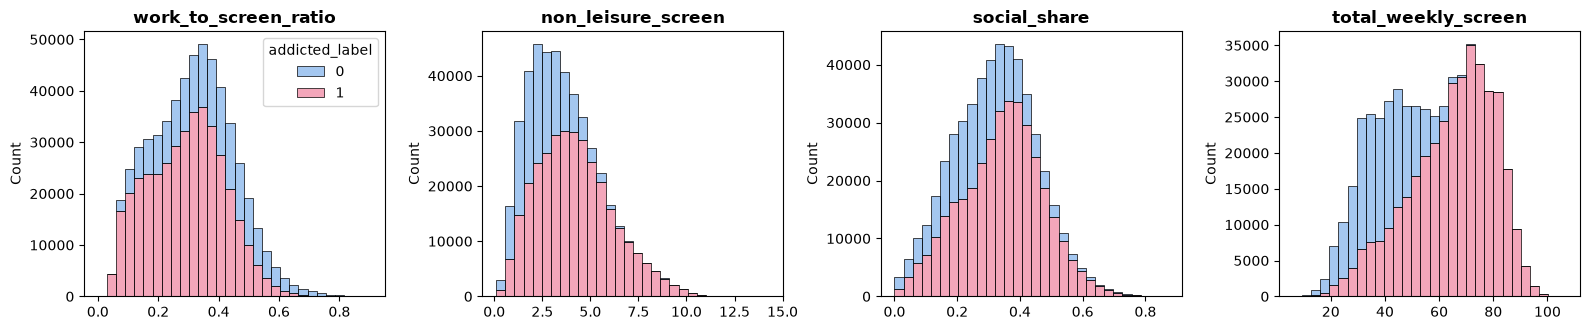
- このグラフを使う理由
- 作った特徴量は、評価する前に中身を見る(4-4 の ①)。図 1.2 と同じ形にすると、元の列と同じ物差しで比べられる。
- 何を見るか
- 値のおかしな偏り(負の値や極端な値)がないかと、値によって赤の割合が変わるか。ただし、単体で赤の割合がよく変わることと、ベースラインに足して効くことは別である(②の評価で確かめる)。
- 見方
- 1 つの枠が 1 列。横軸は値、縦軸は件数。0(青)の上に 1(赤)を積み上げている。
図 4.1 を見ると、4 つの列で赤の増え方が違う。total_weekly_screen は値が大きいほど赤がはっきり増え、1-7 と同じく 4 区間(四分位)に分けて陽性率を出すと、小さい区間から 0.29・0.59・0.96・1.00 と動く。単体では 4 つの中で最も目的変数と関係が強く見える。non_leisure_screen(0.48・0.60・0.80・0.95)と social_share(0.57・0.62・0.79・0.86)も、値が大きいほど赤が増える。work_to_screen_ratio は逆に、値が大きいほど青が増える(0.80・0.76・0.73・0.54)が、動きは 4 つの中で最も小さい。ただし、単体で目的変数と関係が強いかどうかと、ベースラインに足して効くかどうかは別である。②で確かめる。
② 評価の結果
work_to_screen_ratio           | OOF AUC: 0.960726 | diff: +0.000348 | 改善 Fold 5/5 | [採択] (有意な改善: +0.000200 以上)
non_leisure_screen             | OOF AUC: 0.960598 | diff: +0.000219 | 改善 Fold 5/5 | [採択] (有意な改善: +0.000200 以上)
social_share                   | OOF AUC: 0.960339 | diff: -0.000040 | 改善 Fold 4/5 | [不採択] (スコア悪化)
total_weekly_screen            | OOF AUC: 0.960329 | diff: -0.000050 | 改善 Fold 2/5 | [不採択] (スコア悪化)
上の 2 つは 4-2 で決めた 2 つの条件を満たしたので採択する。work_to_screen_ratio は +0.000348 で閾値を大きく超え、5 つの Fold すべてで良くなった。non_leisure_screen は +0.000219 で閾値を超え、こちらも 5 つの Fold すべてで良くなっている。欠損が 35% あっても、値のある行で効いている。
social_share は -0.000040 で悪化した。良くなった Fold は 4 つあるが、全体の差がマイナスなので残さない。total_weekly_screen も -0.000050 で悪化した。もっともらしい仮説でも、測って閾値を超えなければ残さない。
①の 図 4.1 と比べると、結果は逆になった。単体では最も強く見えた total_weekly_screen は悪化し、単体では最も弱く見えた work_to_screen_ratio が最も効いた。total_weekly_screen は daily_screen_time_hours と weekend_screen_time を足しただけの列で、この 2 列はベースラインにすでに入っている。木はこの 2 列で、ほぼ同じ分け方をもう作れる。一方、仕事・勉強の時間と画面時間の比は、木が 2 列からは作れない。足して効くのは、単体で強い列ではなく、元の列から木が作れない情報を持つ列である。3-4 の重要度で見た「単体で弱くても効く列がある」の裏返しである。
次の 4-5 では、グループごとの平均との差や、条件を満たす項目の数といった集約(aggregation)・カウント系の特徴量が効くかを試す。
4-5集約・カウント系の特徴量を試す
次にやること
4-4 では、画面時間とほかの時間の比率・差分から 2 つの特徴量を採択できた。次は、グループごとの平均との差と、高利用の条件をいくつ満たしているかを数えた特徴量を試す。
理由
仮説:「同じストレス度の人の平均より何時間多く画面を見ているか」という相対的なずれや、複数のリスク項目をいくつ同時に満たしているかは、ドメインの感覚としてはもっともらしい仮説に見える。
キーにする列に情報があるか:ただし EDA(1-6)で確認したとおり、stress_level などのカテゴリ列は、どの値でも陽性率が全体平均(0.709)とほとんど変わらない。目的変数と関係の薄い列でグループ集約しても、得られる値はノイズに近くなると予想できる。予想だけで決めず、測って確かめる。
書き方:グループ平均は .mean().over("stress_level") で、行数を変えずに各行へ付けられる。条件の数は、比較の結果を 0/1 の整数にして足し合わせる。欠損があると比較の結果も欠損になるので、fill_null(0) で「条件を満たさない」として数える。
コード
① 特徴量を作る。
agg_exprs = {
    # 同じストレス度の人の平均より、何時間多く画面を見ているか
    "screen_diff_stress_mean": pl.col("daily_screen_time_hours")
    - pl.col("daily_screen_time_hours").mean().over("stress_level"),
    # 高利用の条件をいくつ満たしているか(0〜5)
    "high_usage_risk_count": (
        (pl.col("daily_screen_time_hours") > 8).cast(pl.Int8).fill_null(0)
        + (pl.col("social_media_hours") > 3).cast(pl.Int8).fill_null(0)
        + (pl.col("gaming_hours") > 2).cast(pl.Int8).fill_null(0)
        + (pl.col("app_opens_per_day") > 50).cast(pl.Int8).fill_null(0)
        + (pl.col("sleep_hours") < 6).cast(pl.Int8).fill_null(0)
    ),
}
agg_feats = base_X.select([expr.alias(name) for name, expr in agg_exprs.items()])
print(agg_feats.describe().with_columns(pl.col(pl.Float64).round(2)))
print(agg_feats["high_usage_risk_count"].value_counts().sort("high_usage_risk_count"))
② 評価する。
agg_results = {}   # 4-9 のまとめのグラフで使う
for _name in agg_feats.columns:
agg_results[_name] = run_ablation(_name, base_X.hstack(agg_feats.select(_name)), y, folds)pl.col(x).mean().over(group) | グループ別平均を、行数を変えずに各行へ付ける |
|---|---|
(cond).cast(pl.Int8) | 条件の成立を 0/1 の整数にして、行ごとに足し合わせる |
pl.col(c).fill_null(0) | 欠損で比較できなかった行を 0(条件を満たさない)にする |
s.value_counts().sort(col) | 値ごとの件数を、値の順に並べて見る |
結果
① 作った特徴量の中身
shape: (9, 3)
┌────────────┬─────────────────────────┬───────────────────────┐
│ statistic  ┆ screen_diff_stress_mean ┆ high_usage_risk_count │
│ ---        ┆ ---                     ┆ ---                   │
│ str        ┆ f64                     ┆ f64                   │
╞════════════╪═════════════════════════╪═══════════════════════╡
│ count      ┆ 595515.0                ┆ 691369.0              │
│ null_count ┆ 95854.0                 ┆ 0.0                   │
│ mean       ┆ -0.0                    ┆ 1.9                   │
│ std        ┆ 2.72                    ┆ 1.16                  │
│ min        ┆ -7.2                    ┆ 0.0                   │
│ 25%        ┆ -2.17                   ┆ 1.0                   │
│ 50%        ┆ 0.14                    ┆ 2.0                   │
│ 75%        ┆ 2.19                    ┆ 3.0                   │
│ max        ┆ 7.43                    ┆ 5.0                   │
└────────────┴─────────────────────────┴───────────────────────┘
shape: (6, 2)
┌───────────────────────┬────────┐
│ high_usage_risk_count ┆ count  │
│ ---                   ┆ ---    │
│ i8                    ┆ u32    │
╞═══════════════════════╪════════╡
│ 0                     ┆ 67622  │
│ 1                     ┆ 218367 │
│ 2                     ┆ 199911 │
│ 3                     ┆ 137467 │
│ 4                     ┆ 58821  │
│ 5                     ┆ 9181   │
└───────────────────────┴────────┘
screen_diff_stress_mean の平均は、表では -0.0(計算すると -1.9549e-16)で、ほぼ 0 である。グループの平均を引いた値なので、全体の平均が 0 になるのは計算どおりである。標準偏差(表では 2.72)も元の daily_screen_time_hours の 2.721446(1-5)とほとんど同じである。stress_level ごとの平均がほぼ同じなので、平均を引いても元の列を少しずらしただけになっている。この時点で、新しい情報はほとんどないと予想できる。
high_usage_risk_count は欠損がなく(fill_null(0) のため)、0〜5 の 6 通りに分かれた。1〜2 個の人が多く、5 個すべてに当てはまる人は 9,181 人である。
② 評価の結果
screen_diff_stress_mean        | OOF AUC: 0.960431 | diff: +0.000052 | 改善 Fold 2/5 | [不採択] (ノイズフロア未満の微増 / 誤差)
high_usage_risk_count          | OOF AUC: 0.960461 | diff: +0.000082 | 改善 Fold 5/5 | [不採択] (ノイズフロア未満の微増 / 誤差)
screen_diff_stress_mean は +0.000052、high_usage_risk_count は +0.000082 で、どちらもノイズフロア(0.000163)に届かなかった。high_usage_risk_count は 5 つの Fold すべてでわずかに良くなったが、全体の差が小さすぎるので誤差として扱う。①で見たとおり、情報を持たない stress_level でグループ集約しても、元の列をずらしただけの値にしかならなかった。high_usage_risk_count も、元の列を人が決めた閾値で 0/1 にして数えただけなので、木は元の列から同じ分け方を作れる。集約特徴量は、キーにする列そのものに目的変数との関係がある場合にしか効かない。
次の 4-6 では、欠損しているかどうかを表す列(欠損フラグ)が効くかを測る。
4-6欠損フラグを試す
次にやること
4-5 の集約・カウント系は、2 つとも不採択であった。次は、入門書でよく紹介される欠損フラグ(各列が欠損しているかどうかを表す 0/1 の列)と、行ごとの欠損数を試す。
理由
定石をそのまま使わない:コンペの入門書では「欠損フラグを追加する」方法がよく出てくる。しかし EDA(1-4, 1-7)で確かめたとおり、S6E8 では欠損している行の陽性率が全体平均とほぼ同じで、欠損はランダムに起きている(ランダム欠損)。ランダム欠損なら、「欠損している」という事実そのものは目的変数の手がかりにならない。
LightGBM は欠損を自分で扱う:LightGBM は標準で、決定木の各分岐で欠損値を左右どちらに送るとよいかを自動で決める。そのため、欠損フラグをわざわざ渡しても新しい情報は増えにくいと予想できる。
予想でも測る:予想だけで決めず、全列の欠損フラグと行ごとの欠損数の 2 通りを実測して結論を出す。
コード
① 特徴量を作る。12 列それぞれの欠損フラグ(12 列)と、行ごとの欠損数(1 列)を作る。
# 各列が欠損なら 1、そうでなければ 0
null_flags = base_X.select([
    pl.col(c).is_null().cast(pl.Int8).alias(f"{c}_isnan") for c in base_X.columns
])
# 1 行に欠損がいくつあるか
null_count = base_X.select(
    pl.sum_horizontal([pl.col(c).is_null() for c in base_X.columns]).alias("null_count")
)
print(null_flags.shape)
print(null_count["null_count"].value_counts().sort("null_count"))
② 評価する。欠損フラグは 12 列をまとめて 1 つの実験にする。
null_results = {   # 4-9 のまとめのグラフで使う
    "all_null_indicators": run_ablation("all_null_indicators", base_X.hstack(null_flags), y, folds),
    "row_null_count": run_ablation("row_null_count", base_X.hstack(null_count), y, folds),
}pl.col(c).is_null().cast(pl.Int8) | 欠損の有無を 0/1 の整数列にする |
|---|---|
pl.sum_horizontal([...]) | 複数の列を行ごとに足す(ここでは欠損の数を数える) |
結果
① 作った特徴量の中身
(691369, 12)
shape: (12, 2)
┌────────────┬────────┐
│ null_count ┆ count  │
│ ---        ┆ ---    │
│ u32        ┆ u32    │
╞════════════╪════════╡
│ 0          ┆ 269185 │
│ 1          ┆ 180459 │
│ 2          ┆ 120697 │
│ 3          ┆ 67328  │
│ 4          ┆ 32557  │
│ …          ┆ …      │
│ 7          ┆ 1676   │
│ 8          ┆ 477    │
│ 9          ┆ 136    │
│ 10         ┆ 18     │
│ 11         ┆ 1      │
└────────────┴────────┘
欠損フラグは 12 列できた。欠損がまったくない行は 269,185 行(約 39%)で、残りの約 6 割の行はどこかが欠けている。1 行に 11 個欠けている行も 1 行ある(表の「…」は Polars が途中の行を省略した印である)。
② 評価の結果
all_null_indicators            | OOF AUC: 0.960418 | diff: +0.000040 | 改善 Fold 4/5 | [不採択] (ノイズフロア未満の微増 / 誤差)
row_null_count                 | OOF AUC: 0.960426 | diff: +0.000048 | 改善 Fold 4/5 | [不採択] (ノイズフロア未満の微増 / 誤差)
全列の欠損フラグは +0.000040、行ごとの欠損数は +0.000048 で、どちらもノイズフロア(0.000163)に届かなかった。良くなった Fold はどちらも 4 つあるが、全体の差は誤差の範囲である。
欠損のある行が 6 割もあっても、欠損はランダムに起きているので、「欠けている」こと自体はほとんど手がかりにならない。予想どおり、S6E8 では欠損フラグは効かない。欠損がランダムに起きているかどうかを EDA で確かめずに欠損フラグを足しても、効果は期待できないということである。
S6E8 には名前のような、中から情報を取り出せる文字列の列がないので、次の 4-7 では別のデータ(Titanic)で文字列から特徴量を作る方法を見る。
4-7文字列の列から特徴量を作る
次にやること
S6E8 の文字列の列は数種類のカテゴリだけで、名前やチケット番号のような自由な文字列の列はない。1-3 の囲みで見た Titanic の Name・Ticket・Cabin のような列から、中身を取り出して特徴量を作る方法を見る。
理由
文字列の中にある情報を取り出す:Name の「Mr.」「Mrs.」「Master.」は性別・年齢・既婚かどうかを表す。Cabin の先頭の文字はデッキ(船の階)である。SibSp と Parch を足すと家族の人数になる。どれも Titanic でよく使われる定番の特徴量である。
定番でも測って決める:4-4 と同じく、1 つずつ足してスコアを比べる。小さいデータなので Accuracy ではなく logloss で比べ、4-2 で判定に加えた「5 Fold のうちいくつで良くなったか」も表示する。
コード
t5_strfeat.py(準備は 1-3 の囲みの t0_setup.py)
from t0_setup import *
base_oof = run_cv(X0, y, folds, N)

def fold_logloss(oof: np.ndarray) -> np.ndarray:
    return np.array([log_loss(y[folds == f], oof[folds == f]) for f in range(5)])

def ablation(name: str, exprs: list[pl.Expr]) -> None:
    oof = run_cv(X0.with_columns(train.select(exprs)), y, folds, N)
    diff = log_loss(y, oof) - log_loss(y, base_oof)
    n_better = int((fold_logloss(oof) < fold_logloss(base_oof)).sum())
    print(f"{name:<13}| logloss {log_loss(y, oof):.4f} ({diff:+.4f}) | acc {accuracy_score(y, oof > 0.5):.4f} | 改善した Fold {n_better}/5")

# Name から敬称を取り出す("Braund, Mr. Owen Harris" → "Mr")
title = (pl.col("Name").str.extract(r",\s*([^\.]+)\.")
         .replace({"Mlle": "Miss", "Ms": "Miss", "Mme": "Mrs"}))
print(train.select(title.alias("Title"))["Title"].value_counts(sort=True).head(5))

print(f"{'基準':<13}| logloss {log_loss(y, base_oof):.4f} | acc {accuracy_score(y, base_oof > 0.5):.4f}")
ablation("title", [pl.when(title.is_in(["Mr", "Mrs", "Miss", "Master"])).then(title)
                     .otherwise(pl.lit("Rare")).cast(pl.Categorical).alias("Title")])
ablation("family_size", [(pl.col("SibSp") + pl.col("Parch") + 1).alias("FamilySize")])
ablation("deck", [pl.col("Cabin").str.slice(0, 1).fill_null("U")
                    .cast(pl.Categorical).alias("Deck")])
ablation("ticket_count", [pl.len().over("Ticket").alias("TicketCount")])pl.col("Name").str.extract(r",\s*([^\.]+)\.") | 正規表現で「, 」と「.」の間(敬称)を取り出す |
|---|---|
.replace({...}) | Mlle→Miss のように同じ意味の敬称をまとめる |
pl.col("Cabin").str.slice(0, 1) | 先頭の 1 文字(デッキ)を取り出す |
pl.len().over("Ticket") | 同じチケットの人数を数える |
結果
shape: (5, 2)
┌────────┬───────┐
│ Title  ┆ count │
│ ---    ┆ ---   │
│ str    ┆ u32   │
╞════════╪═══════╡
│ Mr     ┆ 517   │
│ Miss   ┆ 185   │
│ Mrs    ┆ 126   │
│ Master ┆ 40    │
│ Dr     ┆ 7     │
└────────┴───────┘
基準           | logloss 0.3994 | acc 0.8350
title        | logloss 0.4005 (+0.0011) | acc 0.8350 | 改善した Fold 2/5
family_size  | logloss 0.3976 (-0.0017) | acc 0.8361 | 改善した Fold 4/5
deck         | logloss 0.4065 (+0.0071) | acc 0.8328 | 改善した Fold 3/5
ticket_count | logloss 0.4001 (+0.0007) | acc 0.8260 | 改善した Fold 1/5
はっきり効いたのは family_size だけであった(logloss −0.0017、5 Fold 中 4 Fold で改善)。
敬称(title)は定番であるが、ここでは効かなかった。性別(Sex)・年齢(Age)・客室クラス(Pclass)がすでに入っていて、Mr / Mrs / Miss / Master の情報のほとんどはそこから木が作れるからである。deck は全体では悪化しているが 5 Fold 中 3 Fold では改善していて、判断が割れている。こういうときは採択しない。
定番の特徴量でも、すでにある列と情報が重なっていれば効かない。S6E8 の 4-4(total_weekly_screen)・4-5 と同じ結論である。
S6E8 に戻り、次の 4-8 ではカテゴリの列を目的変数の平均で数値にする Target Encoding を試す。
4-8カテゴリを目的変数の平均で数値にする(Target Encoding)
次にやること
4-6 では、欠損フラグも欠損数も効かないと分かった。S6E8 で残っているのは、カテゴリ列(gender、stress_level、academic_work_impact)の使い方である。次は、カテゴリ列を残したまま、目的変数の平均で数値にした列を足す Target Encoding を試す。
理由
全データで計算するとリークする:全データで一度に Target Encoding を計算すると、検証データの目的変数が特徴量に混ざるデータリーク(Data Leakage)が起きる。CV スコアは見かけ上上がるが、本番(LB)では同じスコアは出ない。
外側の Fold ごとに作り直す:よくある書き方は、全行の TE を「その行の Fold 以外」から先に計算してから CV に渡す方法である。しかしこの方法では、Fold 0 を検証するときの学習行の TE に、Fold 0 の正解が混ざる。検証側の答えが学習側の特徴量に入るので、小さなリークになる。そこで CV の Fold(外側)ごとに TE を作り直す。学習側の TE は学習側の中だけで内側の 5-Fold を回して作り、検証側の TE は学習側全体から作る。
提出まで同じ関数で通す:この形は、最後に test を変換するとき(train 全体から作った表で test を変換する)と同じ関係である。そこで「当てはめる側」を引数に取る関数 target_encode(df_fit, y_fit, df_apply, ...) にする。CV では (学習側, 検証側) を、提出では (train, test) を渡せば、同じ関数で済む。
スムージングで小さなカテゴリを抑える:件数が少ないカテゴリの平均は、たまたまの値に引っ張られる。(n * mean + m * prior) / (n + m) の式で、件数 n が少ないほど全体平均 prior に近づける。ここでは m に当たる smoothing を 10.0 にする。
見たことのない値は全体平均:集計に使った側に出てこなかった値が当てはめる側にあるときは、全体平均 prior で埋める(mapping.get(k, prior))。
効きにくいと予想できる:EDA(1-6)で、カテゴリごとの陽性率は 0.70〜0.72 とほぼ横ばいであった。Target Encoding しても新しい情報は少ないと予想できるが、正しい方法で実装して測る。
コード
# StratifiedKFold は 4-1 でインポート済み
def te_map(keys: pl.Series, target: np.ndarray, smoothing: float = 10.0):
    """カテゴリ → 平滑化した陽性率 の辞書と、全体平均を返す。"""
    prior = float(target.mean())
    stats = (
        pl.DataFrame({"k": keys, "y": target})
        .group_by("k")
        .agg(pl.len().alias("n"), pl.col("y").mean().alias("mean"))
        .with_columns(
            ((pl.col("n") * pl.col("mean") + smoothing * prior) / (pl.col("n") + smoothing)).alias("te")
        )
    )
    return dict(zip(stats["k"].to_list(), stats["te"].to_list())), prior

def encode(keys: pl.Series, mapping: dict[str, float], prior: float) -> np.ndarray:
    return np.array([mapping.get(k, prior) for k in keys.to_list()])

def target_encode(df_fit: pl.DataFrame, y_fit: np.ndarray, df_apply: pl.DataFrame,
                  cols: list[str], smoothing: float = 10.0, seed: int = 42):
    """df_fit の TE は内側 5-Fold の OOF で、df_apply の TE は df_fit 全体から作る。
    TE の列を足した df_fit と df_apply を返す。"""
    fit_te, apply_te = {}, {}
    inner = StratifiedKFold(n_splits=5, shuffle=True, random_state=seed)
    for c in cols:
        te = np.zeros(df_fit.height)
        for itr, iva in inner.split(np.zeros(len(y_fit)), y_fit):
            mapping, prior = te_map(df_fit[c][itr], y_fit[itr], smoothing)
            te[iva] = encode(df_fit[c][iva], mapping, prior)
        mapping, prior = te_map(df_fit[c], y_fit, smoothing)
        fit_te[f"{c}_te"] = te
        apply_te[f"{c}_te"] = encode(df_apply[c], mapping, prior)
    return df_fit.with_columns(**fit_te), df_apply.with_columns(**apply_te)

# 外側の Fold ごとに TE を作り直して CV する
oof_te = np.zeros(len(y))
fold_scores_te = []
for f in range(5):
    tr_mask, va_mask = folds != f, folds == f
    X_tr, X_va = target_encode(base_X.filter(tr_mask), y[tr_mask], base_X.filter(va_mask), cat_cols)
    model = LGBMClassifier(learning_rate=0.05, n_estimators=500, random_state=42, verbose=-1)
    model.fit(X_tr.to_pandas(), y[tr_mask], categorical_feature=cat_cols)
    oof_te[va_mask] = np.asarray(model.predict_proba(X_va.to_pandas()))[:, 1]
    fold_scores_te.append(roc_auc_score(y[va_mask], oof_te[va_mask]))

auc_te = roc_auc_score(y, oof_te)
n_better_te = int((np.array(fold_scores_te) > np.array(base_fold_scores)).sum())
diff_te, verdict_te = evaluate_change(auc_te, n_better_te, base_auc=base_auc)  # 4-3 と同じ相手と比べる
print(f"{'nested_target_encoding':<30} | OOF AUC: {auc_te:.6f} | diff: {diff_te:+.6f} | 改善 Fold {n_better_te}/5 | {verdict_te}")

# 提出するときは、train 全体から作った表で test を変換する(同じ関数)
_, X_test_te = target_encode(base_X, y, base_X_test, cat_cols)
print(X_test_te.select([f"{c}_te" for c in cat_cols]).head(3))df.group_by(c).agg(...) | 集計する側のデータだけで、目的変数の平均と件数をカテゴリごとに出す |
|---|---|
(n * mean + m * prior) / (n + m) | 件数の少ないカテゴリを全体平均に寄せるスムージング |
dict(zip(keys, values)) | 集計結果を「カテゴリ → TE 値」の辞書にする |
StratifiedKFold(5, ...).split(...) | 学習側の中をさらに 5 つに分ける(内側の Fold) |
df.with_columns(**{名前: 配列}) | 辞書で渡した配列を、キーの名前の列として足す |
結果
nested_target_encoding         | OOF AUC: 0.960446 | diff: +0.000067 | 改善 Fold 2/5 | [不採択] (ノイズフロア未満の微増 / 誤差)
shape: (3, 3)
┌───────────┬─────────────────┬─────────────────────────┐
│ gender_te ┆ stress_level_te ┆ academic_work_impact_te │
│ ---       ┆ ---             ┆ ---                     │
│ f64       ┆ f64             ┆ f64                     │
╞═══════════╪═════════════════╪═════════════════════════╡
│ 0.70102   ┆ 0.705663        ┆ 0.707883                │
│ 0.703838  ┆ 0.711431        ┆ 0.711029                │
│ 0.723198  ┆ 0.709001        ┆ 0.711029                │
└───────────┴─────────────────┴─────────────────────────┘
リークのない作り方では、ΔAUC は +0.000067 でノイズフロア(0.000163)に届かず、良くなった Fold も 2 つだけであった。test に付けた TE の値も 0.70〜0.72 に収まっていて、全体の陽性率 0.709 とほとんど変わらない。カテゴリ間で陽性率の差がほとんどないため、エンコードしても役に立つ情報は増えず、過学習のおそれだけが増える。Target Encoding は不採択とする。
次の 4-9 では、ここまでに採択した 2 つの特徴量を組み合わせ、選びすぎによる偏りがないかを確かめる。
4-9選びすぎに注意する(選択バイアス)
次にやること
4-4〜4-8 で試した特徴量のうち、採択したのは work_to_screen_ratio と non_leisure_screen の 2 つであった。次は、この 2 つを同時に足したときにスコアがどう動くかを確かめる。最後に、この章の実験をすべて 1 枚のグラフにまとめ、組み合わせたモデルが足した列を実際に使っているかを重要度で確かめる。
理由
選択バイアス(selection bias):何十個も特徴量を試すと、乱数の揺らぎだけで、意味のない特徴量でも偶然 OOF が +0.0002 近く上がることがある。上がったものを確かめずにすべて採用すると、OOF だけが良くなり、test(LB)ではスコアが下がる。これを選択バイアス(Selection Bias)と呼ぶ。多くの候補から OOF を見て選ぶと、選んだ結果の OOF は楽観的に偏る。
対策 1:仮説とノイズフロア:ドメインの仮説として筋が通っていて、ノイズフロア(0.000163)をはっきり超えるものだけを採択する。4-4〜4-8 ではこのルールで選んできた。
対策 2:組み合わせて確かめる:単体で採択した特徴量を組み合わせたときにも、スコアが上がるかを確かめる。互いに打ち消し合うなら、どちらかが偶然の改善だった疑いがある。
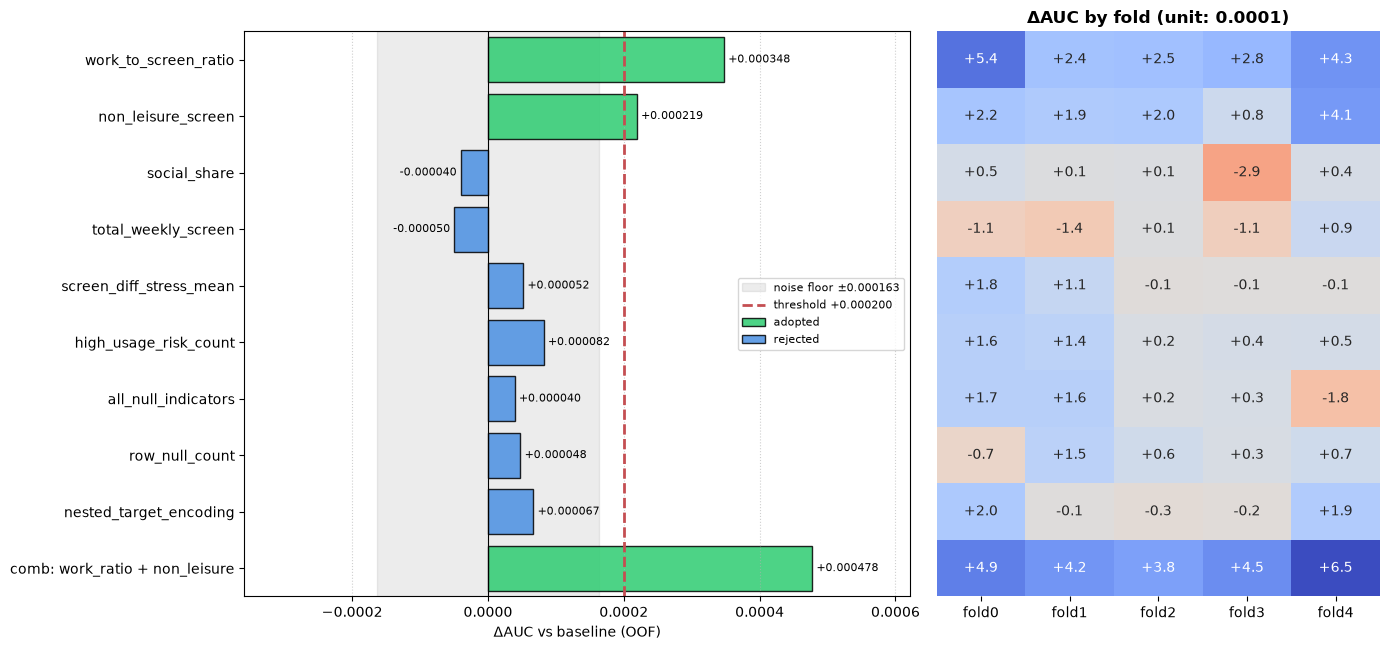
試したものを全部並べて見る:何個試して何個残したかを 1 枚で見ると、選んだものが「たまたま上に来た 1 個」なのか、閾値をはっきり超えているのかが分かる。左に全体の差(ΔAUC)を横棒で並べ、ノイズフロアの帯と閾値の線を引く。右には Fold ごとの差を色で並べ、4-2 の「5 Fold 中 4 Fold 以上で改善」を目で確かめる。棒の色は判定で、緑が採択、オレンジが保留、青が不採択である。
足した列が使われているか:スコアが上がっても、モデルが足した列をほとんど使っていなければ、上がったのは偶然の可能性がある。3-4 と同じ重要度(gain)を見て、足した 2 列が使われていることを確かめる。
コード
4-4 で作った ratio_feats から採択した 2 列を選んで足し、同じ run_ablation で評価する。
f_comb = base_X.hstack(ratio_feats.select(["work_to_screen_ratio", "non_leisure_screen"]))
auc_comb, diff_comb, verdict_comb, fold_scores_comb, imp_comb = run_ablation("comb: work_ratio + non_leisure", f_comb, y, folds)
print(f"Fold 別: {np.round(fold_scores_comb, 6)}")
次に、4-4〜4-9 の実験をすべて 1 枚にまとめる。
# 実験名 → run_ablation の戻り値(OOF AUC, 差分, 判定, Fold 別スコア, …)
_res = {
    **ratio_results, **agg_results, **null_results,
    "nested_target_encoding": (auc_te, diff_te, verdict_te, fold_scores_te),
    "comb: work_ratio + non_leisure": (auc_comb, diff_comb, verdict_comb, fold_scores_comb),
}
_names = list(_res)
_yy = np.arange(len(_names))
_diff = np.array([_res[_k][1] for _k in _names])
_fold_diff = np.array([np.array(_res[_k][3]) - np.array(base_fold_scores) for _k in _names])  # 実験 × Fold
_style = {"[採択]": ("adopted", "#2ECC71"), "[保留]": ("on hold", "#E67E22"), "[不採択]": ("rejected", "#4A90E2")}

_fig, (_ax1, _ax2) = plt.subplots(1, 2, figsize=(14, 0.5 * len(_names) + 1.6),
                                  gridspec_kw={"width_ratios": [3, 2]})
# 左: 全体の差。判定ごとに色を変えて描く
for _v, (_label, _color) in _style.items():
    _m = np.array([_res[_k][2].startswith(_v) for _k in _names])
    if _m.any():
        _bars = _ax1.barh(_yy[_m], _diff[_m], color=_color, alpha=0.85, edgecolor="black", label=_label)
        _ax1.bar_label(_bars, fmt="%+.6f", padding=3, fontsize=8)
_ax1.axvspan(-NOISE_FLOOR, NOISE_FLOOR, color="gray", alpha=0.15, zorder=0, label=f"noise floor ±{NOISE_FLOOR:.6f}")
_ax1.axvline(THRESHOLD, color="#C44E52", linestyle="--", linewidth=2, label=f"threshold +{THRESHOLD:.6f}")
_ax1.axvline(0, color="black", linewidth=0.8)
_ax1.set_xlim(min(_diff.min(), -NOISE_FLOOR) * 2.2, max(_diff.max(), THRESHOLD) * 1.3)   # 棒の先の数字が収まるように
_ax1.set_yticks(_yy, _names)
_ax1.set_ylim(len(_names) - 0.5, -0.5)   # 上から実験の順に並べる
_ax1.set_xlabel("ΔAUC vs baseline (OOF)")
_ax1.legend(loc="center right", fontsize=8)
_ax1.grid(axis="x", linestyle=":", alpha=0.6)
# 右: Fold ごとの差。単位は 0.0001(+2.8 なら +0.00028)
_lim = np.abs(_fold_diff).max()
sns.heatmap(_fold_diff * 1e4, ax=_ax2, cmap="coolwarm_r", vmin=-_lim * 1e4, vmax=_lim * 1e4,
            annot=True, fmt="+.1f", cbar=False, xticklabels=[f"fold{_i}" for _i in range(5)], yticklabels=False)
_ax2.set_title("ΔAUC by fold (unit: 0.0001)", fontweight="bold")
_fig.tight_layout()
_fig
最後に、組み合わせたモデルの重要度を、足した 2 列を緑にして並べる。
_order = np.argsort(imp_comb)   # 小さい順。barh は下から描くので、大きいものが上に来る
_cols = np.array(f_comb.columns)[_order]

_fig, _ax = plt.subplots(figsize=(7, 5))
_ax.barh(_cols, imp_comb[_order], color=["#2ECC71" if _c in ratio_feats.columns else "#4A90E2" for _c in _cols],
        alpha=0.85, edgecolor="black")
_ax.set_xlabel("gain (mean of 5 folds)")
_ax.set_title("feature importance (baseline 12 + 2 new features)", fontweight="bold")
_ax.grid(axis="x", linestyle=":", alpha=0.6)
_fig.tight_layout()
_figratio_feats.select([列名, ...]) | 4-4 で作った表から、採択した列だけを取り出す |
|---|---|
{**a, **b, ...} | 4-4〜4-6 で残した辞書を 1 つにつなぐ。4-8 と 4-9 の結果も同じ形の組にして足す |
verdict.startswith("[採択]") | 判定の文字列の先頭で、採択・保留・不採択を見分ける |
ax.bar_label(bars, fmt="%+.6f") | 棒の先に、符号つきの小数 6 桁で値を書く |
ax.axvspan(-a, a) / ax.axvline(x) | 縦方向の帯と線。ノイズフロアの帯と閾値の線に使う |
plt.subplots(1, 2, gridspec_kw={"width_ratios": [3, 2]}) | 左右 2 つの枠を、幅 3:2 で作る |
sns.heatmap(..., cmap="coolwarm_r", annot=True, fmt="+.1f") | Fold ごとの差を、良くなったら青・悪くなったら赤で塗り、値を書く(coolwarm の向きを _r で逆にしている) |
結果
comb: work_ratio + non_leisure | OOF AUC: 0.960856 | diff: +0.000478 | 改善 Fold 5/5 | [採択] (有意な改善: +0.000200 以上)
Fold 別: [0.959927 0.960561 0.961067 0.961794 0.960939]
2 つを同時に足すと、OOF AUC は 0.960856(ΔAUC +0.000478)になり、5 つの Fold すべてでベースラインより良くなった。単体の効果の和(0.000348 + 0.000219 = 0.000567)より少し小さい。2 列とも画面時間を材料にしているので効果の一部は重なっているが、打ち消し合ってはおらず、組み合わせても上がっている。この 2 列を加えたものを、この章で確定する特徴量セットにする。
- このグラフを使う理由
- この章では 9 つの実験を別々の節で行った。ばらばらの出力を 1 枚に並べると、何個試して何個残ったか、残ったものが閾値をはっきり超えたかが一度に見える(選択バイアスの確認)。4-2 の 2 つの条件(全体の差と、改善した Fold の数)を、左右の 2 枚で同時に確かめられる。
- 何を見るか
- 左では、閾値の点線を超えた棒と、ノイズフロアの帯の中に収まった棒。右では、採択した行が 5 Fold そろって青か。帯の中の実験は、青と赤が混ざっているはずである。
- 見方
- 左は 1 行が 1 つの実験で、横軸はベースラインとの OOF AUC の差(ΔAUC)。緑の棒が採択、オレンジの棒が保留、青の棒が不採択。灰色の帯がノイズフロア(±0.000163)、赤い点線が採択の閾値(+0.000200)である。右は同じ実験の Fold ごとの差で、単位は 0.0001、青が改善、赤が悪化。
図 4.2 の左で見ると、この章で試した 9 つの実験のうち、閾値の線を超えたのは採択した 2 つだけで、組み合わせ(最下段)はさらに右に伸びている。残りの 7 つは、すべてノイズフロアの帯の中に収まっている。
図 4.2 の右の Fold ごとの差を見ると、帯の中の実験の多くは、Fold によって青(改善)と赤(悪化)が混ざっている。たとえば all_null_indicators は fold0 で +1.7 だが fold4 で -1.8 である(単位 0.0001)。全体の差がたまたまプラスでも、それは揺れの範囲だと分かる。high_usage_risk_count のように 5 Fold そろって青のものもあるが、どの Fold も +0.2〜+1.6 と小さく、全体の差はノイズフロアに届かない。採択した work_to_screen_ratio は 5 Fold すべて青(+2.4〜+5.4)で、non_leisure_screen も 5 Fold すべて青(+0.8〜+4.1)、組み合わせも 5 Fold すべて青(+3.8〜+6.5)である。
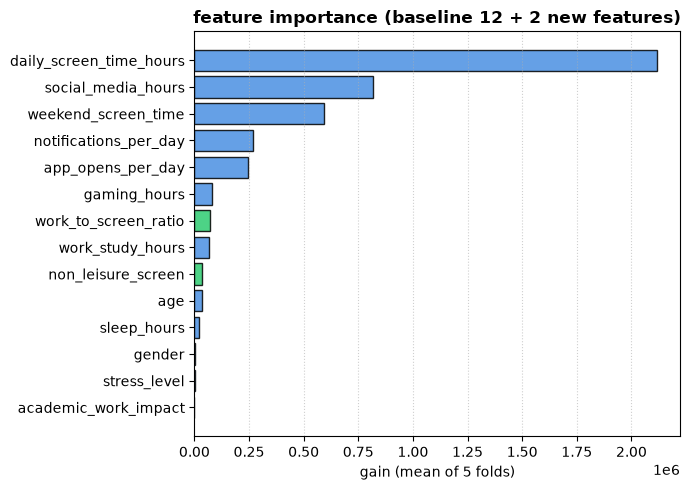
図 4.3 を見ると、足した 2 列は、14 列中 7 位(work_to_screen_ratio、gain 73,075)と 9 位(non_leisure_screen、35,891)で、モデルに使われている。上位の画面時間の 3 列には遠く及ばないが、work_to_screen_ratio は元の work_study_hours より上、non_leisure_screen は sleep_hours・age より上にある。また、work_study_hours の gain は 3-4 のベースライン(図 3.3、82,557)から 66,879 に約 2 割減った。work_study_hours で作っていた分岐の一部を、work_to_screen_ratio が引き受けたと読める。
次の 4-10 では、この特徴量セットを features_v1 として保存する。
4-10採択した特徴量を保存する
次にやること
4-9 で、2 つの特徴量を組み合わせた OOF AUC 0.960856 が確定した。次は、この特徴量セット(features_v1)を data/processed/ に Parquet 形式で保存する。
理由
毎回作り直さない:第5章のパラメータ探索や第6章のモデル比較では、何十回、何百回と学習を回す。そのたびに特徴量を作り直すと時間がかかるので、確定した特徴量行列を前処理済みデータとして保存する。
CSV ではなく Parquet:理由は 3 つである。① pl.Enum などのカテゴリ型の情報がそのまま保たれる、② 圧縮によりファイルサイズが約 1/5 になる(69 万行・17 列で約 14.6 MB)、③ 列ごとに保存する形式なので読み込みが非常に速い。
train と test に同じ処理をかける:採択した特徴量を作る処理を add_selected_features という関数にまとめ、train と test の両方に同じ関数をかける。作り方は 4-4 の ratio_exprs の式をそのまま使うので、評価した特徴量と保存する特徴量がずれることもない。保存したあとは読み直して中身が同じかを assert で確かめる。
id・目的変数・fold も一緒に保存する:第5章・第6章は、この Parquet を読み込んで学習する。特徴量だけを保存すると、目的変数と fold を folds.csv から取ってくることになり、「2 つのファイルの行の順番が同じ」という仮定に頼ることになる。4-1 で id を使って join したのと同じ理由で、行の順番には頼らない。train には id・目的変数・fold を、test には id を特徴量の左に付けて保存し、読み込む側で folds.csv と id・fold が一致するかを確かめる(5-1、6-1)。base_X は train_df から列を落として作ったものなので、行の順番は train_df と同じで、横につないでよいことが保証されている。
コード
SELECTED = ["work_to_screen_ratio", "non_leisure_screen"]

def add_selected_features(df: pl.DataFrame) -> pl.DataFrame:
    """採択した特徴量を足す。作り方は 4-4 の ratio_exprs をそのまま使う。"""
    return df.with_columns([ratio_exprs[name].alias(name) for name in SELECTED])

# 特徴量の左に、train は id・目的変数・fold を、test は id を付ける
feat_train = train_df.select(ID, TARGET, "fold").hstack(add_selected_features(base_X))
feat_test = test_df.select(ID).hstack(add_selected_features(base_X_test))

train_path = PROCESSED_DIR / "features_v1_train.parquet"
test_path = PROCESSED_DIR / "features_v1_test.parquet"

feat_train.write_parquet(train_path)
feat_test.write_parquet(test_path)

# 検証: 読み直した中身が、保存したものと同じか(equals は型を比べないので、schema も比べる)
for _path, _df in ((train_path, feat_train), (test_path, feat_test)):
    _back = pl.read_parquet(_path)
    assert _back.schema == _df.schema and _back.equals(_df), f"{_path.name} の中身が一致しません"

print(f"saved train: {train_path} ({train_path.stat().st_size / 1024 / 1024:.2f} MB, shape: {feat_train.shape})")
print(f"saved test : {test_path} ({test_path.stat().st_size / 1024 / 1024:.2f} MB, shape: {feat_test.shape})")
最後に、3-8 の実験記録 experiments.csv に、この章で確定した特徴量セットの結果を 1 行足す。
# 3-8 の実験記録に、採択した特徴量セットの結果を 1 行足す(3-8 と同じ書き方。ノートブックが違うので、もう一度書く)
_log_path = RESULTS_DIR / "experiments.csv"
_row = pl.DataFrame({
    "exp": ["04_features_v1"],
    "features": ["v1_14"],
    "model": ["lgbm"],
    "params": ["lr0.05_n500"],
    "cv_auc": [round(auc_comb, 6)],
    "cv_std": [round(float(np.std(fold_scores_comb)), 6)],
    "public_lb": [None],
    "note": ["4-9: baseline_12 + 2 features"],
})
if _log_path.exists():
    # 同じ実験名(exp)の行は置き換える。marimo がこのセルを再実行しても行は増えない
    _old = pl.read_csv(_log_path).filter(~pl.col("exp").is_in(_row["exp"].to_list()))
    _row = pl.concat([_old, _row], how="diagonal_relaxed")
_row.write_csv(_log_path)
print(_row)df.write_parquet(path) | 型情報を保持し高速・軽量に圧縮保存する |
|---|---|
pl.read_parquet(path) | 保存された Parquet ファイルを読み込んで検証する |
df.select(ID, TARGET, "fold").hstack(feats) | id・目的変数・fold の 3 列の右に特徴量をつなぐ(行数と行の順番が同じ表どうし) |
_back.schema == _df.schema and _back.equals(_df) | 読み直した表が、保存したものと同じかを確かめる。equals は列名と値を比べるが型(Enum かどうか)は比べないので、schema(列名と型)も比べる |
結果
saved train: D:\kaggle\smartphone-addiction_s6e8\data\processed\features_v1_train.parquet (14.56 MB, shape: (691369, 17))
saved test : D:\kaggle\smartphone-addiction_s6e8\data\processed\features_v1_test.parquet (6.67 MB, shape: (296302, 15))
train は 691,369 行・17 列で 14.56 MB、test は 296,302 行・15 列で 6.67 MB として保存できた。特徴量はベースラインの 12 列に採択した 2 列を加えた 14 列で、train にはその左に id・目的変数・fold の 3 列、test には id の 1 列が付いている。
┌────────────────┬─────────────┬───────┬─────────────┬──────────┬──────────┬───────────┬───────────────────────────────┐
│ exp            ┆ features    ┆ model ┆ params      ┆ cv_auc   ┆ cv_std   ┆ public_lb ┆ note                          │
╞════════════════╪═════════════╪═══════╪═════════════╪══════════╪══════════╪═══════════╪═══════════════════════════════╡
│ 03_baseline    ┆ baseline_12 ┆ lgbm  ┆ lr0.05_n500 ┆ 0.960379 ┆ 0.000631 ┆ null      ┆ 基準値                        │
│ 04_features_v1 ┆ v1_14       ┆ lgbm  ┆ lr0.05_n500 ┆ 0.960856 ┆ 0.000614 ┆ null      ┆ 4-9: baseline_12 + 2 features │
└────────────────┴─────────────┴───────┴─────────────┴──────────┴──────────┴───────────┴───────────────────────────────┘
実験記録は 2 行になった。3-8 のベースライン(0.960379)の下に、特徴量を 2 列足した 04_features_v1(0.960856)が並ぶ。Public LB の欄は、提出したときに埋める(7-7)。
この章で分かったことを、次の章への申し送りとしてまとめる。
1. 確定特徴量セット (features_v1):
   - ベースライン 12 列 + work_to_screen_ratio + non_leisure_screen = 合計 14 列
   - OOF ROC-AUC: 0.960856 (ベースライン 0.960379 から +0.000478 の有意な改善)
   - 保存先: data/processed/features_v1_train.parquet / test.parquet
2. 不採択となった特徴量とその教訓:
   - 欠損フラグ / 総欠損数: ランダム欠損のため予測シグナルがほぼなく、ノイズフロア未満(+0.000040 / +0.000048)
   - カテゴリ集約統計量: キーとなるカテゴリ列に情報量がないため、集約しても単なるノイズになる
   - 条件のカウント: 元の列の閾値の組み合わせなので、木は元の列から同じ分け方を作れる
   - Target Encoding: カテゴリ間の陽性率の差が微小(0.70〜0.72)なため、ノイズフロア未満(+0.000067)
3. 第5章 (ハイパーパラメータ探索) への方針:
   - features_v1 (14 列、OOF AUC 0.960856) を新しい基準値にしてパラメータを探索する
   - features_v1_train.parquet を直接読み込み、特徴量を作り直さずに学習を回す
次の第5章では、この features_v1(14 列、OOF AUC 0.960856)を新しい基準値にして、Optuna で LightGBM のパラメータを調整する。